提升测试中决策的一致性、质量与相关性
摘要
认证需要确保决策准确且一致,同时确保团队只将时间投入到真正有价值的问题上。简介
认证团队每年会做出数千项决策,以判定问题的严重性和不合规程度。 在一个既跨区域、又拥有多层内部评估(从一线测试人员到组长、经理和软件工程师)的业务中,做出一致的决策是一项挑战。 FMA 提供了一个严格的框架,使所有参与人员都能快速、一致地做出关键决策,同时通过标记那些被认为过于轻微而无需完整记录的问题,节省大量时间。概述
FMA 提供了一个为每个问题分配三种不同分数的框架:严重性、可能性和可重复性。这些分数的总和决定了问题属于以下哪种类型。- Condition for Resubmission (CFR): 这些问题严重到在开发者通过重新提交修复问题之前,游戏无法发布;或者该问题可以通过在特定时间范围内(通常是在最终用户开始交互的第一天之前)交付的内容更新来修复。
- Standard Reporting Issue (SRI): 这些问题较为严重,但其严重程度还不足以阻止该提交发布。
- Issue of Note (ION): 这些 SRI 问题无法直接映射到现有的测试用例。
- 严重性: 六种可能的结果
- 可能性: 六种可能的结果
- 可重复性: 六种可能的结果
FMA 的第一个构建基块:严重性
严重性使你能够在不考虑事件之外任何因素的情况下,界定问题的严重程度。 FMA 分析将不同的严重性级别分解为一个易于使用的层级结构。针对认证的需求,制定了以下严重性等级。
这六个可能的类别定义了每个问题,从无影响到影响极大。通过一次整体评级工作,为每个类别创建了加权评级。
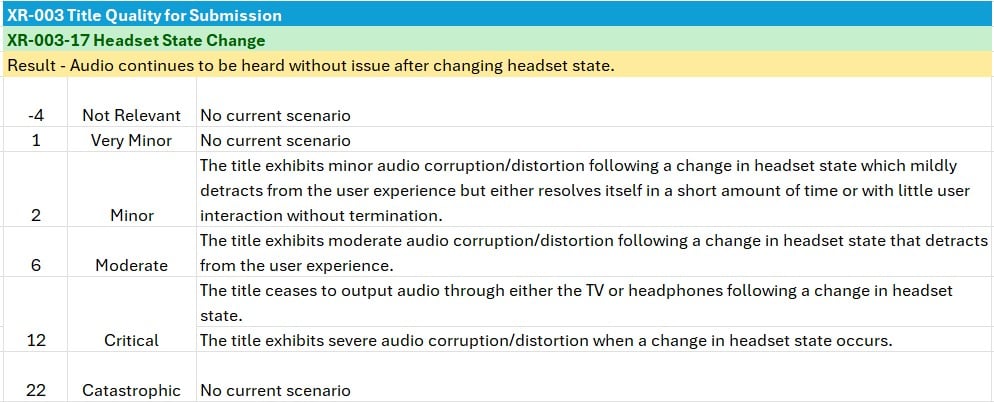
这些评级构成了框架中稳健的一部分,因为在多人之间一致地将问题分配到正确类别相对简单直接。我们没有止步于这种方法,而是选择按测试用例修改各个级别,从而创建一个高度易用、并能反映特定测试用例特点的系统。
一个示例是耳机状态更改(Headset State Change,HSC)。
图 1. HSC 示例。
FMA 的第二个构建基块:可能性
定义:可能性使我们能够评估最终用户可能接触到某个给定问题的可能性有多大。 我们使用与严重性类似的表格,但做了一些修改。
示例:
- 问题在启动游戏时发生。可能性 = 8。
- 问题在加入在线会话时发生。可能性 = 4。
- 问题仅在某个游戏模式中的一个特定子菜单内发生,在其他任何地方都不会发生。可能性 = -3。
FMA 的第三个构建基块:可重复性
定义:可重复性表示最终用户在问题首次出现后再次遇到该问题的可能性有多大。 我们已经介绍了两个值如何与问题的严重性和可能性相关。现在你需要确定问题的可重复性。 使用与严重性和可能性类似的表格,但做了一些修改。
与可能性一样,使用测试结果中的频率值,例如以下值:
频率:
主机 1:5/5
主机 2:4/5
要计算该值,请将成功重现的次数(第一个数字)相加,然后除以尝试总次数(第二个数字)之和。将此结果乘以 6 得到最终值。在本示例中,计算过程如下:9 ÷ 10 x 6 = 5.4,即最终的可重复性值为 5。
FMA 评分说明
正确使用这三个系统后,你会得到三个数字。将这些数字相加即可得到最终分数。 图 2. FMA 评分示例。