レガシー パイプライン
過去 20 年にわたり、グラフィックス パイプラインは進化を重ね、現在おなじみの姿に到達しました。独立系ハードウェア ベンダー (IHV) が、コア数、メモリ容量、帯域幅というますます広がる競争に注力する中で、ジオメトリ処理モデルにおける特定の固定機能によるボトルネックが顕在化してきました。 図 1. レガシー グラフィックス パイプライン。青色のステージは固定機能です。緑色のステージはプログラマブル シェーダーです。
メッシュ シェーダー パイプライン
メッシュ シェーダー パイプラインは、これらのレガシー グラフィックス パイプラインの制限を解決することを目的としています。まず、パイプラインから IA とテセレーターが削除されます。これは、シェーダー ウェーブの起動レートを最大化し、IA を GPU に応じてスケール可能なシェーダー コードへ移すことを目的としています。これにより、GPU コアを飽和させ、PA への負荷を維持しやすくなります。 このパイプラインはまた、パイプライン内のさまざまなポイントでワークロードをカリングする機能を提供します。増幅シェーダーは、グループ化されたオブジェクト、インスタンス、メッシュレット に対するような低粒度のカリングに使用できます。メッシュ シェーダーはプリミティブごとの粒度でカリングを行えます。これにより、簡単にカリング可能なプリミティブを早期かつ頻繁に破棄する経路が提供され、貴重な計算資源、メモリ帯域幅、PA スループットが節約されます。 図 2. メッシュ シェーダー パイプラインのステージ。緑色のステージはプログラマブルです。青色のステージは固定機能です。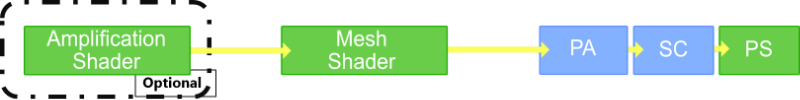
メッシュ シェーダー
メッシュ シェーダーは、コンピュート シェーダーにのみ見られるような汎用性のレベルをジオメトリ パイプラインにもたらすように設計されています。これにより、開発者は各スレッドのワークロードを完全に制御できるようになります。インデックスと頂点属性のフェッチをシェーダー コードに移すことで、固定機能ハードウェアへの依存が排除され、ウェーブの起動レートが最大化され、IA が GPU の他の部分と一緒にスケールできるようになります。 頂点数とプリミティブ数のエクスポート カウントを動的に指定する能力により、プリミティブ カリングのためのオンチップでの効率的なサポートへの扉が開かれます。これはメッシュ シェーダー内で、メッシュレット単位あるいはプリミティブ単位で、任意のカリング基準に対して実行できます。これにより、シェーダーは、複数レイヤーのカリングが既に行われた後のパイプライン末尾まで、頂点属性のフェッチとシェーディングを遅延できるようになります。増幅シェーダー
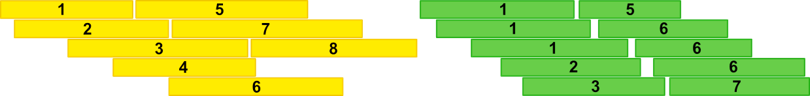
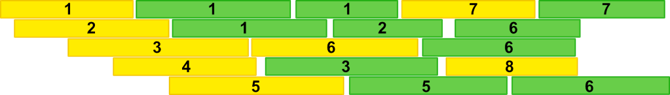
コンピュート シェーダーはリソースの前処理によく使用され、その結果を消費する ExecuteIndirect を使ったドロー コールが続くというパターンが一般的です。これは、さまざまな種類のビュー単位カリングでよく用いられる手法です。これには、適切なハードウェア サポートによって最適化できる、いくつかの微妙な欠点があります。 まず 1 つに、コンピュート シェーダーのインスタンスは、そのデータをグローバル メモリに書き込む必要があります。これによりフェッチのレイテンシーが発生し、GPU 全体のメモリ帯域幅の競合の対象となります。次に、コンピュート プロデューサーとグラフィックス コンシューマーが連続する操作である場合、GPU はコンシューマーとなるドロー コールを起動する前に、すべてのコンピュート シェーダー インスタンスがリタイアするのを待たなければなりません。これは、あらゆるシェーダーが最終的な UAV を消費する前に、その UAV へのすべてのコンピュート シェーダー書き込みが完了していることを保証しなければならないアンオーダード アクセス ビュー (UAV) リソース バリアが原因です。 図 3. コンピュート シェーダーに続けて直ちに ExecuteIndirect “DispatchMesh” ドローを行う場合の、簡略化されたウェーブ スケジューリングの可視化。コンピュート シェーダーのウェーブ (黄色) は、UAV バリアによるパイプライン ストールにより、メッシュ シェーダー ウェーブ (緑) の実行から分離されます。番号付きの ID は、呼び出し元のコンピュート シェーダー スレッドグループと、その子となるメッシュ シェーダーのクラスターとの対応を示します。