하드웨어
다양한 독립 하드웨어 공급업체(IHV)는 이기종 CPU 토폴로지를 서로 다르게 정의합니다. Intel과 Qualcomm은 Performance와 Efficiency라는 용어를 사용하고, AMD는 Performance와 Compact라는 용어를 사용합니다. 각 공급업체는 코어 토폴로지를 설계할 때 성능과 효율성 사이에서 절충합니다. 다음 예는 관련된 설계 선택 사항의 일부를 보여 줍니다.- 서로 다른 캐시 크기
- 코어마다 캐시 크기가 다를 수 있습니다.
- 예를 들어 성능 코어는 더 큰 L1 및 L2 캐시를 가질 수 있습니다.
- 캐시 공유
- 코어 간 캐시 공유 수준이 다양할 수 있습니다.
- 예를 들어 고성능 코어는 각각 전용 L2 캐시를 가지는 반면, 효율이 더 높은 코어는 단일 L2 캐시를 공유할 수 있습니다.
- SMT(동시 멀티스레딩) 지원
- 일부 코어는 SMT를 지원하지만 다른 코어는 지원하지 않을 수 있습니다.
- Intel은 SMT를 _Hyper-Threading_이라고 부릅니다.
- 내부 코어 레이아웃
- 코어 유형에 따라 내부 리소스가 다를 수 있습니다.
- 예를 들어 성능 코어에는 더 많은 부동 소수점 파이프, ALU 파이프 또는 더 넓은 데이터 레인이 포함될 수 있습니다.
- 최대 주파수
- 코어 유형 간 최대 주파수가 다를 수 있습니다.
- 예를 들어 성능 코어는 효율 코어보다 더 높은 주파수에 도달할 수 있습니다.
성능 수치
효율성 수준이 서로 다른 코어는 성능도 다를 것으로 예상됩니다. 한 코어는 성능을 위해 설계되었고 다른 코어는 전력 절약을 위해 설계되었습니다. 문제는 코어 간에 얼마나 차이가 나는가입니다. 표시된 데이터는 여러 IHV의 데이터를 종합한 것입니다. 각 IHV는 토폴로지에 대해 내린 선택에 따라 테스트별로 확장 정도가 다릅니다. 정확한 수치는 다르지만 패턴은 모든 IHV에서 비슷합니다. 또한 CPU 세대마다 서로 다른 절충을 하므로 상대적인 수치가 달라집니다. 기존의 모든 IHV와 세대에 걸친 수치를 산출하는 것은 이 문서의 범위를 벗어납니다.합성 테스트
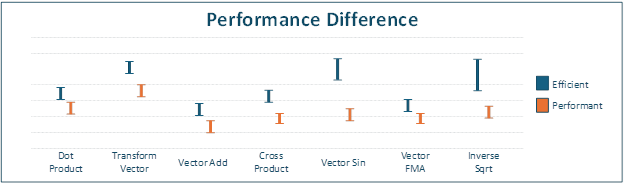
벡터 수학은 게임 타이틀이 한 프레임 내에서 수행하는 작업의 주요 부분입니다. 이 워크로드는 물리, AI, 렌더링 등 무엇이든 될 수 있습니다. 게임은 단일 128비트 SSE 레지스터에 들어가는 3개 또는 4개의 float로 구성된 벡터 유형을 사용하여 이 작업을 수행합니다. 이러한 작업은 내적, 행렬 곱셈, 제곱근 계산, 벡터 변환 등 광범위한 연산에 걸쳐 있습니다. 이러한 연산의 성능 차이는 전체 프레임 시간에 상당한 영향을 줄 수 있습니다. 다음 그래프는 일반적인 7가지 수학 연산을 수행하는 상대적 비용을 보여 줍니다. 측정에는 단일 128비트 SSE 레지스터에 저장된 4개의 32비트 부동 소수점 값으로 구성된 벡터를 사용합니다. 행렬은 4개의 벡터로 구성되며, 4개의 128비트 SSE 레지스터에 걸쳐 총 16개의 32비트 부동 소수점 값을 가집니다. 이러한 연산은 한 프레임 내에서 흔히 사용되므로 선택되었습니다.- 내적: 벡터의 내적을 계산합니다.
- 벡터 변환: 벡터에 행렬을 곱하여 벡터를 변환합니다.
- 벡터 덧셈: 두 벡터를 더합니다.
- 외적: 두 벡터의 외적을 계산합니다.
- 벡터 사인: 벡터의 각 요소에 대한 사인의 근삿값을 계산합니다.
- 벡터 FMA(융합 곱셈-덧셈): 두 벡터를 곱하고 세 번째 벡터를 더합니다.
- 역제곱근: 벡터 길이의 역제곱근을 계산합니다.
실제 환경
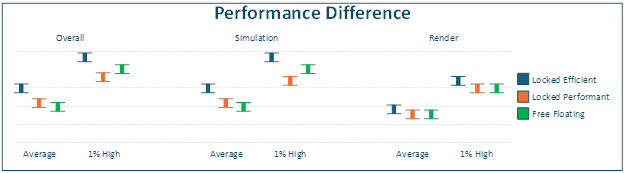
앞의 수치는 특정 벤치마크를 개별적으로 보여 주며, 전체 이야기의 일부만 알려 줍니다. 다음 수치는 두 개의 주 스레드(Simulation 및 Render)와 일련의 작업 스레드를 사용하는 AAA 게임 엔진의 벤치마크에서 나온 것입니다. 벤치마크는 세 가지 테스트 구성을 사용합니다.- 두 주 스레드가 고성능 코어에서만 실행됩니다.
- 두 주 스레드가 효율 코어에서만 실행됩니다.
- 두 주 스레드가 시스템의 모든 코어에서 실행됩니다.
각 제조업체는 하드웨어에 맞게 이러한 스케줄러 추론을 조정할 수 있습니다. 예를 들어 AMD에는 Workload Profile Scheduling이 있고 Intel에는 Thread Director 기술이 있습니다. 또한 각 IHV는 SoC의 특정 토폴로지에 맞게 추론을 조정하는 경향이 있습니다.
권장 사항
스레드 선호도
단일 효율성 클래스만 있는 데스크톱 컴퓨터에서 실행할 때의 스레드 선호도에 대한 권장 사항은 고정 스레드 선호도를 설정하지 말고 대신 스레드가 모든 코어에서 자유롭게 이동하도록 하는 것입니다. 이처럼 불확실한 주된 이유는 사용자의 컴퓨터에서 어떤 다른 프로세스가 실행될지 미리 알 수 없기 때문입니다. 고정 선호도가 있는 스레드가 시스템의 다른 높은 우선 순위 스레드와 코어를 공유하게 될 수 있습니다. 그 결과 타이틀 스레드는 실행 기회를 얻지 못하게 됩니다. 이러한 경합이 프레임에 중요한 스레드에서 발생하면 타이틀의 프레임 시간이 일정하지 않을 수 있습니다. OS가 타이틀 스레드를 계속 실행할 수 있도록 이동할 위치를 확보해야 합니다. 그러나 이기종 CPU에서 실행할 때는 이 권장 사항이 달라져야 합니다. 주된 이유는 OS가 타이틀의 스레드나 작업 중 어느 것이 프레임에 중요한지 반드시 알지는 못하기 때문입니다. OS에는 프레임에 중요한 스레드라고 판단하는 추론이 있지만, 이러한 추론은 여전히 잘못된 선택을 할 수 있습니다. OS가 이러한 스레드나 작업 중 하나를 성능이 더 낮은 코어로 이동하기로 결정하여 타이틀에서 성능 문제가 발생할 가능성이 높아질 수 있습니다. 권장 사항은 타이틀 스레드가 최소 3~4개의 코어에서 실행될 수 있도록 하는 것을 목표로 하며, 더 많을수록 좋습니다. 예를 들어 고성능 코어 1개와 저성능 코어 3개가 있는 저사양 시스템에서는 스레드가 모든 코어에서 자유롭게 이동하도록 허용해야 합니다. 성능 코어가 3개 이상인 컴퓨터에서는 프레임에 중요한 스레드를 해당 고성능 코어로만 제한할 수 있습니다. SMT도 지원하는 코어가 많은 고사양 컴퓨터에서는 일부 타이틀이 스레드를 물리적 코어에 고정하려고 할 수 있습니다. 이 기법은 여러 높은 우선 순위 스레드가 물리적 코어의 동일한 리소스를 공유할 때 물리적 코어 수준의 경합을 방지합니다. 하지만 일반적으로 이 경우는 고려하지 않는 것이 좋습니다. OS가 이미 시스템 전체에 이 동작을 적용하고 있습니다. OS는 먼저 물리적 코어에 스레드를 예약하고 필요한 경우에만 더 많은 논리적 코어를 사용합니다. 타이틀이 고려해야 하는 유일한 경우는 시스템에 타이틀의 중요 스레드를 지원할 만큼 충분한 고성능 코어가 있는 경우입니다. 이 경우 프레임에 중요한 스레드를 고성능 코어에 고정하는 것이 바람직할 수 있습니다. 그러나 이러한 스레드는 모든 고성능 코어에서 자유롭게 이동할 수 있어야 합니다. 경우에 따라 모든 스레드가 모든 코어에서 자유롭게 이동하도록 허용하면 성능이 향상될 수 있지만, 이 동작은 모든 CPU 제조업체에서 일관되지 않습니다. 타이틀이 모든 스레드에 걸쳐 워크로드의 균형을 완전히 맞출 수 있는 작업 가로채기 시스템을 구현하는 경우, 모든 작업 스레드는 모든 코어에서 자유롭게 이동할 수 있어야 합니다. 높은 우선 순위 작업 스레드인지 낮은 우선 순위 작업 스레드인지는 중요하지 않습니다. 작업 가로채기 알고리즘은 자동으로 부하의 균형을 맞추고 가장 짧은 시간에 가장 많은 작업을 완료할 수 있게 해 줍니다. 고성능 코어의 스레드는 프레임 동안 더 많은 작업을 실행합니다. 프레임에 중요한 스레드가 여러 개 있는 경우, 두 개의 프레임 중요 스레드가 동일한 코어에서 실행될 수 없도록 선호도를 설정하는 것이 유용할 수 있습니다. 예를 들어 프레임 중요 스레드가 두 개 있는 경우 서로 배타적 논리합(XOR)이 되도록 선호도를 설정하면 OS로 인해 스레드가 서로 경합할 가능성이 제거됩니다. 하지만 이 옵션은 각 프레임 중요 스레드가 최소 3~4개의 코어에서 자유롭게 이동할 수 있도록 하면서도 이 경우를 지원할 만큼 충분한 코어가 있는 경우에만 고려하세요.스레드 토폴로지
이기종 환경에서 스레드에 작업을 할당하는 방법을 고려할 때 주요 데이터는 다양한 작업의 길이와 작업 간의 상호 작용 방식입니다. 각 작업의 평균 길이는 얼마인지, 작업 간의 종속성은 무엇인지, 각 작업의 우선 순위는 무엇인지 등입니다. 작업 스레드가 중요 스레드나 작업에서 발생하는 시간 급증을 얼마나 흡수할 수 있습니까? 이러한 스레드나 작업 중 하나가 35% 느리게 실행되면 프레임 시간에 얼마나 영향을 줍니까? 예를 들어 작업이 오래 실행되면 이 지연이 프레임의 나머지 부분에 얼마나 영향을 주는지, 해당 작업이 완료될 때까지 시스템이 중단되는지 등입니다. 중요 스레드나 작업에 추가 오버헤드를 더하여 이기종 시스템이 프레임 시간에 얼마나 영향을 주는지 확인하는 것이 유용할 수 있습니다. 테스트로, 작업이나 작업 블록이 임의로 25%~35%의 추가 시간이 걸리도록 만듭니다. 전체 프레임 시간의 변화 정도는 작업 시스템이 실행 급증을 얼마나 잘 흡수할 수 있는지를 나타냅니다. 이상적인 상황은 프레임 시간에 거의 변화가 없는 것입니다. 이는 시스템이 프레임 시간의 임의 급증을 흡수할 수 있다는 의미입니다. 급증은 성능이 더 낮은 코어에서 실행되거나 시스템의 다른 임의 프로세스가 CPU 시간을 사용하는 데서 비롯됩니다.스레드 통신
잠금 기본 형식을 사용하는 스레드 통신에 대해서는 몇 가지 고려가 필요합니다. 컨텍스트 전환의 오버헤드는 새 스레드가 실행되기 전 수신 코어의 C-State와 밀접하게 연관되어 있습니다. 새 스레드가 실행을 시작하려면 코어가 실행 상태인 C0에 있어야 합니다. 비용이 가장 적은 경우는 코어가 이미 실행 중이어서 이미 C0에 있는 경우입니다. 그러나 코어가 유휴 상태이면 더 낮은 C-State에 있습니다. C-State의 수준은 더 깊은 절전 수준에 해당합니다. 더 깊은 절전 상태에서는 코어가 사용하는 전력이 줄어듭니다. 그러나 더 깊은 절전 상태에서 깨어나 다시 실행을 시작하는 데는 비용이 더 많이 듭니다. 가장 일반적인 저전력 C-state는 C1이며, 2작업 시스템
최상의 성능을 얻으려면 장기 실행되는 전용 프레임 중요 스레드에 의존하기보다는 작업을 중심으로 엔진을 구성하세요. 예를 들어 Simulation/Render 스레드 모델은 두 개의 영구적인 프레임 중요 스레드를 만듭니다. 그러나 긴 작업은 모든 작업 스레드가 프레임 중요 스레드처럼 동작하게 만들 수 있습니다. 작업에 10ms가 걸리면 해당 작업을 실행하는 스레드는 원래 역할과 관계없이 그 기간 동안 프레임에 중요한 스레드가 됩니다.작업 가로채기
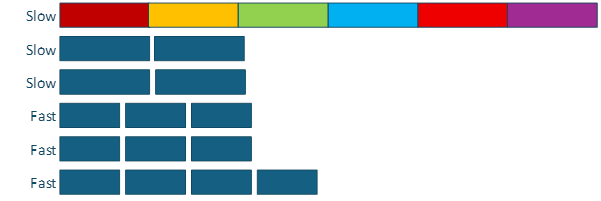
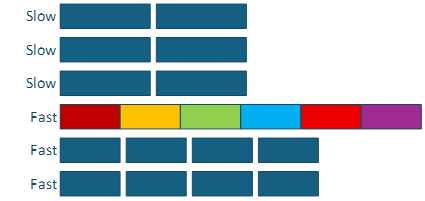
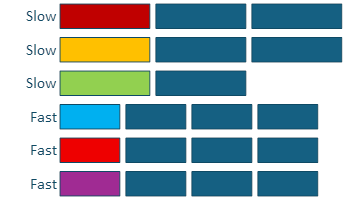
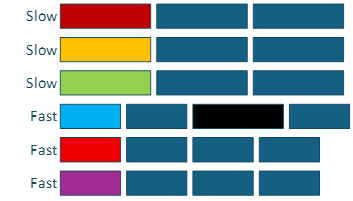
가장 중요한 권장 사항은 전체 작업 시스템에서 작업 가로채기를 사용하고 모든 프레임 중요 스레드가 작업 가로채기 알고리즘에 참여하도록 하는 것입니다. 예를 들어 렌더 스레드가 렌더링 관련 작업이 완료되기를 기다리고 있다면 해당 작업 중 일부를 실행해야 합니다. 이 동작은 이미 많은 게임 엔진에서 일반적인 관행입니다. 그러나 이러한 유형의 동작은 게임 엔진이 이기종 코어 및 가능한 OS 선점으로 인한 프레임 급증을 흡수하는 데 매우 중요하므로 여기서 언급할 가치가 있습니다. 작업 실행 시간이 길어지면 프레임 시간 급증의 위험이 커집니다. 이 동작은 작업이 성능이 더 낮은 코어에서 실행되거나 PC 내의 다른 작업으로 인해 발생할 수 있습니다. 권장 사항은 엔진이 작업 하나가 프레임의 약 2%를 차지하도록 목표로 하는 것입니다. 예를 들어 이 예산은 60fps로 실행되는 게임의 경우 약 333μs 이하를 의미합니다. 필요한 경우 2% 수치를 목표로 하기 위해 여러 개의 작은 작업을 하나의 큰 작업으로 일괄 처리해야 합니다. 이 방법은 작업 크기, 스레드 통신 및 급증 흡수 능력 간에 좋은 절충을 제공합니다. 다음 예는 긴 프레임 중요 작업이 시스템 성능에 미칠 수 있는 영향을 보여 줍니다. 이 예에서 각 작업은 동일한 수의 연산으로 구성됩니다. 이 예에서는 느린 코어에서 375μs, 빠른 코어에서 250μs가 걸리는 단일 작업이 있습니다. 가장 긴 작업(long pole)은 다른 작업보다 6배 더 비쌉니다. 최악의 상황은 가장 긴 작업이 느린 코어 중 하나에 배치되는 경우입니다. 이는 프레임 시간에 큰 영향을 줄 수 있습니다. 이 시나리오에서 작업을 실행하는 총 시간은 375μs의 6배인 2,250μs입니다. 그림 3: 느린 코어에서 실행되는 가장 긴 작업의 예.