O pipeline legado
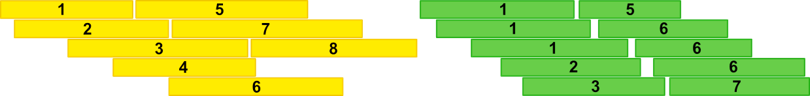
Nos últimos 20 anos, o pipeline gráfico evoluiu até chegar ao estado hoje familiar. À medida que os fornecedores independentes de hardware (IHVs) se concentram em uma disputa cada vez mais ampla por contagem de núcleos, capacidade de memória e largura de banda, certos gargalos de função fixa se tornaram evidentes no modelo de processamento geométrico. Figura 1. O pipeline gráfico legado. Os estágios em azul são de função fixa. Os estágios em verde são shaders programáveis.
O pipeline de Mesh Shader
O pipeline de Mesh Shader trata dessas limitações do pipeline gráfico legado. Em primeiro lugar, ele remove o IA e o tessellator do pipeline. A intenção é maximizar a taxa de lançamento de waves de shader e transferir o IA para o código de shader, que pode escalar com as GPUs. Isso pode ajudar a saturar os núcleos da GPU e manter a pressão sobre o PA. Esse pipeline também oferece a capacidade de fazer culling de cargas de trabalho em vários pontos do pipeline. Os Amplification Shaders podem ser usados para culling de baixa granularidade, como em relação a objetos agrupados, instâncias ou meshlets. Os Mesh Shaders podem fazer culling com granularidade por primitivo. Isso fornece um caminho para descartar primitivos trivialmente descartáveis cedo e com frequência, economizando computação, largura de banda de memória e taxa de transferência do PA preciosas. Figura 2. Os estágios do pipeline de Mesh Shader. Os estágios em verde são programáveis. Os estágios em azul são de função fixa.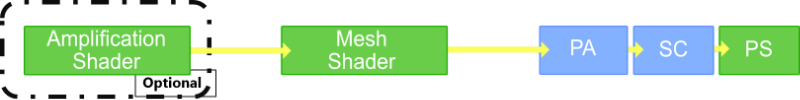
Mesh Shaders
Os Mesh Shaders foram projetados para oferecer ao pipeline de geometria um nível de generalidade encontrado apenas em compute shaders. Isso dá ao desenvolvedor controle total sobre a carga de trabalho de cada thread. Mover as buscas de índices e atributos de vértices para o código de shader remove a dependência de hardware de função fixa, maximizando as taxas de lançamento de waves e permitindo que o IA escale com o restante da GPU. A capacidade deles de especificar dinamicamente as contagens de exportação de vértices e primitivos abre caminho para um suporte eficiente e on-chip ao culling de primitivos. Isso pode ser feito por meshlet ou por primitivo, em relação a qualquer critério de culling arbitrário dentro do Mesh Shader. Isso permite que os shaders adiem as buscas e o sombreamento de atributos de vértices até o final do pipeline, depois que várias camadas de culling já tiverem sido realizadas.Amplification Shaders
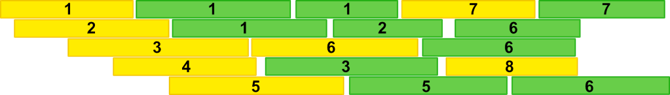
Os compute shaders são usados regularmente para pré-processar recursos, seguidos por chamadas de desenho que consomem seus resultados usando ExecuteIndirect. Essa é uma técnica comum para muitas formas de culling por visão. Ela tem algumas desvantagens sutis que poderiam ser otimizadas com o suporte de hardware adequado. Em primeiro lugar, as instâncias de compute shader devem gravar seus dados na memória global. Isso gera latência de busca e as sujeita à contenção de largura de banda de memória em toda a GPU. Em segundo lugar, se o produtor de computação e o consumidor gráfico forem operações consecutivas, a GPU deverá aguardar a conclusão de todas as instâncias de compute shader antes de lançar as chamadas de desenho consumidoras. Isso é causado por uma barreira de recurso de unordered access view (UAV), que deve garantir que todas as gravações do compute shader na UAV final sejam concluídas antes que qualquer shader possa consumi-la. Figura 3. Visualização simplificada do agendamento de waves de um compute shader seguido imediatamente de um desenho ExecuteIndirect “DispatchMesh”. As waves de compute shader (amarelo) são separadas da execução das waves de Mesh Shader (verde) por uma paralisação do pipeline devido a uma barreira UAV. Os IDs numerados relacionam o grupo de threads de compute shader que fez a invocação ao seu cluster de Mesh Shaders filhos.