Le pipeline hérité
Au cours des 20 dernières années, le pipeline graphique a évolué pour atteindre l’état familier qu’on lui connaît aujourd’hui. Alors que les fabricants de matériel indépendants (IHV) se livrent une bataille toujours plus large sur le nombre de cœurs, la capacité mémoire et la bande passante, certains goulots d’étranglement à fonction fixe sont devenus évidents dans le modèle de traitement géométrique. Figure 1. Le pipeline graphique hérité. Les étapes teintées de bleu sont à fonction fixe. Les étapes teintées de vert sont des nuanceurs programmables.
Le pipeline de nuanceurs de maillage
Le pipeline de nuanceurs de maillage cible ces limites du pipeline graphique hérité. Tout d’abord, il retire l’IA et l’unité de tessellation du pipeline. L’objectif est de maximiser le débit de lancement des vagues de nuanceur et de transférer l’IA vers du code de nuanceur pouvant évoluer avec les GPU. Cela peut aider à saturer les cœurs du GPU et à maintenir la pression sur le PA. Ce pipeline offre également la possibilité d’éliminer des charges de travail à divers points du pipeline. Les nuanceurs d’amplification peuvent servir à effectuer une élimination à faible granularité, par exemple sur des groupes d’objets, des instances ou des meshlets. Les nuanceurs de maillage peuvent effectuer une élimination à la granularité de chaque primitive. Cela permet de rejeter tôt et souvent les primitives facilement éliminables, ce qui économise de précieuses ressources de calcul, de la bande passante mémoire et du débit du PA. Figure 2. Les étapes du pipeline de nuanceurs de maillage. Les étapes teintées de vert sont programmables. Les étapes teintées de bleu sont à fonction fixe.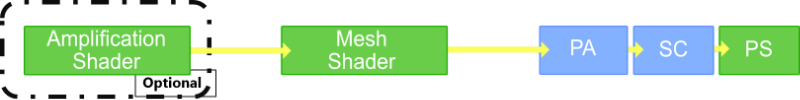
Nuanceurs de maillage
Les nuanceurs de maillage ont été conçus pour offrir au pipeline de géométrie un niveau de généralité qu’on ne trouvait que dans les nuanceurs de calcul. Le développeur dispose ainsi d’un contrôle total sur la charge de travail de chaque thread. Le déplacement des lectures d’index et d’attributs de sommets vers le code du nuanceur supprime la dépendance au matériel à fonction fixe, ce qui maximise les débits de lancement des vagues et permet à l’IA d’évoluer avec le reste du GPU. Leur capacité à spécifier dynamiquement le nombre de sommets et de primitives exportés ouvre la voie à une prise en charge efficace et sur puce de l’élimination des primitives. Celle-ci peut être effectuée par meshlet ou par primitive selon n’importe quel critère d’élimination arbitraire à l’intérieur du nuanceur de maillage. Cela permet aux nuanceurs de reporter la lecture et l’ombrage des attributs de sommets jusqu’à la fin du pipeline, après que plusieurs couches d’élimination ont déjà été effectuées.Nuanceurs d’amplification
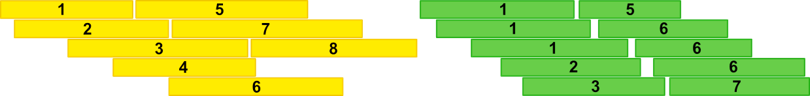
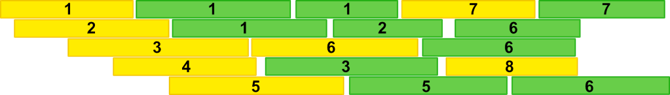
Les nuanceurs de calcul sont régulièrement utilisés pour prétraiter des ressources, suivis d’appels de dessin qui consomment leurs résultats à l’aide d’ExecuteIndirect. Il s’agit d’une technique courante pour de nombreuses formes d’élimination par vue. Elle présente toutefois quelques inconvénients subtils qui pourraient être optimisés avec une prise en charge matérielle adéquate. D’une part, les instances de nuanceur de calcul doivent écrire leurs données en mémoire globale. Cela entraîne une latence de lecture et les soumet à la contention de bande passante mémoire à l’échelle du GPU. D’autre part, si le producteur de calcul et le consommateur graphique sont des opérations consécutives, le GPU doit attendre que toutes les instances de nuanceur de calcul soient terminées avant de lancer les appels de dessin consommateurs. Cela est causé par une barrière de ressource de vue d’accès non ordonné (UAV) qui doit garantir que toutes les écritures des nuanceurs de calcul dans l’UAV final sont terminées avant qu’un nuanceur puisse la consommer. Figure 3. Visualisation simplifiée de l’ordonnancement des vagues d’un nuanceur de calcul suivi immédiatement d’un dessin ExecuteIndirect « DispatchMesh ». Les vagues du nuanceur de calcul (en jaune) sont séparées de l’exécution des vagues du nuanceur de maillage (en vert) par un blocage du pipeline en raison d’une barrière UAV. Les ID numérotés associent le groupe de threads du nuanceur de calcul appelant à sa grappe d’enfants de nuanceur de maillage.