Nuanceurs de maillage
Les nuanceurs de maillage (MS) sont essentiellement des nuanceurs de calcul dotés de fonctions intrinsèques propres à l’étape pour exporter des sommets, des index et des données de primitives vers l’assembleur de primitives. Toutes les données doivent être lues explicitement à partir de vues de mémoire tampon constante (CBV) et de vues de ressource de nuanceur (SRV) dans le code du nuanceur. Cela signifie que les développeurs devront adapter leur conception des appels de dessin pour mieux correspondre au flux de travail des nuanceurs de calcul. L’auteur du nuanceur détermine la taille du groupe de threads et la façon dont chaque thread est utilisé pour accomplir la charge de travail. Il a accès aux fonctions intrinsèques de vague de nuanceur et à la mémoire groupshared pour partager des données et générer efficacement une liste de primitives pour la rastérisation. Figure 2. Visualisation du travail GPU réparti par un appel DispatchMesh(4, 1, 1) avec un pipeline lié comportant uniquement un nuanceur de maillage. Comme pour les nuanceurs de calcul, DispatchMesh exige un nombre de groupes de threads dans les dimensions x, y et z. Cela répartit le nombre spécifié de groupes de threads de nuanceur de maillage pour exécution.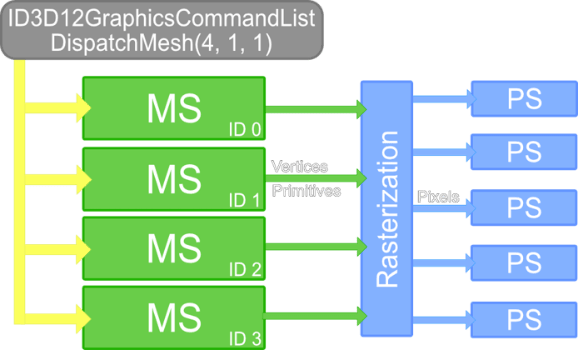
Nuanceurs d’amplification
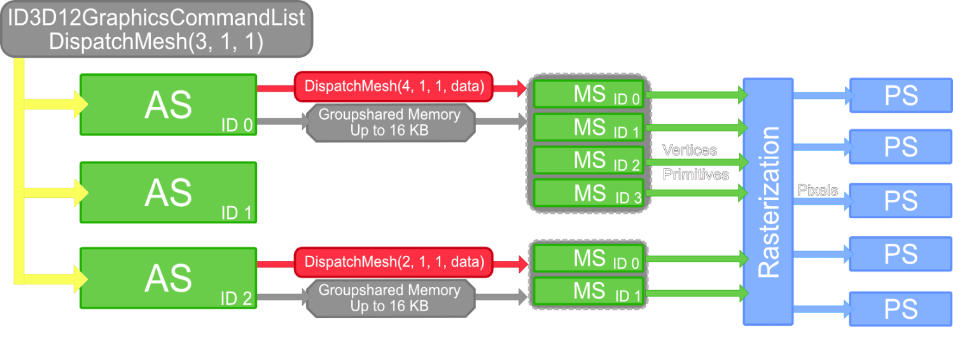
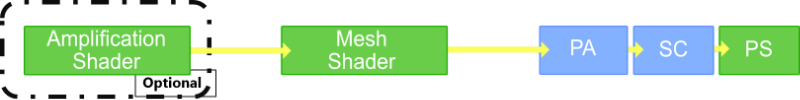
Le nuanceur d’amplification (AS) est une étape facultative qui précède l’étape du nuanceur de maillage. Cette étape s’apparente aussi à un nuanceur de calcul et peut répartir dynamiquement une grappe de groupes de threads de nuanceur de maillage. Chaque groupe de threads calcule son propre nombre de groupes de threads de nuanceur de maillage à répartir. Chaque groupe de threads comporte également jusqu’à 16 Ko de données de charge utile personnalisées et partagées à transmettre aux groupes de threads de nuanceur de maillage qu’il génère. Ces données peuvent être exportées directement à partir de la mémoire groupshared. Les fonctionnalités des nuanceurs d’amplification permettent aux programmes de nuanceurs de réduire ou d’amplifier dynamiquement leur charge de travail selon des critères personnalisés. Cela ouvre la voie à une élimination efficace à granularité plus fine ou à une tessellation personnalisée. Figure 3. Visualisation de la répartition d’un objet d’état de pipeline (PS) AS-MS. Certains groupes de threads AS choisiront de répartir des groupes de threads MS. D’autres pourraient n’en répartir aucun.