
Introdução
O Scalable Hardware Audio Processing Engine (SHAPE) fornece aceleração de hardware para vários dos blocos de construção mais comuns de reprodução e manipulação de áudio. Um título tem controle total sobre a configuração e a ordenação dos blocos de processamento do SHAPE, que são gerenciados pelo Audio Control Processor (ACP). O ACP é um componente de hardware. O título cria caminhos definidos para encadear um ou mais componentes do SHAPE da entrada até a saída. Esses caminhos são conhecidos como flowgraphs. Depois de criado, cada flowgraph é enviado como uma série de comandos para o ACP processar. Este tópico discute as práticas recomendadas para criar e enviar flowgraphs que implementem com êxito os cenários de runtime que você encontrará com mais frequência, bem como as configurações que você deve evitar para maximizar o desempenho. Este tópico aborda o seguinte:- Componentes e recursos do SHAPE
- Cenários sem bom desempenho e casos patológicos
- Planejamento e revisão de flowgraphs do SHAPE
- Flowgraphs persistentes versus não persistentes
- Depuração de problemas do SHAPE
Componentes e recursos do SHAPE
As filas de comandos são gerenciadas e preenchidas automaticamente pelo ACP quando os flowgraphs são enviados ao hardware. A tabela a seguir mostra uma lista consolidada de componentes e seus recursos de instanciação.
A tabela a seguir mostra uma lista consolidada de componentes e suas regras de roteamento de mix buffers.
| Componente do SHAPE| Mix buffers de entrada por instância| Mix buffers de saída por instância|
| --- | --- | --- | --- | --- | --- | --- | --- | --- |
| XMA| Não aplicável. Lê da memória.| Não aplicável. Decodifica para a memória, normalmente consumido pelo SRC.|
| SRC| 0; lê da memória.| 1 para mono, 2 para estéreo.|
| FLT/VOL| 1.| 1.|
| EQ/CMP| 1 (ou 2, para configurações de sidechain).| 1.|
| MB| Não aplicável. Mix buffers não podem ler diretamente de outros mix buffers.| Não aplicável. Mix buffers não podem gravar diretamente em outros mix buffers.|
| DMA| 1; até 32 quadros de áudio por transferência.| 1; até 32 quadros de áudio por transferência.|
Para obter mais detalhes sobre os blocos de construção do SHAPE, consulte a palestra relacionada da Xfest The Sound of XBOX One (Conference Material > Xfest 2012) e o white paper The Sound of the Future (Developer Education Materials > All NDA Whitepapers).
Uma observação sobre cenários de uso de flowgraphs
Muitos títulos talvez nunca implementem flowgraphs diretamente. O XAudio2 implementa implicitamente componentes do SHAPE, e o middleware de áudio pode abstrair os flowgraphs de hardware dos desenvolvedores de títulos. No entanto, construir flowgraphs permite que você aproveite diretamente os recursos de aceleração de áudio do console XBOX One, especificamente se você estiver desenvolvendo e implementando sua própria solução de renderização de áudio ou se tiver uma configuração personalizada que não tenha suporte do XAudio2 ou do middleware. Para todos os títulos que você desenvolver, será útil entender os recursos do SHAPE, que são discutidos mais adiante neste tópico, e planejar com antecedência as possíveis topologias de flowgraph.Cenários sem bom desempenho e casos patológicos
As seções a seguir descrevem cenários comuns que podem causar problemas de desempenho. As seções também fornecem recomendações para evitar esses problemas.Flowgraphs malformados
Você pode criar flowgraphs que constroem fluxos de sinal impossíveis ou dados que nunca são realizados na saída. Estes são alguns dos erros mais comuns que ocorrem na criação de flowgraphs.- Referências a objetos do SHAPE que não foram criados ou alocados
- Comandos ou parâmetros inválidos
- Precisão da contagem de referências de entrada/saída de mix buffers
- Realocação de uma ID virtual de mix buffer existente
- Omissão de mix buffers de conexão entre componentes do SHAPE
- Uso de mais de um único mix buffer como saída para um componente do SHAPE, com exceção do bloco SRC, que pode rotear para dois mix buffers ao renderizar conteúdo estéreo
- Referências circulares em mix buffers Um mix buffer não ficará disponível até que todas as suas entradas sejam apresentadas e as saídas sejam consumidas. Se houver uma referência circular em um mix buffer, o mix buffer terá efetivamente entradas infinitas, nunca ficará disponível e travará o grafo.
- Mix buffers órfãos Um mix buffer sem saídas ficará disponível imediatamente quando sua última entrada for processada. Um mix buffer destinado à renderização para um dispositivo de áudio (por exemplo, alto-falantes ou um headset) deve ser encerrado com um bloco de saída DMA. Isso apresentará o mix buffer à memória principal para a mixagem final.
Ordenação de comandos
O ACP preenche automaticamente as filas de comandos de cada componente do SHAPE. Ao preencher as filas, o ACP ignora os comandos subsequentes de um componente específico até que as entradas do componente estejam livres. Em geral, ignorar comandos representa uma penalidade de desempenho insignificante. No entanto, com base na ordenação de comandos, os títulos podem criar uma ordenação subótima de componentes do SHAPE. Isso faria com que uma ou mais filas em um estado não cheio aguardassem outras filas. Essa espera reduz o número de instâncias disponíveis por quadro. A figura 1 demonstra como a ordenação de comandos pode afetar o desempenho. Como prática recomendada, emita comandos FLT/VOL de cima para baixo, conforme mostrado no flowgraph, em vez de da esquerda para a direita, o que permite que mais vozes sejam concluídas. Esse método permite que um EQ/CMP, mostrado na parte inferior do flowgraph, seja processado em paralelo. Figura 1. Um flowgraph que mostra como emitir comandos FLT/VOL de cima para baixo, em vez de da esquerda para a direita, para permitir que um EQ/CMP seja processado em paralelo e melhorar o desempenho.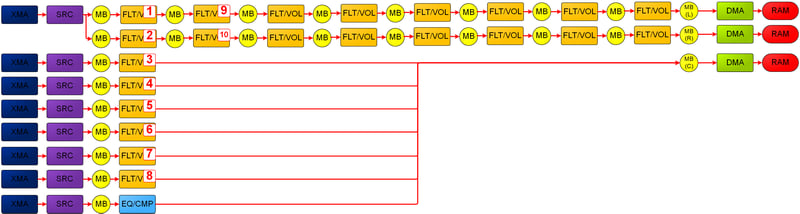
Alocação de instâncias de mix buffer
Os mix buffers ficam bloqueados enquanto estão sendo gravados. Nenhuma saída pode ser lida deles até que todas as entradas tenham contribuído para a mixagem. Do ponto de vista da implementação, os mix buffers usam os camposnumIn e numOut para gerenciar isso. Portanto, é possível construir cenários que exigem mais de 128 mix buffers físicos ao mesmo tempo.
O SHAPE virtualiza os mix buffers de forma que, mesmo com alta polifonia, esse cenário normalmente não cause problemas. No entanto, você pode construir flowgraphs que exigem que um grande número de mix buffers seja acessado simultaneamente. Em particular, os mix buffers que estão fazendo submixagem ou masterização entre várias vozes ficam bloqueados até que a última voz seja mixada neles e até que a última saída dos mix buffers seja consumida por um bloco do SHAPE subsequente.
Em um cenário típico (uma única voz de masterização 7.1 na qual todas as vozes do SHAPE são mixadas), 8 das 128 vozes ficam bloqueadas durante todo o quadro. Mix buffers adicionais podem ficar bloqueados durante uma parte significativa do quadro (reduzindo a capacidade dos mix buffers virtuais) se houver submixagem multicanal extensa com cadeias de dependência de flowgraph. Como alternativa, vozes de masterização adicionais são criadas se, por exemplo, você criar tanto uma mixagem para alto-falante principal quanto uma mixagem de headset 7.1 por jogador para um título de quatro jogadores, o que pode consumir 40 mix buffers simultâneos.
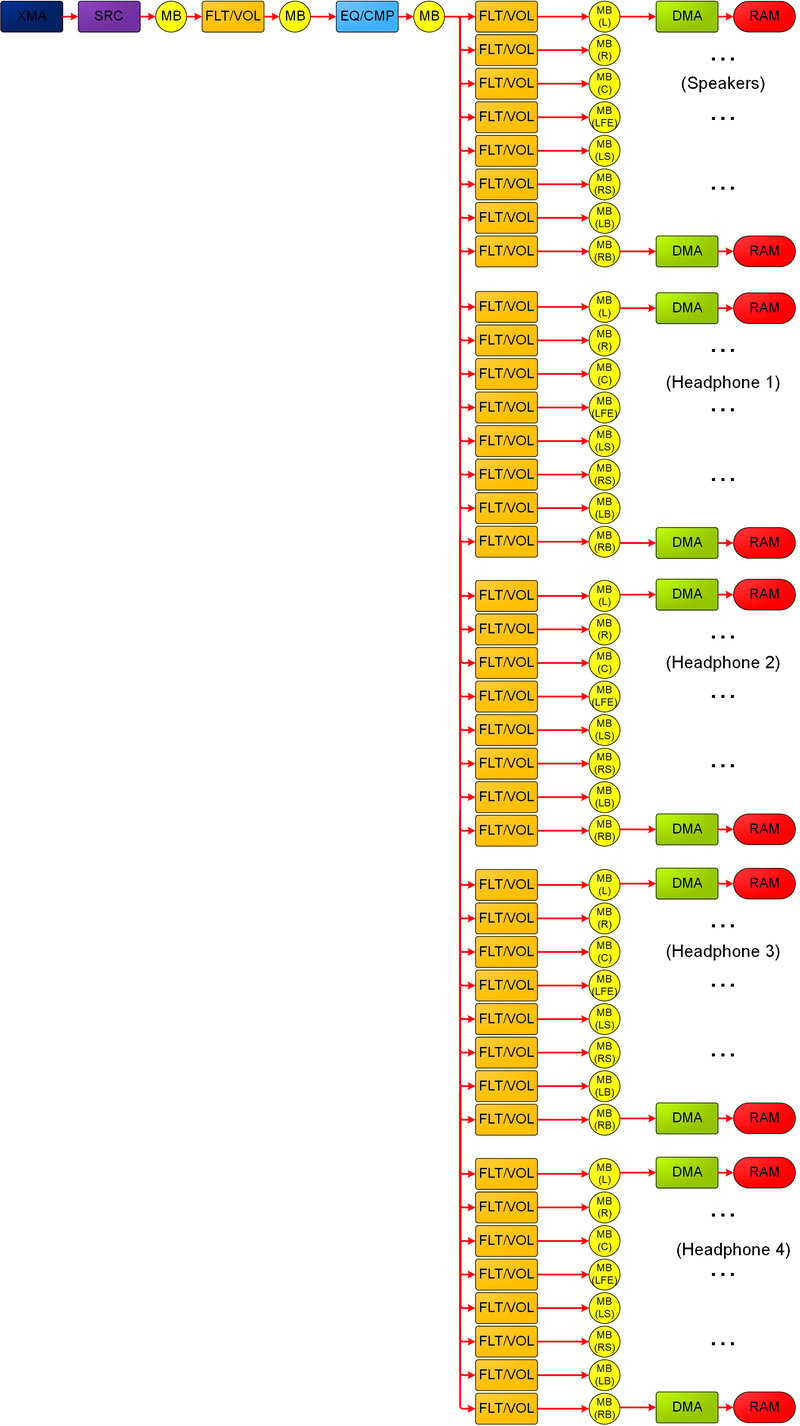
Em geral, um caso que exige mais de 128 mix buffers físicos simultâneos é patológico. No entanto, mix buffers bloqueados desnecessariamente, durante todo o quadro, reduzem a capacidade do seu título de atingir a taxa de transferência potencial. A figura 2 representa uma submixagem desnecessária que pode reduzir o número de mix buffers disponíveis em um determinado momento.
Dependendo da ordenação de comandos (figura 2), os 5 mix buffers de masterização 7.1 separados podem ficar bloqueados durante quase todo o quadro, o que representa 40 dos 128 mix buffers físicos. Embora esse caminho exija que apenas 2 outros mix buffers estejam em uso ao mesmo tempo (ou seja, a entrada e a saída emparelhadas de um FLT/VOL ou EQ/CMP), considere processar primeiro todos os mix buffers que vão para os alto-falantes. Em seguida, você pode liberar esses mix buffers e processar os headsets 1, 2 e assim por diante.
Figura 2. Um flowgraph que mostra submixagem desnecessária e bloqueio de instâncias de mix buffer alocadas devido à ordenação inadequada de comandos.
Seleção e balanceamento de componentes do SHAPE (FLT/VOL vs. EQ/CMP)
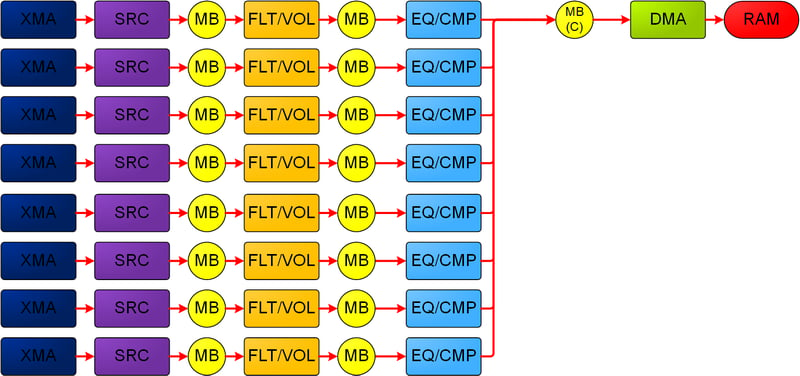
Se você usar os mesmos componentes do SHAPE repetidamente em sequência, poderá reduzir a capacidade de atingir a taxa de transferência máxima. Por outro lado, ao alternar componentes diferentes, você garante que cada bloco do SHAPE esteja fazendo um processamento paralelo significativo. A figura 3 mostra um exemplo comum: nem todos os FLT/VOLs podem ser processados em paralelo. O desempenho pode ser prejudicado. Figura 3. Um flowgraph que mostra uma tentativa de processar todos os FLT/VOLs em paralelo.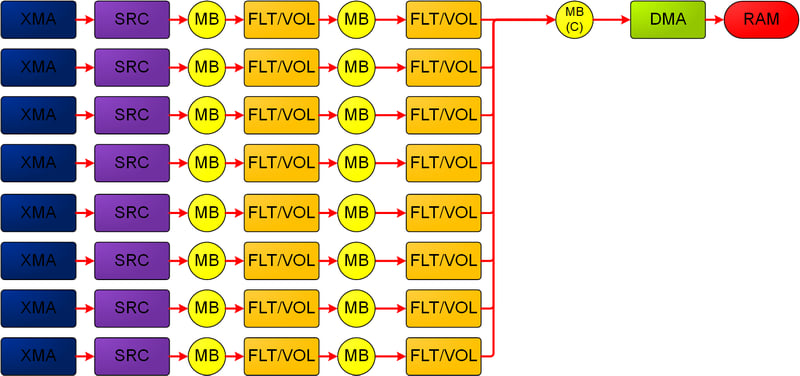
Viagens de ida e volta de DMA excessivas ou frequentes e de baixo valor
O DMA é limitado pela largura de banda de leitura/gravação disponível no barramento do SHAPE. Se você consumir toda a largura de banda disponível (embora esse cenário normalmente seja patológico), os blocos DMA ficarão paralisados e reduzirão a taxa de transferência. Conforme discutido anteriormente, todo o processamento que ocorre após um bloco de entrada DMA terá de aguardar até que o DMA seja concluído. Portanto, você pode criar flowgraphs com grande parte do flowgraph bloqueada, aguardando a conclusão de um DMA antes que o flowgraph possa iniciar o processamento. Você também deve avaliar as viagens de ida e volta de DMA em relação ao valor que elas agregam ao fluxo de áudio. A adição mínima de latência (que você pode controlar em termos do número de quadros acessados via DMA em múltiplos do tamanho de 2,667 ms do quadro de áudio) pode não ser uma preocupação na maioria dos cenários de reprodução de áudio. Isso ocorre porque os blocos à direita de um DMA processarão dados de áudio de quadros anteriores. Em particular, enviar um DMA de volta ao SHAPE apenas para realizar uma mixagem final pode ser desnecessário quando você também planeja enviar essa mixagem final como DMA de volta para a memória para apresentação a um ponto de extremidade de áudio. A figura 5 mostra um exemplo de valor potencialmente baixo, em que uma voz enviada via DMA para a memória para processamento de CPU/GPU é trazida de volta ao SHAPE apenas para ser panoramizada em 7.1 na mixagem de masterização. A voz é então enviada via DMA de volta para a memória. A figura 5 pressupõe que nenhuma filtragem está sendo aplicada às vozes nos blocos FLT/VOL e que os mix buffers de masterização 7.1 têm vozes adicionais roteadas para eles. Figura 5. Um flowgraph que mostra um roteamento de valor potencialmente baixo, envolvendo componentes FLT/VOL desnecessários e viagens de ida e volta de DMA desnecessárias.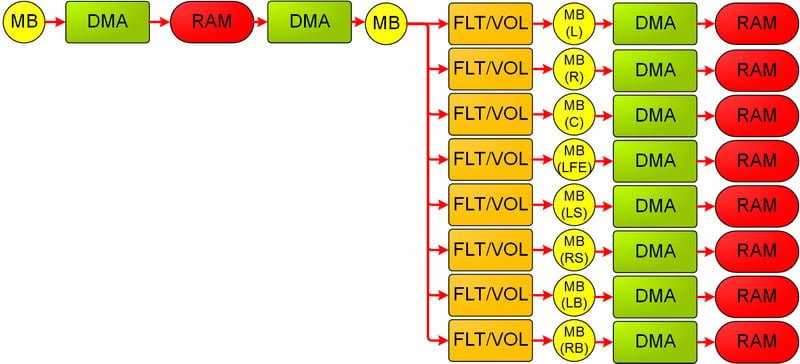
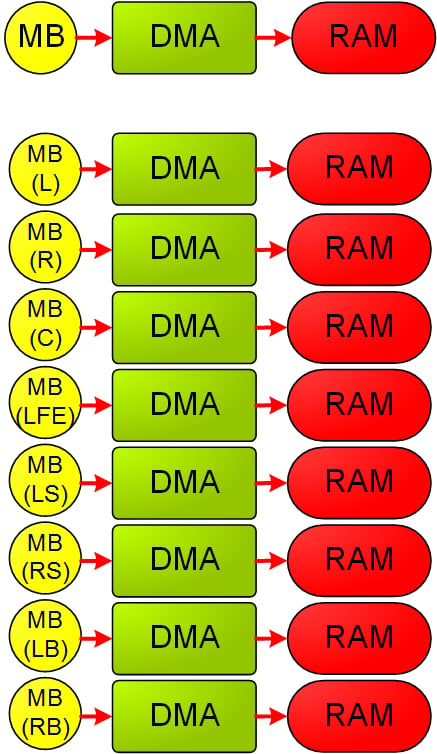
- Pretende realizar uma quantidade significativa de processamento adicional do SHAPE para uma voz específica.
- Deseja aproveitar a medição de hardware e a detecção de clipping oferecidas pelos mix buffers.
Planejamento e revisão de flowgraphs do SHAPE
Como exercício, antes da implementação, crie uma representação visual de um flowgraph do uso de vozes que você espera em um quadro, com as vozes categorizadas e quantificadas, por exemplo, em termos do número de efeitos sonoros e de fluxos de música simultâneos. Capturar essas informações visualmente pode ajudar você a entender como evitar algumas das armadilhas de desempenho discutidas anteriormente. Veja a seguir algumas das principais métricas que você pode derivar de um flowgraph como esse.-
O número máximo de cada componente do SHAPE, simultâneo e dentro do quadro geral:
- Verifique se esse flowgraph fica suficientemente abaixo dos picos teóricos.
- Observe a subutilização e a sobreutilização de componentes. Reequilibre os componentes conforme necessário.
- Considere reestruturar o uso de mix buffers se muitos precisarem permanecer bloqueados durante a maior parte do flowgraph.
-
Planejamento para a implementação de posicionamento 3D via SHAPE:
- Todas as vozes serão panoramizadas em 7.1, ou as vozes serão panoramizadas entre os 2 ou n alto-falantes mais próximos?
- Toda a panoramização 7.1 deve ser feita no SHAPE, ou é melhor panoramizar na própria CPU as vozes que já foram enviadas via DMA para a CPU?
- Número de transições de DMA de e para a memória, e se essas transições são assimétricas. Por exemplo, algumas vozes são gravadas e lidas no SHAPE mais vezes do que outras, o que significa que provavelmente terão latência adicional.
Flowgraphs persistentes versus não persistentes
Você pode enviar flowgraphs para serem processados como persistentes ou não persistentes. Os flowgraphs persistentes são processados e depois permanecem residentes para repetir seu processamento no próximo quadro, depois que os ponteiros de leitura e gravação avançam e depois que outras informações de contexto são atualizadas. Use flowgraphs persistentes em qualquer um dos cenários a seguir.- Flowgraphs altamente complexos: os flowgraphs que exigem uma quantidade significativa de processamento de CPU para serem remontados a cada quadro
- Flowgraphs altamente estáticos: os flowgraphs que mantêm o mesmo número e a mesma configuração de vozes por um longo período
- As topologias de vozes mudam com frequência.
- A cadência de processamento do engine de software de áudio do seu título é desvinculada do hardware do SHAPE, ou seja, não é um múltiplo de 2,667 ms.
- Você deseja executar o processamento de áudio em cenários mais rápidos que o tempo real, ou seja, quando você envia grafos para serem consumidos assim que ficam disponíveis.
Depuração de problemas do SHAPE
Recomendamos que, ao desenvolver flowgraphs, você se registre para receber mensagens que ajudem a depurar problemas. Especificamente, use o parâmetroNumMessages do método IAcpHal::Connect.
O sistema de mensagens fornece feedback detalhado sobre uma variedade de problemas, incluindo flowgraphs inválidos (como ACP_FLOWGRAPH_TERMINATED_REASON_INVALID_GRAPH), comandos bloqueados e frame-outs causados por tentativas de realizar mais processamento do que o tamanho de 2,667 ms do quadro de hardware permite.
Esse método é útil para depuração. No entanto, antes do lançamento do seu título, tente fazer o seguinte:
- Elimine todas as mensagens que indicam erros dos cenários de runtime.
- Verifique se o processamento do flowgraph é bem-sucedido de forma consistente examinando as mensagens
ACP_MESSAGE_TYPE_FLOWGRAPH_COMPLETED(consulte a enumeração ACP_MESSAGE_TYPE) para cada flowgraph enviado.
Mensagens perdidas
Se você usar mensagens do ACP para conduzir o estado do engine e lidar com um grande número de mensagens, deverá examinarACP_MESSAGE::droppedMessageCount durante o desenvolvimento. Um valor diferente de zero indica que a fila de mensagens estava cheia e que mensagens precisaram ser descartadas. Se esse valor ocorrer, considere atender a fila mais rapidamente e aumentá-la.
Frame-outs
Durante o desenvolvimento, devido a excesso de orçamento, flowgraphs subótimos e outros motivos, um flowgraph pode não ser concluído antes de o fim de um quadro de áudio (2,667 ms) ser atingido. Esse flowgraph incompleto resultará em uma mensagemACP_FLOWGRAPH_TERMINATED_TIME_EXCEEDED para flowgraphs persistentes. Eles ficarão incompletos. Por outro lado, um flowgraph não persistente não é restringido dessa maneira e será executado até ser concluído, mesmo entre quadros.
Comandos bloqueados
Os comandos SRC e DMA podem ser relatados como bloqueados (ACP_MESSAGE_TYPE_SRC_BLOCKED e ACP_MESSAGE_TYPE_DMA_BLOCKED (consulte a enumeração ACP_MESSAGE_TYPE)) em vários cenários, conforme mostrado na tabela a seguir.
Depois que se determina que os comandos estão bloqueados (o que pode ocorrer tanto antes de os itens serem adicionados a uma fila do SHAPE para processamento quanto em runtime), os comandos são removidos do grafo. Isso pode levar à perda de áudio. Durante o desenvolvimento, use os comandos bloqueados como o primeiro lugar para procurar melhorias no tratamento de flowgraphs. Antes do lançamento, seu título também deve impedir o bloqueio de comandos.
Você pode impedir o bloqueio de comandos DMA garantindo que seu buffer de áudio seja suficientemente grande e que os dados sejam transmitidos em intervalos regulares em relação ao tamanho do buffer. Por exemplo, se você estiver transmitindo quatro quadros de hardware por vez, garanta que algum múltiplo desses quadros (pelo menos com buffer duplo, em oito) esteja no buffer para permitir que o hardware grave à frente do ponteiro de leitura do título. Como alternativa, você pode forçar o esvaziamento do buffer antes de enviar o próximo flowgraph consumindo, atualizando o ponteiro de leitura do DMA e, em seguida, enviando o flowgraph.
Os comandos SRC têm os três modos a seguir (detalhados em ShapeSrcContext.h).
-
SHAPE_SRC_COMMAND_TYPE_STARTUse-o para quase todos os comandos SRC em um flowgraph. Processe normalmente e espere que mais dados de áudio sigam o flowgraph atual. -
SHAPE_SRC_COMMAND_TYPE_STOP_IMMEDIATEUse-o para interromper imediatamente o processamento dos dados XMA ou PCM de origem. O SRC produzirá um buffer zerado para este quadro. -
SHAPE_SRC_COMMAND_TYPE_STOP_ENDUse-o para indicar o último pacote de uma voz. Se não for enviado comSTOP_ENDouSTOP_IMMEDIATE, o comando SRC não será concluído. Isso fará com que o flowgraph ativo fique paralisado. Um flowgraph persistente será encerrado no fim do quadro de áudio, e um flowgraph não persistente nunca será concluído.