
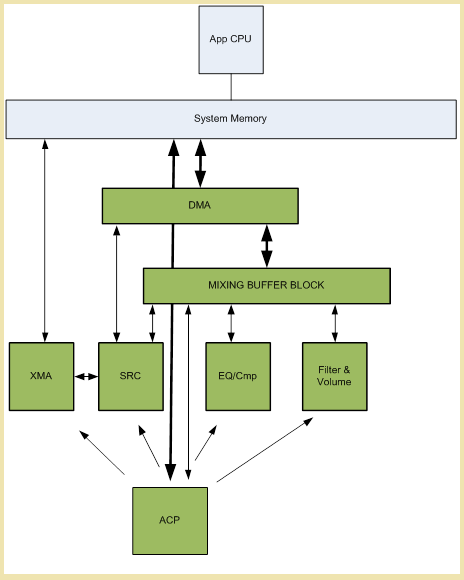
- Executa com eficiência funções de áudio comumente usadas por meio de blocos de hardware de função fixa: XMA, conversor de taxa de amostragem (SRC), equalizador e compressão, e filtro/volume
- Fornece um processador de controle de áudio (ACP) incorporado e programável para controlar esses blocos
- Um processo de acesso direto à memória (DMA) para acessar a memória do sistema
- Uma memória interna especial, chamada buffers de mixagem Um buffer de mixagem é um bloco de memória que armazena um quadro de áudio completo de dados. O hardware SHAPE normalmente lê de um ou dois buffers de mixagem e grava em um buffer de mixagem de saída. Há algumas exceções a esse processo geral, como a decodificação XMA e os blocos DMA e SRC.
XAudio2 e o middleware de áudio implementam os componentes do SHAPE implicitamente. No entanto, a construção de flowgraphs oferece a maior flexibilidade e o maior acesso aos recursos de aceleração de áudio do console XBOX One.
Este tópico fornece uma visão geral do hardware SHAPE e dos blocos de função.
- Fluxo de controle
- DMA
- XMA
- PCM
- Bloco do conversor de taxa de amostragem (SRC)
- Equalização e compressão
- Bloco de filtro/volume (FLTVOL)
- Buffers de mixagem
- Estouro, magnitude e saturação
- Filas do SHAPE
- Considerações de programação
Fluxo de controle
Veja a seguir um fluxo de controle típico para o processamento de áudio.- Um arquivo de dados de áudio XMA compactado é carregado na memória principal do sistema.
- O bloco decodificador XMA decodifica uma parte dos dados XMA em dados PCM (Pulse Code Modulation). Ele armazena a saída em um buffer de decodificação XMA na memória do sistema.
- O bloco SRC lê as amostras PCM do buffer de decodificação XMA e executa a conversão de taxa de amostragem e o deslocamento de pitch necessários. Isso permite que dados de áudio com uma taxa de amostragem arbitrária sejam levados para os blocos aceleradores do SHAPE. O bloco SRC envia dados de áudio na taxa fixa de 48 KHz para um buffer de mixagem interno.
- Qualquer processamento adicional do SHAPE e a leitura e gravação em buffers de mixagem temporários são executados nesse momento. O processamento é controlado pelo ACP, que, por sua vez, é conduzido pelo aplicativo por meio da API do ACP descrita neste conjunto de documentação. O processamento inclui equalização, compressão, dimensionamento de filtro e dimensionamento de volume.
- A etapa final, chamada Speaker Output Accumulation (acumulação de saída dos alto-falantes), é onde os buffers de mixagem dos alto-falantes coletam e mixam as amostras de várias fontes sonoras para reprodução. Efeitos de áudio globais opcionais podem ser processados nessa etapa.
- Um arquivo de dados de áudio XMA compactado é carregado na memória principal do sistema.
- O bloco decodificador XMA decodifica uma parte dos dados XMA em dados PCM, armazenando a saída em um buffer de decodificação XMA na memória do sistema.
- O bloco SRC lê as amostras PCM do buffer de decodificação XMA e executa a conversão de taxa de amostragem e o deslocamento de pitch necessários. Isso permite que dados de áudio com uma taxa de amostragem arbitrária sejam levados para os blocos aceleradores do SHAPE. O bloco SRC envia dados de áudio na taxa fixa de 48 KHz para um buffer de mixagem interno.
- Nesta etapa, o fluxo do processo diverge. O sistema DMA é usado para transferir um ou mais buffers de mixagem para a memória principal do sistema.
- A CPU do aplicativo executa qualquer processamento de sinal necessário no buffer na memória principal.
- O sistema DMA é usado para transferir os dados de áudio processados do buffer da memória principal para um buffer de mixagem temporário. Após essa etapa, o processo é idêntico ao descrito anteriormente.
- Qualquer processamento adicional do SHAPE e a leitura e gravação em buffers de mixagem temporários são executados nesse momento. O processamento é controlado pelo ACP, que, por sua vez, é conduzido pelo aplicativo por meio da API do ACP descrita neste conjunto de documentação. O processamento inclui equalização, compressão, dimensionamento de filtro e dimensionamento de volume.
- A etapa final, Speaker Output Accumulation, é onde os buffers de mixagem dos alto-falantes coletam e mixam as amostras de várias fontes sonoras para reprodução. Efeitos de áudio globais opcionais podem ser processados nessa etapa.
DMA
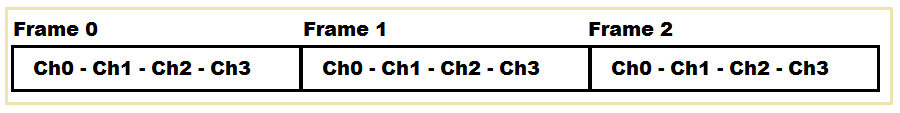
O sistema de acesso direto à memória (DMA) oferece suporte à funcionalidade de leitura/gravação com conversão automática de float para inteiro e de inteiro para float. O sistema DMA usa buffers circulares que contêm amostras desintercaladas em blocos de 128 amostras. O processador DMA permite que o mecanismo SHAPE envie dados dos buffers de mixagem para a memória principal do sistema e recupere dados da memória principal do sistema para os buffers de mixagem, para processamento adicional. O DMA é executado por bloco. Um quadro de áudio de dados é transferido por vez. Para facilitar dados intercalados por bloco, um valor de salto especifica o número de blocos de quadros de áudio na memória do sistema que devem ser ignorados (a partir do endereço base) quando as amostras são lidas ou gravadas. Por esse motivo, fluxos multicanal exigem um contexto DMA por canal. As amostras de dados de áudio são sempre lidas e gravadas como valores de 32 bits, seja como inteiros ou floats, conforme especificado no sinalizadorFloatConvert do contexto DMA. Para ajudar a reduzir a quantidade de largura de banda de dados, a direção do DMA (leitura ou gravação) é especificada no comando DMA, e não no contexto DMA. O mecanismo DMA não faz processamento de sinal, mas pode converter floats em inteiros e inteiros em floats. Isso permite que a CPU do aplicativo processe amostras de dados em formato de ponto flutuante.
Para calcular o tamanho de um buffer DMA, use a fórmula a seguir.
XMA
O formato XMA oferece suporte a som mono, estéreo e multicanal intercalado com taxas de bits e compressão variáveis. Várias melhorias foram feitas em relação à implementação de XMA do XBOX 360, incluindo um aumento na taxa de clock (com uma melhoria de 40% nos recursos de deslocamento de pitch, por exemplo) e um aumento na contagem de vozes de 320 para 512. O bloco decodificador XMA decodifica uma parte dos dados XMA na memória principal e retorna os dados PCM para um buffer de decodificação XMA na memória principal. O bloco decodificador XMA é idêntico ao bloco decodificador XMA do XBOX 360, exceto por pequenos aprimoramentos relacionados ao estado para a interface com outros componentes do SHAPE. O bloco de registradores do decodificador XMA foi ampliado com as informações de estado relacionadas à saída decodificada de cada voz. Cinco bits por contexto XMA especificam a quantidade de dados de áudio que permanece não consumida no buffer de saída PCM. Esses registradores são implementados dentro do bloco decodificador XMA. Isso faz com que eles estejam sempre disponíveis para determinar se há amostras suficientes para bloquear o contexto para o SRC sem ler a memória principal.O xWMA não tem suporte no SHAPE, mas tem suporte por meio do
XAudio2.PCM
O PCM (Pulse Code Modulation) linear oferece suporte a som surround de até 7.1 a 48 KHz. O ACP fará o downmix se o sistema de som do usuário for, por exemplo, surround 5.1 ou estéreo. A saída S/PDIF terá suporte. Também há suporte para buffers PCM lineares e circulares que contêm inteiros mono ou estéreo de 16 bits, floats mono de 32 bits ou inteiros mono de 32 bits (24 bits justificados à esquerda ou 32 bits com os 8 bits inferiores mascarados).Bloco do conversor de taxa de amostragem (SRC)
O bloco SRC executa a conversão de taxa de amostragem baseada em inteiros e grava os dados de saída nos buffers de mixagem. O SRC é normalmente usado para emulação de instrumentos musicais, conversão de amostras de entrada para uma oitava abaixo ou acima da original e para efeitos Doppler e outros. Da memória do sistema, o bloco SRC lê dados PCM de ponto flutuante de 32 bits ou dados de ponto fixo de 16, 24 ou 32 bits. Como dados de entrada, o bloco pode receber a saída do decodificador de hardware XMA ou os dados mantidos pelo software. Por estar fortemente integrado ao decodificador XMA, o bloco SRC pode determinar se o número de amostras de dados PCM decodificados no buffer de decodificação XMA é suficiente para criar e concluir um quadro de áudio de amostras sem ler a memória principal. O SRC opera no modo mono ou estéreo. Os dados PCM são lidos da memória e convertidos em um formato comum de ponto fixo de 24 bits para a conversão de taxa de amostragem. A saída é gravada em um ou dois buffers de mixagem, dependendo do modo. Os dados estéreo são armazenados na memória como um fluxo intercalado de dados de 16 bits. O canal esquerdo fica nos 16 bits menos significativos de cada palavra de 32 bits, e o canal direito fica nos 16 bits mais significativos. Também no modo estéreo, os dados PCM são lidos e desintercalados simultaneamente. Os dados do canal esquerdo (amostras 0,2,4,6…) são processados e enviados para um buffer de mixagem. Os dados do canal direito (amostras 1,3,5,7…) são gravados em um segundo buffer de mixagem. A figura 3 mostra os modos de conversão de taxa de amostragem. Figura 3. Modos de conversão de taxa de amostragem.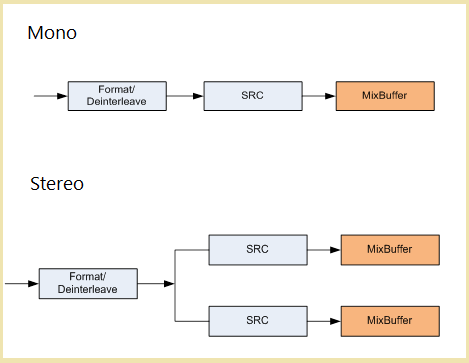
Equalização e compressão
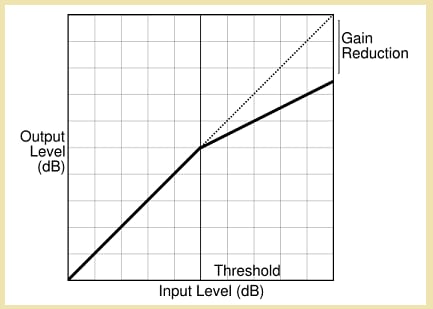
O compressor limita a faixa dinâmica do sinal monitorando o nível de entrada e criando um valor de ganho dinâmico. Em seguida, o compressor usa o valor de ganho como multiplicador do sinal, dimensionando-o adequadamente de acordo com o nível atual do sinal de entrada. Em outras palavras, o compressor é um controle automático de volume que monitora constantemente o sinal de entrada e se ajusta. O compressor atua apenas em sinais que excedem um limite específico. Sinais abaixo do limite passam sem alteração. O limite é definido pelo aplicativo como parte dos dados de contexto EQComp. Um controle programável no contexto é usado para executar compressão ou expansão. O compressor altera os dados de som de acordo com um parâmetro que especifica a razão entre o nível de entrada e o nível de saída. A razão representa o grau de atenuação a ser aplicado ao sinal de entrada se ele exceder o limite. Os exemplos são os seguintes.- Em 2:1, para cada 2 dB acima do limite, o compressor gera 1 dB acima do nível do limite.
- Em 1:1, o compressor está essencialmente desligado.
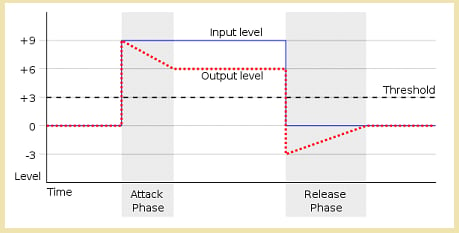
attack e release especificam a rapidez com que o compressor é ativado, ou seja, quanto tempo leva para atenuar totalmente, na quantidade especificada pela razão, os sons que excedem o limite. Attack e release são especificados em milissegundos e correspondem à rapidez com que o compressor deve variar o ganho de saída em resposta a um sinal que excede o limite ou fica abaixo dele. Esses ajustes podem ser lineares ou logarítmicos.
O diagrama a seguir (figura 5) mostra como o nível de saída desejado não é alcançado até que a entrada tenha excedido o limite pelo tempo especificado por attack. O diagrama também mostra como a entrada e a saída retornam à unidade somente depois que a entrada fica abaixo do limite pelo tempo especificado por release.
Figura 5. A temporização de attack/release.
RMS. No modo normal, o nível de entrada é instantâneo e calculado para cada amostra. No modo RMS, uma média móvel (uma aproximação do valor RMS) é mantida sobre as 128 amostras anteriores. A média móvel é usada como nível de entrada, em vez do nível absoluto da amostra de entrada atual.
O bloco EQ/Compressor-Expansor contém duas unidades de processamento separadas em série: um equalizador programável de três bandas e um compressor de faixa dinâmica (figura 6). O bloco é usado para controlar a frequência e a faixa dinâmica dos sons e recebe entrada de um ou dois buffers de mixagem.
- Uma entrada é o sinal de áudio a ser processado.
- A segunda entrada, chamada sidechain, é o sinal de controle opcional usado para determinar a compressão de áudio.

-
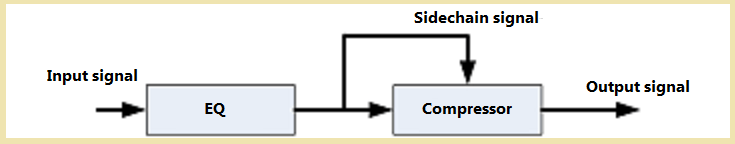
No modo Normal (figura 7), há uma única entrada de áudio de um buffer de mixagem. A entrada passa pelo equalizador, onde é posteriormente processada pelo compressor e enviada para um buffer de mixagem.
Figura 7. Modo Normal.
-
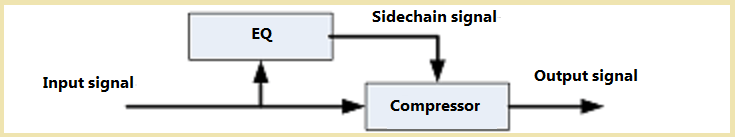
No modo Interno (figura 8), o sinal de entrada é enviado diretamente para a entrada de áudio do compressor e é dividido e enviado ao equalizador. Do equalizador, ele é enviado para a entrada sidechain do compressor.
Figura 8. Modo Interno.
-
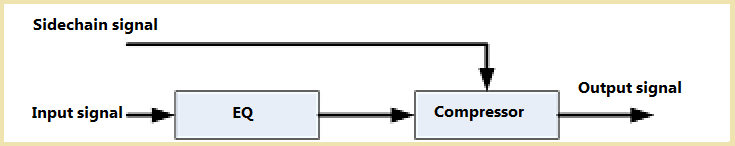
No modo Externo (figura 9), dois sinais de entrada separados são usados de dois buffers de mixagem separados. O sinal de entrada passa pelo equalizador e entra na entrada de áudio do bloco de compressão. O sinal de entrada sidechain é enviado diretamente para a entrada sidechain do compressor.
Figura 9. Modo Externo.
Bloco de filtro/volume (FLTVOL)
O FLTVOL é usado para fazer o seguinte:- Modelar a oclusão de sons que contornam ou atravessam um objeto
- Distribuir a energia do som para vários alto-falantes, para modelar a direção da qual o som chega.
f e q são calculados pelo software fora do bloco SHAPE. Quando um coeficiente é atualizado, ele é ajustado gradualmente até o novo valor ao longo de um quadro de áudio. Bits de controle são usados para determinar qual saída (rejeita-banda, passa-altas, passa-banda ou passa-baixas) deve ser usada como saída final do bloco FLTVOL.
Os dados de contexto de cada canal ou fluxo são armazenados na memória do sistema. Embora o desempenho seja limitado a 2560 fluxos simultâneos de 48 KHz (o que significa que o SHAPE pode processar até 2560 contextos FLTVOL por quadro de áudio), o número de contextos endereçáveis na memória é maior, para simplificar os cenários de reutilização de fluxos.
O comportamento de filtragem foi projetado para ser idêntico ao do XAudio2.
Buffers de mixagem
Os buffers de mixagem têm três finalidades principais.- Os buffers de mixagem atuam como destino final de mixagem para cada saída de alto-falante do sistema (ou de um jogador individual). Quando cada som é processado, sua saída subsequente é mixada nesses buffers.
- Os buffers de mixagem atuam como locais de armazenamento temporário quando buffers de dados de áudio são passados entre blocos de hardware.
- Em conjunto com o mecanismo DMA, os buffers de mixagem servem como mecanismo para passar dados do hardware SHAPE e do subsistema de áudio para o sistema principal e também para passar dados da memória principal do sistema de volta para o hardware SHAPE e o subsistema de áudio.
Estouro, magnitude e saturação
Em um mecanismo de áudio de um título, gerenciar o headroom pode ser muito difícil. Por esse motivo, cada bloco do SHAPE mantém o estado associado à sobrecarga e ao ganho do sinal. Cada bloco, exceto o SRC, mantém um sinalizador que indica se ocorreu saturação interna durante o processamento. Além do sinalizador de saturação interna, cada bloco de hardware também mantém dois números de quatro bits que representam a magnitude da saída do bloco de hardware. A magnitude é calculada determinando o pico de saída durante o quadro de áudio e contando os zeros à esquerda do valor absoluto do pico. Um número de quatro bits é mantido com a magnitude de pico persistente, e o outro é redefinido pelo hardware a cada quadro de áudio. Além de monitorar a magnitude de pico de cada bloco de hardware individual, a magnitude de pico dos buffers de mixagem também é mantida. Quando a saída de um bloco de hardware é adicionada a um buffer de mixagem, a magnitude de pico é calculada da mesma maneira, contando os zeros à esquerda. O estado de cada bloco de hardware mantém um par adicional de valores de magnitude de pico de quatro bits. Esses valores representam a magnitude de pico do buffer de mixagem depois que a saída do bloco de hardware foi acumulada no buffer de mixagem. Um número de quatro bits representa a magnitude de pico contínua e persistente. O outro é atualizado a cada quadro de áudio. Os valores de magnitude de pico são salvos no contexto dos blocos do SHAPE, embora o que esteja sendo representado seja o estado do buffer de mixagem. A magnitude de pico é codificada de acordo com a tabela a seguir (codificada no arquivo ShapeHardwareContexts.h).
Para ajudar a gerenciar a sobrecarga e evitar estouro e saturação, além das configurações de ganho refinadas, um deslocamento para a direita de 0 a 7 bits pode ser aplicado à saída de um bloco de hardware antes da acumulação no buffer de mixagem de saída. Isso é designado no contexto de cada bloco de hardware do SHAPE.
Filas do SHAPE
O processador de áudio do SHAPE gerencia duas filas que ajudam a reduzir os bloqueios entre o hardware do sistema e o hardware do aplicativo.- A fila de comando e controle (CCQ) é usada para fornecer ao processador de áudio do SHAPE uma série de comandos a serem executados sempre que possível, geralmente quando ele conclui o processamento do quadro de áudio atual. A lista de execução do SHAPE é lida uma vez para cada saída de quadro de áudio. No entanto, a CCQ será lida e executada apenas uma vez. A CCQ é o mecanismo que permite à CPU atualizar os dados de contexto de qualquer bloco em um limite de quadro de áudio sem exigir um bloqueio de hardware com o hardware SHAPE. Exemplos incluem fornecer mais dados de fluxo de bits para o bloco XMA, atualizar parâmetros de contexto para vários blocos e apontar para uma nova lista de execução. Isso geralmente é feito enquanto o flowgraph de processamento de áudio é alterado.
- A fila de status e relatórios (SRQ) é usada pelo processador de áudio do SHAPE para informar à CPU vários eventos que não exigem respostas em tempo real. Exemplos incluem a atualização do consumo do buffer de fluxo de bits, erros, avisos e sinalizadores, dados de depuração, dados de desempenho e informações de status.
Considerações de programação
A programação direta para o hardware SHAPE é habilitada por meio da interfaceIACPHAL. No entanto, o processo de preparação de dados de áudio para o hardware SHAPE é complexo. Muitos métodos, estruturas e enumerações utilitários são fornecidos. Esses utilitários fornecem todos ou a maioria dos métodos necessários para controlar o hardware SHAPE. O Microsoft Game Development Kit (GDK) inclui o código-fonte desses utilitários para os raros casos em que é necessário alterar o código para lidar com determinados tipos de dados.
O único arquivo de cabeçalho que precisa ser incluído explicitamente no seu projeto é acphal.h, que referencia todos os arquivos de cabeçalho utilitários. Todas as funções utilitárias referenciam a macro NO_SHAPE_CONTEXT_VALIDATION. Se essa macro estiver definida, todas as validações serão omitidas. Isso será útil para builds finais de varejo.
Para obter mais detalhes sobre o compartilhamento de recursos SHAPE e XMA com instâncias do XAudio2, confira a seção Comentários da função XAudio2Create.
Para obter mais detalhes sobre todos os métodos utilitários, confira Visão geral do ACP.
Flowgraphs persistentes e não persistentes
Você pode enviar flowgraphs para serem processados como persistentes ou não persistentes. Os flowgraphs persistentes são processados e permanecem residentes, de modo que seu processamento seja repetido no próximo quadro depois que os ponteiros de leitura e gravação avançarem e outras informações de contexto forem atualizadas. Use flowgraphs persistentes para qualquer um dos seguintes cenários.- Flowgraphs altamente complexos, que exigem uma quantidade significativa de processamento da CPU para remontar cada quadro
- Flowgraphs altamente estáticos, que têm o mesmo número e configuração de vozes por um período prolongado
- As topologias de voz mudam com frequência.
- A cadência de processamento do mecanismo de software de áudio do seu título é desvinculada do hardware SHAPE, ou seja, não é um múltiplo de 2,667 MS.
- Você deseja executar o processamento de áudio mais rápido do que em tempo real, enviando grafos para serem consumidos assim que estiverem disponíveis.
Depuração de problemas
Ao desenvolver flowgraphs, registrar-se para receber mensagens ajudará a depurar quaisquer problemas que possam ocorrer. Especificamente, use o parâmetroNumMessages de Connect. O sistema de mensagens fornece um feedback detalhado sobre diversos problemas, incluindo flowgraphs inválidos (ACP_FLOWGRAPH_TERMINATED_REASON_INVALID_GRAPH), comandos bloqueados e estouros de quadro (frame-outs) causados quando você tenta executar mais processamento do que o tamanho de quadro de 2,667 MS do hardware permite. Antes de lançar um título, verifique se o processamento do flowgraph é bem-sucedido de forma consistente observando as mensagens ACP_MESSAGE_TYPE_FLOWGRAPH_COMPLETED para cada flowgraph enviado.
Mensagens perdidas
Se você usar mensagens do ACP para conduzir o estado do mecanismo e lidar com muitas mensagens, deverá examinar o campodroppedMessageCount de ACP_MESSAGE durante o desenvolvimento. Um valor diferente de zero nesse campo indica que a fila de mensagens estava cheia e que mensagens precisaram ser descartadas. Nesse cenário, considere atender à fila mais rapidamente e aumentá-la.
Frame-outs
Há muitos motivos pelos quais um flowgraph pode não ser concluído antes do fim de um quadro de áudio (2,667 MS), por exemplo, o processamento de flowgraphs demais ou o processamento de um flowgraph mal estruturado. Esse flowgraph incompleto resultará em uma mensagemACP_FLOWGRAPH_TERMINATED_TIME_EXCEEDED para flowgraphs persistentes, e esses flowgraphs persistentes ficarão incompletos. Por outro lado, um flowgraph não persistente não tem essa restrição e será executado até ser concluído, mesmo entre quadros.
Comandos bloqueados
Os comandos SRC e DMA podem ser informados como bloqueados (ACP_MESSAGE_TYPE_SRC_BLOCKED, ACP_MESSAGE_TYPE_DMA_BLOCKED) em vários cenários, conforme mostrado na tabela a seguir.
| Tipo de comando| Cenário de bloqueio|
| --- | --- | --- | --- |
| XMA SRC| O contexto XMA associado tem um erro de analisador ou não tem dados de origem. O erro é SHAPE_XMA_ERROR_STATUS_READ_BUFFER_INVALID_VALIDBUFFER_CURRBUF_IS_0 | SHAPE_XMA_ERROR_STATUS_FRAME_CROSSES_BOUNDARY_INTO_INVALID_READ_BUFFER_VALIDBUFFER_CURRBUF_IS_0 | SHAPE_XMA_ERROR_STATUS_FRAME_CROSSES_BOTH_READ_BUFFER_BOUNDARIES. O XMA SRC não será bloqueado por falta de dados decodificados.|
| PCM SRC| O contexto PCM associado é SHAPE_PCM_MODE_CIRCULAR e não há dados de origem.|
| Leitura (DMA do buffer de mixagem)| O buffer DMA está cheio.|
| Gravação (DMA para o buffer de mixagem)| O buffer DMA está vazio.|
Depois que se determina que os comandos estão bloqueados (o que ocorre tanto antes de serem adicionados a uma fila do SHAPE para processamento quanto em tempo de execução), eles são removidos do grafo, o que pode levar à perda de áudio. Durante o desenvolvimento, use os comandos bloqueados como o primeiro lugar a procurar melhorias no tratamento de flowgraphs. Além disso, antes do lançamento, verifique se o seu título impede totalmente que os comandos sejam bloqueados.
Você pode impedir o bloqueio de comandos DMA garantindo que o buffer de áudio seja suficientemente grande e que os dados sejam transmitidos em intervalos regulares em relação ao tamanho do buffer. Por exemplo, se você estiver transmitindo quatro quadros de hardware por vez, garanta que algum múltiplo desses quadros (pelo menos com buffer duplo, em oito) esteja no buffer, para que o hardware possa gravar à frente do ponteiro de leitura do título. Como alternativa, você pode forçar o esvaziamento do buffer antes de enviar o próximo flowgraph: consuma, atualize o ponteiro de leitura do DMA e, em seguida, envie o flowgraph.
Os comandos SRC têm três modos.
SHAPE_SRC_COMMAND_TYPE_STARTé usado para quase todos os comandos SRC em um flowgraph. Executa o processamento normal e espera que mais dados de áudio sigam o flowgraph atual.SHAPE_SRC_COMMAND_TYPE_STOP_IMMEDIATEé usado para interromper imediatamente o processamento dos dados XMA ou PCM de origem. O SRC gerará um buffer zerado para esse quadro.SHAPE_SRC_COMMAND_TYPE_STOP_ENDé usado para indicar o último pacote de uma voz.
STOP_END ou STOP_IMMEDIATE, o comando SRC não será concluído, o que fará com que o flowgraph ativo fique paralisado. Um flowgraph persistente será encerrado no fim do quadro de áudio, e um flowgraph não persistente nunca será concluído.
Problemas de sincronização
Podem surgir problemas de sincronização se você não respeitar as práticas de consumo de contextos e comandos do hardware SHAPE. Embora seus títulos mantenham acesso total à memória alocada pelo ACP, tome cuidado para não modificar uma estrutura de contexto enquanto ela estiver em uso. Você pode usar SubmitCommand para enviar comandos a serem executados em um quadro específico, no início do próximo quadro ou o mais rápido possível.O cenário “o mais rápido possível” ainda é assíncrono em relação a qualquer processamento da CPU do título. Alguns comandos podem não ser concluídos imediatamente, por exemplo, se um contexto estiver no meio de uma operação não interrompível. Aguarde um
ACP_MESSAGE_TYPE_COMMAND_COMPLETED para verificar se um comando foi realmente processado.