Matériel
Les divers fabricants de matériel indépendants (IHV) définissent les topologies de processeurs hétérogènes de façon différente. Intel et Qualcomm utilisent les termes Performance et Efficiency, tandis qu’AMD utilise les termes Performance et Compact. Chaque fabricant fait des compromis entre performances et efficacité lors de la conception de la topologie de ses cœurs. Les exemples suivants illustrent certains des choix de conception en jeu :- Tailles de cache différentes
- Les différents cœurs peuvent avoir des tailles de cache différentes.
- Par exemple, les cœurs performants peuvent avoir des caches L1 et L2 plus grands.
- Partage du cache
- Le niveau de partage des caches entre les cœurs peut varier.
- Par exemple, les cœurs plus performants peuvent chacun disposer d’un cache L2 privé, tandis que les cœurs plus efficaces peuvent partager un seul cache L2.
- Prise en charge du multithreading simultané (SMT)
- Certains cœurs peuvent prendre en charge le SMT alors que d’autres non.
- Intel désigne le SMT sous le nom d’Hyper-Threading.
- Disposition interne des cœurs
- Les ressources internes des divers types de cœurs peuvent être différentes.
- Par exemple, les cœurs performants peuvent comprendre davantage de pipelines à virgule flottante, de pipelines ALU ou des voies de données plus larges.
- Fréquence maximale
- La fréquence maximale peut différer d’un type de cœur à l’autre.
- Par exemple, les cœurs performants peuvent atteindre une fréquence plus élevée que les cœurs efficaces.
Données de performances
On s’attend à ce que des cœurs de niveaux d’efficacité différents offrent des performances différentes. Un cœur est conçu pour les performances et l’autre pour les économies d’énergie. La question est de savoir à quel point les cœurs diffèrent. Les données présentées sont un regroupement de plusieurs IHV. Chaque IHV présente une mise à l’échelle différente pour chaque test, selon les choix qu’il a faits pour sa topologie. Bien que les chiffres exacts diffèrent, les tendances sont semblables chez tous les IHV. De plus, chaque génération de processeurs fait des compromis différents, ce qui modifie leurs chiffres relatifs. La production de données pour tous les IHV et toutes les générations existants dépasse la portée de cet article.Tests synthétiques
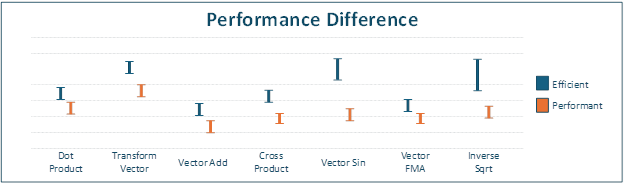
Les mathématiques vectorielles représentent une part importante du travail qu’un titre de jeu effectue dans une image. Cette charge de travail peut aller de la physique à l’IA en passant par le rendu. Le jeu effectue ce travail à l’aide de types vectoriels comportant trois ou quatre nombres à virgule flottante qui tiennent dans un seul registre SSE de 128 bits. Ces calculs couvrent un large éventail d’opérations, comme les produits scalaires, la multiplication de matrices, les calculs de racine carrée et les transformations de vecteurs. Les écarts de performances dans ces opérations peuvent avoir un effet important sur le temps d’image global. Les graphiques suivants montrent le coût relatif de sept opérations mathématiques courantes. Les mesures utilisent un vecteur de quatre valeurs à virgule flottante de 32 bits stockées dans un seul registre SSE de 128 bits. Une matrice est composée de quatre vecteurs, soit un total de seize valeurs à virgule flottante de 32 bits réparties sur quatre registres SSE de 128 bits. Ces opérations ont été choisies parce qu’elles sont couramment utilisées dans une image.- Produit scalaire : calculer le produit scalaire d’un vecteur.
- Transformation de vecteur : transformer un vecteur en le multipliant par une matrice.
- Addition de vecteurs : additionner deux vecteurs.
- Produit vectoriel : calculer le produit vectoriel de deux vecteurs.
- Sinus vectoriel : calculer une approximation du sinus de chaque élément d’un vecteur.
- FMA vectoriel (multiplication-addition fusionnée) : multiplier deux vecteurs et ajouter un troisième.
- Racine carrée inverse : calculer la racine carrée inverse de la longueur d’un vecteur.
Conditions réelles
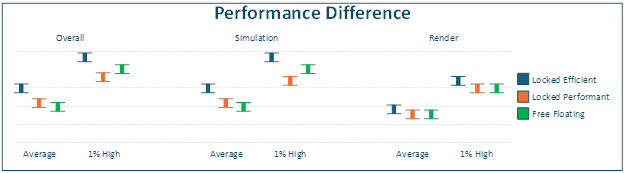
Les données précédentes présentent des bancs d’essai précis pris isolément et ne racontent qu’une partie de l’histoire. Les données suivantes proviennent de bancs d’essai d’un moteur de jeu AAA qui utilise deux threads principaux (Simulation et Rendu) avec un ensemble de threads de tâches. Le banc d’essai utilise trois configurations de test.- Les deux threads principaux s’exécutent uniquement sur les cœurs plus performants.
- Les deux threads principaux s’exécutent uniquement sur les cœurs efficaces.
- Les deux threads principaux s’exécutent sur tous les cœurs du système.
Chaque fabricant peut ajuster ces heuristiques du planificateur pour les adapter à son matériel. Par exemple, AMD dispose de sa technologie Workload Profile Scheduling et Intel de sa technologie Thread Director. Chaque IHV a aussi tendance à ajuster les heuristiques pour qu’elles correspondent à la topologie précise du SoC.
Recommandations
Affinité des threads
Le conseil concernant l’affinité des threads sur un ordinateur de bureau doté d’une seule classe d’efficacité est d’éviter de définir des affinités de threads strictes et de laisser plutôt les threads se déplacer sur tous les cœurs. La principale raison de cette incertitude est qu’on ne sait pas à l’avance quels autres processus pourraient s’exécuter sur l’ordinateur d’un utilisateur. Un thread doté d’une affinité stricte peut finir par partager un cœur avec un autre thread de haute priorité du système. L’effet net est que le thread du titre manque de temps d’exécution. Si cette contention se produit sur un thread critique pour l’image, le titre peut subir des temps d’image irréguliers. Vous voulez vous assurer que le système d’exploitation dispose d’un endroit où déplacer les threads du titre pour qu’ils continuent de s’exécuter. Toutefois, ce conseil doit changer lors de l’exécution sur des processeurs hétérogènes. La principale raison est que le système d’exploitation ne sait pas nécessairement quels threads ou quelles tâches du titre sont critiques pour l’image. Il dispose de certaines heuristiques pour déterminer ce qu’il considère comme les threads critiques pour l’image, mais ces heuristiques peuvent tout de même faire de mauvais choix. Il pourrait décider de déplacer l’un de ces threads ou l’une de ces tâches vers un cœur moins performant, ce qui augmente la probabilité de problèmes de performances dans le titre. La recommandation est de permettre aux threads du titre de s’exécuter sur au moins trois à quatre cœurs, et davantage de préférence. Par exemple, sur un système d’entrée de gamme doté d’un cœur plus performant et de trois cœurs moins performants, vous devriez permettre aux threads de se déplacer sur tous les cœurs. Sur les ordinateurs dotés d’au moins trois cœurs performants, vous pourriez restreindre les threads critiques pour l’image à ces seuls cœurs plus performants. Sur les ordinateurs haut de gamme dotés de nombreux cœurs qui prennent aussi en charge le SMT, certains titres pourraient tenter de verrouiller leurs threads sur des cœurs physiques. Cette technique évite la contention au niveau du cœur physique, puisque plusieurs threads de haute priorité partagent les mêmes ressources d’un cœur physique. En général, il n’est toutefois pas recommandé d’envisager ce cas. Le système d’exploitation applique déjà ce comportement à l’échelle du système. Il planifie d’abord les threads sur les cœurs physiques et n’utilise des cœurs logiques supplémentaires qu’au besoin. Le seul cas qu’un titre devrait envisager est celui où le système compte suffisamment de cœurs plus performants pour prendre en charge les threads critiques du titre. Dans ce cas, il peut être souhaitable de verrouiller les threads critiques pour l’image sur les cœurs plus performants. Toutefois, ces threads devraient pouvoir se déplacer sur tous les cœurs plus performants. Bien que, dans certains cas, permettre à tous les threads de se déplacer sur tous les cœurs puisse améliorer les performances, ce comportement n’est pas constant chez tous les fabricants de processeurs. Si le titre met en œuvre un système de vol de travail (work stealing) capable d’équilibrer entièrement la charge de travail entre tous les threads, alors tout thread de tâches devrait pouvoir se déplacer sur tous les cœurs. Peu importe qu’il s’agisse de threads de tâches de haute ou de basse priorité. L’algorithme de vol de travail équilibre automatiquement la charge et permet d’accomplir le plus de travail possible dans le plus court délai. Les threads situés sur les cœurs plus performants exécutent davantage de tâches pendant l’image. S’il existe plusieurs threads critiques pour l’image, il peut être utile de définir leur affinité de façon à ce que deux threads critiques ne puissent jamais s’exécuter sur le même cœur. Par exemple, s’il y a deux threads critiques pour l’image, définir leurs affinités comme mutuellement exclusives (OU exclusif) élimine la possibilité que le système d’exploitation les mette en contention. Encore une fois, n’envisagez cette option que s’il y a suffisamment de cœurs pour prendre en charge ce cas tout en permettant à chaque thread critique pour l’image de se déplacer sur au moins trois à quatre cœurs.Topologie des threads
Lorsque vous déterminez comment attribuer le travail aux threads dans un environnement hétérogène, les données principales concernent la durée des diverses tâches et la façon dont elles interagissent entre elles : quelle est la durée moyenne de chaque tâche, quelles sont les dépendances entre les tâches, quelles sont les priorités de chaque tâche, etc. Dans quelle mesure les threads de tâches peuvent-ils absorber des pics de temps sur les threads ou tâches critiques? Si l’un de ces threads ou l’une de ces tâches s’exécute 35 % plus lentement, quel est l’effet sur le temps d’image? Par exemple, si une tâche dure plus longtemps, dans quelle mesure ce retard affecte-t-il le reste de l’image, et le système se bloque-t-il jusqu’à ce que cette tâche soit terminée? Il peut être utile de déterminer dans quelle mesure un système hétérogène affecte le temps d’image en ajoutant une surcharge supplémentaire dans les threads ou tâches critiques. À titre de test, faites en sorte qu’une tâche ou un bloc de travail choisi au hasard prenne de 25 % à 35 % de temps supplémentaire. L’ampleur de la variation du temps d’image global indique dans quelle mesure le système de tâches peut absorber les pics d’exécution. La situation idéale est que les temps d’image ne changent presque pas. Cela signifie que le système peut absorber des pics arbitraires de temps d’image. Les pics proviennent soit de l’exécution sur un cœur moins performant, soit d’un autre processus aléatoire du système qui utilise du temps processeur.Communication entre threads
Il faut réfléchir à la communication entre threads au moyen de primitives de verrouillage. La surcharge d’un changement de contexte est étroitement liée au C-State du cœur récepteur avant que le nouveau thread commence à s’exécuter. Le cœur doit être en C0, l’état d’exécution, avant que le nouveau thread puisse commencer à s’exécuter. Le cas le moins coûteux est celui où le cœur était déjà en cours d’exécution, donc déjà en C0. Toutefois, si le cœur est inactif, il se trouve dans un C-State inférieur. Le niveau du C-State correspond à des niveaux de veille plus profonds. Une veille plus profonde réduit la consommation d’énergie du cœur. En revanche, il est plus coûteux de se réveiller et de recommencer à s’exécuter à partir d’une veille plus profonde. Le C-State de faible consommation le plus courant est C1, qui peut ajouter une surcharge de 2 à 7 μs. Le C-State suivant, C2, peut ajouter une surcharge d’environ 40 à 100 μs. Le chiffre exact dépend de l’IHV et du SoC. De nombreuses variables déterminent le C-State dans lequel se trouve un cœur inactif; il s’agit d’un équilibre entre réactivité et consommation d’énergie. Un C-State inférieur consomme moins d’énergie qu’un C-State supérieur. Il est courant qu’un cœur entre d’abord en C1, puis passe en C2 s’il n’a pas exécuté de code depuis un certain temps. Une autre préoccupation se pose : que se passe-t-il lorsque le thread qui soumet la tâche et le thread qui l’exécute se trouvent sur des cœurs ayant des profils de performances différents? Techniquement, il est possible que le thread de tâches termine les tâches plus rapidement que les nouvelles tâches ne sont créées. Cette situation est plus susceptible de se produire si le thread qui exécute la tâche se trouve sur un cœur plus rapide que le thread qui soumet les tâches. Si une tâche prend moins de temps à s’exécuter qu’à être créée, le titre peut se retrouver dans une situation où un thread de tâches est constamment suspendu en attente de nouvelles tâches. L’effet net est que l’exécution des tâches devient plus coûteuse, puisque le thread de tâches est constamment suspendu. Le coût de la surcharge d’un changement de contexte s’ajoute au temps d’exécution de chaque tâche. Cette surcharge peut paradoxalement entraîner des fréquences d’images plus faibles lors de l’exécution sur des cœurs plus performants. Par exemple, un travail qui prenait 250 μs peut soudainement prendre 275 μs; cette régression représente une baisse de performances de 10 %. En raison de ce cas, la recommandation est de soumettre plutôt les tâches par lots au lieu de les soumettre au fur et à mesure de leur création. Par exemple, si le système suit un modèle où il construit une tâche, la soumet, construit une tâche, la soumet, etc., ce modèle devrait être modifié pour effectuer d’abord un lot de constructions, puis les soumettre toutes en même temps. Si le titre utilise un objet qui nécessite WaitForSingleObject, celui-ci devrait être placé dans une petite boucle d’attente active (spin). Appelez la fonction avec un délai d’expiration de 0, puis, une fois la boucle terminée, utilisez la valeur de délai d’expiration normale du titre. La meilleure solution à ce problème est toutefois d’utiliser des API de synchronisation modernes comme les verrous SRW (Slim Reader/Writer), les sections critiques et WaitOnAddress. Ces API de synchronisation comprennent toutes une forme d’attente active interne, ce qui peut empêcher un thread d’être constamment suspendu. Cette attente active est particulièrement utile pour les verrous détenus pendant une courte période. Il est important d’éviter les longs verrous tournants (spin locks). C’est le cas, par exemple, d’un modèle où les threads tournent constamment en attendant du travail à effectuer. Si un autre travail doit être effectué sur le cœur, le planificateur finira par suspendre le thread en attente active pour effectuer ce travail. Lorsque cette préemption se produit, il est fort probable que le thread suspendu le reste pendant une période importante. Ce comportement vise à éviter la privation des autres threads. Comme le titre a peu de contrôle sur le moment de la suspension, cela peut entraîner des saccades dans la fréquence d’images.Systèmes de tâches
Pour obtenir les meilleures performances, structurez le moteur autour de tâches plutôt que de compter sur des threads dédiés de longue durée critiques pour l’image. Par exemple, un modèle de threads Simulation/Rendu crée deux threads persistants critiques pour l’image. Toutefois, des tâches longues peuvent faire en sorte que n’importe quel thread de tâches se comporte comme un thread critique pour l’image. Si une tâche prend 10 ms, le thread qui l’exécute devient critique pour l’image pendant cette période, quel que soit son rôle d’origine.Vol de travail
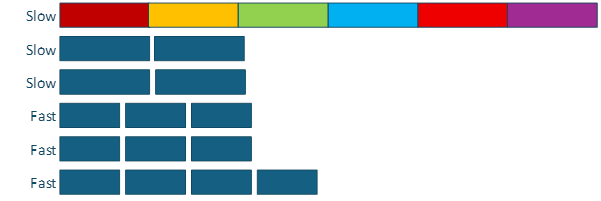
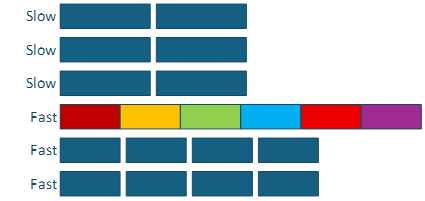
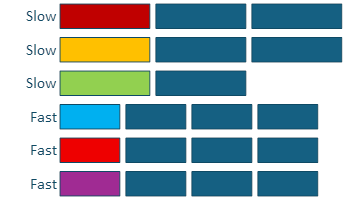
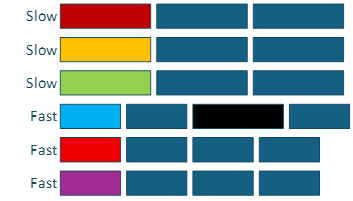
La recommandation principale est d’utiliser le vol de travail dans l’ensemble du système de tâches et de laisser tous les threads critiques pour l’image participer à l’algorithme de vol de travail. Par exemple, si le thread de rendu attend la fin de tâches liées au rendu, il devrait exécuter certaines de ces tâches. Ce comportement est déjà une pratique courante dans de nombreux moteurs de jeu. Toutefois, il vaut la peine de le mentionner ici, car ce type de comportement est essentiel pour que le moteur de jeu puisse absorber les pics d’images causés par les cœurs hétérogènes et une éventuelle préemption par le système d’exploitation. Lorsqu’une tâche prend plus de temps à s’exécuter, le risque de pic de temps d’image augmente. Ce comportement peut être causé soit par l’exécution de la tâche sur un cœur moins performant, soit par d’autres travaux sur le PC. La recommandation est que le moteur vise des tâches représentant environ deux pour cent de l’image. Ce budget signifie, par exemple, un maximum d’environ 333 μs pour un jeu fonctionnant à 60 images par seconde. Au besoin, plusieurs petites tâches devraient être regroupées en une tâche plus grande pour viser ces deux pour cent. Cette approche offre un bon compromis entre la taille des tâches, la communication entre threads et la capacité d’absorber les pics. Ces exemples montrent les effets que peuvent avoir de longues tâches critiques pour l’image sur les performances du système. Dans ces exemples, chaque tâche comprend le même nombre d’opérations. Dans cet exemple, une seule tâche prend 375 μs sur un cœur lent et 250 μs sur un cœur rapide. La tâche la plus longue (long pole) est six fois plus coûteuse que les autres tâches. Le pire scénario est celui où la tâche la plus longue se retrouve sur l’un des cœurs lents. Cela peut avoir un effet considérable sur les temps d’image. Dans ce scénario, le temps total d’exécution du travail est de 2 250 μs, soit six fois 375 μs. Figure 3 : Exemple de tâche la plus longue s’exécutant sur un cœur plus lent.