ハードウェア
独立系ハードウェア ベンダー (IHV) によって、ヘテロジニアス CPU トポロジの定義は異なります。Intel と Qualcomm は Performance と Efficiency という用語を使用し、AMD は Performance と Compact という用語を使用します。各ベンダーは、コア トポロジを設計する際に、パフォーマンスと効率のトレードオフを行っています。 次の例は、関連する設計上の選択の一部を示しています。- 異なるキャッシュ サイズ
- コアによってキャッシュ サイズが異なる場合があります。
- たとえば、高性能なコアの方が L1 および L2 キャッシュが大きい場合があります。
- キャッシュの共有
- コア間でのキャッシュの共有レベルはさまざまです。
- たとえば、高性能なコアはそれぞれ専用の L2 キャッシュを持ち、効率の高いコアは 1 つの L2 キャッシュを共有する場合があります。
- 同時マルチスレッディング (SMT) のサポート
- SMT をサポートするコアもあれば、サポートしないコアもあります。
- Intel は SMT を Hyper-Threading と呼んでいます。
- コア内部のレイアウト
- コアの種類によって、内部リソースが異なる場合があります。
- たとえば、高性能なコアには、より多くの浮動小数点パイプや ALU パイプ、またはより広いデータ レーンが含まれる場合があります。
- 最大周波数
- コアの種類によって最大周波数が異なる場合があります。
- たとえば、高性能なコアは、効率の高いコアよりも高い周波数を実現できる場合があります。
パフォーマンスの数値
効率レベルの異なるコアは、それぞれ異なるパフォーマンスを示すことが予想されます。一方のコアはパフォーマンスのために設計され、もう一方は省電力のために設計されています。問題は、コア間にどの程度の違いがあるかです。 示されているデータは、複数の IHV のデータを集約したものです。各 IHV は、トポロジに関して行った選択に基づいて、テストごとに異なるスケーリングを示します。正確な数値は異なりますが、パターンはすべての IHV で類似しています。また、CPU の世代ごとに異なるトレードオフが行われるため、相対的な数値も変わります。既存のすべての IHV と世代にわたる数値を作成することは、この記事の範囲外です。合成テスト
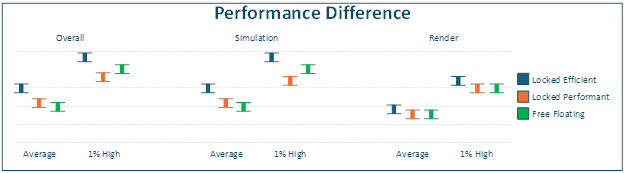
ベクトル演算は、ゲーム タイトルがフレーム内で行う作業の大部分を占めます。このワークロードには、物理演算から AI、レンダリングまで、あらゆるものが含まれます。ゲームは、単一の 128 ビット SSE レジスタに収まる 3 つまたは 4 つの float を持つベクトル型を使用して、この作業を実行します。これらは、内積、行列乗算、平方根の計算、ベクトル変換など、幅広い演算にわたります。これらの演算のパフォーマンスの違いは、全体的なフレーム時間に大きな影響を与える可能性があります。 次のグラフは、7 つの一般的な数学演算を実行する相対的なコストを示しています。測定には、単一の 128 ビット SSE レジスタに格納された 4 つの 32 ビット浮動小数点値のベクトルを使用しています。行列は 4 つのベクトルで構成され、4 つの 128 ビット SSE レジスタにわたって合計 16 個の 32 ビット浮動小数点値を持ちます。これらの演算は、フレーム内で一般的に使用されるため選択されました。- 内積: ベクトルの内積を計算します。
- ベクトルの変換: ベクトルに行列を乗算して変換します。
- ベクトルの加算: 2 つのベクトルを加算します。
- 外積: 2 つのベクトルの外積を計算します。
- ベクトルの正弦: ベクトルの各要素について正弦の近似値を計算します。
- ベクトル FMA (融合積和演算): 2 つのベクトルを乗算し、3 つ目のベクトルを加算します。
- 逆平方根: ベクトルの長さの逆平方根を計算します。
実際の環境
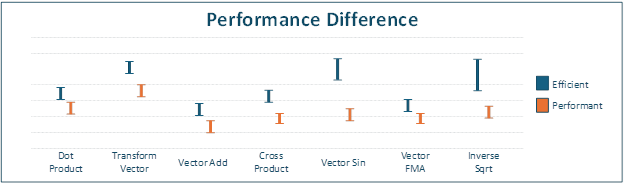
前述の数値は、特定のベンチマークを個別に示したものであり、全体像の一部しか示していません。次の数値は、2 つのメイン スレッド (Simulation と Render) と一連のジョブ スレッドを使用する AAA ゲーム エンジンのベンチマークから得られたものです。このベンチマークでは、3 つのテスト構成を使用します。- 2 つのメイン スレッドは、高性能なコアでのみ実行されます。
- 2 つのメイン スレッドは、効率の高いコアでのみ実行されます。
- 2 つのメイン スレッドは、システム内のすべてのコアで実行されます。
各メーカーは、これらのスケジューラのヒューリスティックを調整して、自社のハードウェアに合わせることができます。たとえば、AMD には Workload Profile Scheduling があり、Intel には Thread Director テクノロジがあります。また、各 IHV は、SoC の特定のトポロジに合わせてヒューリスティックを調整する傾向があります。
推奨事項
スレッド アフィニティ
効率クラスが 1 つだけのデスクトップ マシンで実行する場合のスレッド アフィニティに関するアドバイスは、厳密なスレッド アフィニティを設定せず、スレッドがすべてのコアを自由に移動できるようにすることです。この不確実性の主な理由は、ユーザーのマシンで他にどのようなプロセスが実行されているかを事前に知ることができないためです。厳密なアフィニティを持つスレッドが、システム内の別の高優先度スレッドとコアを共有することになる可能性があります。最終的な効果として、タイトルのスレッドは実行時間が不足します。この競合がフレームにとって重要なスレッドで発生すると、タイトルのフレーム時間が不安定になる可能性があります。OS がタイトルのスレッドを移動して実行を継続できる場所を確保しておく必要があります。 ただし、ヘテロジニアス CPU で実行する場合は、このアドバイスを変更する必要があります。主な理由は、OS がタイトルのどのスレッドやジョブがフレームにとって重要であるかを必ずしも把握していないためです。OS にはフレームにとって重要と思われるスレッドを判断するためのヒューリスティックがありますが、それでも誤った選択をする可能性があります。それらのスレッドやジョブのいずれかを性能の低いコアに移動することを決定し、その結果、タイトルでパフォーマンスの問題が発生する可能性が高くなる場合があります。 推奨事項は、タイトルのスレッドが最低でも 3 ~ 4 個のコアで実行できるようにすることを目標とし、それ以上が望ましいということです。たとえば、高性能なコアが 1 つと性能の低いコアが 3 つあるローエンド システムでは、スレッドがすべてのコアを自由に移動できるようにする必要があります。高性能なコアが 3 つ以上あるマシンでは、フレームにとって重要なスレッドをそれらの高性能なコアのみに制限できます。 SMT もサポートする多数のコアを備えたハイエンド マシンでは、一部のタイトルがスレッドを物理コアに固定しようとする場合があります。この手法により、複数の高優先度スレッドが物理コアの同じリソースを共有する際の、物理コア レベルでの競合を回避できます。ただし、一般的には、このケースを検討することはお勧めしません。OS はすでにこの動作をシステム全体に適用しています。OS は最初に物理コア間でスレッドをスケジュールし、必要な場合にのみ追加の論理コアを使用します。 タイトルが検討すべき唯一のケースは、タイトルの重要なスレッドをサポートするのに十分な数の高性能なコアがシステムにある場合です。この場合、フレームにとって重要なスレッドを高性能なコアに固定することが望ましい場合があります。ただし、それらのスレッドは、すべての高性能なコアを自由に移動できるようにする必要があります。場合によっては、すべてのスレッドがすべてのコアを自由に移動できるようにするとパフォーマンスが向上することがありますが、この動作はすべての CPU メーカーで一貫しているわけではありません。 タイトルが、すべてのスレッドにわたってワークロードを完全に分散できるワーク スティーリング システムを実装している場合、どのジョブ スレッドもすべてのコアを自由に移動できるようにする必要があります。高優先度のジョブ スレッドか低優先度のジョブ スレッドかは関係ありません。ワーク スティーリング アルゴリズムが自動的に負荷を分散し、最短時間で最も多くの作業を完了できるようにします。高性能なコア上のスレッドは、フレーム中により多くのジョブを実行します。 フレームにとって重要なスレッドが複数ある場合は、フレームにとって重要な 2 つのスレッドが同じコアで実行されないようにアフィニティを設定すると便利な場合があります。たとえば、フレームにとって重要なスレッドが 2 つある場合、それらのアフィニティを互いの排他的論理和に設定すると、OS によってスレッドが互いに競合する可能性がなくなります。ただし、これも、フレームにとって重要な各スレッドが最低でも 3 ~ 4 個のコアを自由に移動できるようにしたうえで、このケースをサポートするのに十分なコアがある場合にのみ、このオプションを検討してください。スレッド トポロジ
ヘテロジニアス環境でスレッドに作業を割り当てる方法を検討する際、主なデータとなるのは、さまざまなタスクの長さと、それらが互いにどのように相互作用するかです。各タスクの平均的な長さはどのくらいか、タスク間の依存関係は何か、各タスクの優先度は何か、などです。 重要なスレッドやジョブで発生する時間の急増を、ジョブ スレッドはどの程度吸収できるでしょうか。それらのスレッドやジョブのいずれかの実行が 35% 遅くなった場合、フレーム時間にどの程度影響するでしょうか。たとえば、タスクの実行が長引いた場合、この遅延はフレームの残りの部分にどの程度影響するのか、そのタスクが完了するまでシステムは停止するのか、などです。 重要なスレッドやジョブに追加のオーバーヘッドを加えることで、ヘテロジニアス システムがフレーム時間にどの程度影響するかを判断すると便利な場合があります。テストとして、ジョブまたは作業ブロックの所要時間をランダムに 25% ~ 35% 増やしてみます。全体的なフレーム時間の変化の度合いは、ジョブ システムが実行の急増をどの程度吸収できるかを示します。理想的な状況は、フレーム時間がほとんど変化しないことです。これは、システムがフレーム時間の任意の急増を吸収できることを意味します。急増は、性能の低いコアでの実行、またはシステム内の別のランダムなプロセスによる CPU 時間の使用から発生します。スレッド間の通信
ロック プリミティブを使用したスレッド間の通信については、ある程度の検討が必要です。コンテキスト スイッチのオーバーヘッドは、新しいスレッドの実行が開始される前の受信側コアの C ステート と密接に結びついています。新しいスレッドの実行を開始する前に、コアは実行状態である C0 になっている必要があります。最もコストが低いのは、コアがすでに実行中で、すでに C0 にある場合です。しかし、コアがアイドル状態の場合は、より低い C ステートにあります。C ステートのレベルは、より深いスリープ レベルに対応します。スリープが深いほど、コアの消費電力は少なくなります。しかし、より深いスリープから復帰して再び実行を開始するには、より多くのコストがかかります。最も一般的な低電力 C ステートは C1 で、2 ~ 7 μs のオーバーヘッドが加わる可能性があります。次の C ステートである C2 では、約 40 ~ 100 μs のオーバーヘッドが加わる可能性があります。正確な数値は IHV と SoC によって異なります。アイドル時にコアがどの C ステートになるかを制御する変数は多数あり、応答性と消費電力のバランスで決まります。低い C ステートは、高い C ステートよりも消費電力が少なくなります。コアが最初に C1 に入り、しばらくコードを実行していない場合に C2 に切り替わるのが一般的です。 もう 1 つの懸念事項は、ジョブを送信するスレッドとジョブを実行するスレッドが、パフォーマンス プロファイルの異なるコア上にある場合に何が起こるかです。技術的には、ジョブ スレッドが新しいジョブの作成よりも速くジョブを完了することがあり得ます。この状況は、ジョブを実行するスレッドが、ジョブを送信するスレッドよりも高速なコア上にある場合に発生しやすくなります。 ジョブの実行にかかる時間が作成にかかる時間よりも短い場合、タイトルは、ジョブ スレッドが新しいジョブを待機して常に中断するという状況に陥る可能性があります。最終的な効果として、ジョブ スレッドが常に中断するため、ジョブの実行コストが高くなります。各ジョブの実行時間に、コンテキスト スイッチのオーバーヘッド コストが加算されます。このオーバーヘッドにより、逆説的に、高性能なコアで実行するとフレーム レートが低下する可能性があります。たとえば、以前は 250 μs かかっていた作業が突然 275 μs かかるようになることがあり、この低下はパフォーマンスの 10% 低下に相当します。 このケースがあるため、ジョブは作成されるたびに送信するのではなく、バッチで送信することをお勧めします。たとえば、システムがジョブを構築し、ジョブを送信し、ジョブを構築し、ジョブを送信する、というパターンに従っている場合です。このパターンを調整して、まず一連の構築を実行し、その後すべてを同時に送信するようにする必要があります。 タイトルが WaitForSingleObject を必要とするオブジェクトを使用している場合は、小さなスピン ループ内に配置する必要があります。タイムアウト 0 で関数を呼び出し、スピンが完了したら、タイトルの通常のタイムアウト値を使用します。ただし、この問題に対する最善の解決策は、Slim Reader/Writer (SRW) ロック、クリティカル セクション、WaitOnAddress などの最新の同期 API を使用することです。これらの同期 API はすべて、内部に何らかの形式のスピンを含んでおり、スレッドが常に中断するのを防ぐことができます。このスピンは、短時間保持されるロックで特に役立ちます。 長いスピン ロックは避けることが重要です。たとえば、スレッドが実行する作業を待機して常にスピンするパターンです。コア上で実行する必要のある他の作業がある場合、スケジューラは最終的にスピンしているスレッドを中断してこの作業を実行します。このプリエンプションが発生すると、中断されたスレッドがかなりの時間中断されたままになる可能性が高くなります。この動作はすべて、他のスレッドのリソース不足を防ぐために行われます。タイトルは中断のタイミングをほとんど制御できないため、フレーム レートのスタッターにつながる可能性があります。ジョブ システム
最高のパフォーマンスを得るには、専用の長時間実行されるフレームにとって重要なスレッドに依存するのではなく、ジョブを中心にエンジンを構成します。たとえば、Simulation/Render スレッド モデルでは、フレームにとって重要な永続的なスレッドが 2 つ作成されます。しかし、長いジョブがあると、どのジョブ スレッドもフレームにとって重要なスレッドとして動作する可能性があります。ジョブに 10 ms かかる場合、元の役割に関係なく、そのジョブを実行するスレッドはその期間中フレームにとって重要になります。ワーク スティーリング
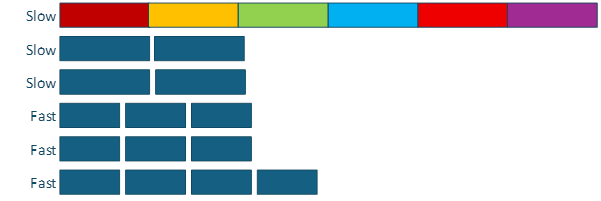
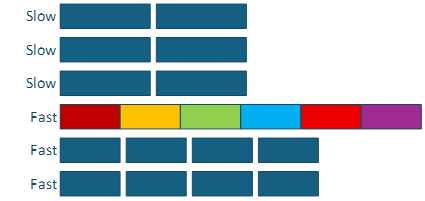
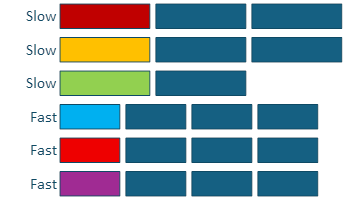
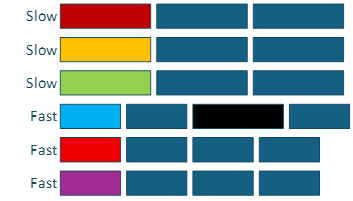
最も重要な推奨事項は、ジョブ システム全体でワーク スティーリングを使用し、フレームにとって重要なスレッドをワーク スティーリング アルゴリズムに参加させることです。たとえば、レンダー スレッドがレンダリング関連のジョブの完了を待機している場合は、それらのジョブの一部を実行する必要があります。 この動作は、多くのゲーム エンジンですでに一般的な手法です。しかし、この種の動作は、ヘテロジニアス コアや OS によるプリエンプションの可能性に起因するフレームの急増をゲーム エンジンが吸収できるようにするために重要であるため、ここで言及しておく価値があります。 ジョブの実行に時間がかかると、フレーム時間の急増のリスクが高まります。この動作は、ジョブが性能の低いコアで実行されていること、または PC 内の他の作業によって発生する可能性があります。推奨事項は、エンジンが 1 つのジョブにかかる時間をフレームの約 2% にすることを目指すことです。この予算は、たとえば 60 fps で実行されるゲームでは約 333 μs 以下であることを意味します。必要に応じて、2% という数値を目指して、複数の小さなジョブを大きなジョブにバッチ処理する必要があります。このアプローチにより、ジョブのサイズ、スレッド間の通信、急増を吸収する能力の間で適切なトレードオフが得られます。 次の例は、フレームにとって重要な長いジョブがシステム パフォーマンスに与える影響を示しています。これらの例では、各ジョブは同じ数の演算で構成されています。この例では、1 つのジョブが低速なコアで 375 μs、高速なコアで 250 μs かかります。ロング ポール ジョブは、他のジョブよりも 6 倍コストが高くなります。 最悪のケースは、ロング ポール ジョブが低速なコアのいずれかで実行される場合です。これは、フレーム時間に大きな影響を与える可能性があります。このシナリオでは、作業の実行にかかる合計時間は 375 μs の 6 倍である 2,250 μs になります。 図 3: 低速なコアで実行されるロング ポールの例。