Passer au contenu principal
Data Connections permet l’ingestion continue et en quasi temps réel des données PlayStream et de télémétrie dans votre ressource de stockage autorisée de votre abonnement Azure. Cette fonctionnalité fonctionne avec Azure Blob Storage, Azure Data Explorer (ADX), les bases de données KQL Microsoft Fabric et Amazon Web Services S3. Elle vous permet de contrôler vos données dans votre compte de stockage avec une latence d’ingestion inférieure à cinq minutes. L’architecture est conçue pour le traitement par lots et prend en charge les fichiers Parquet dans Blob Storage, avec un débit plus élevé, un coût de stockage plus faible et une plus grande flexibilité. En cas d’échec de distribution des données, un mécanisme intégré de nouvelle tentative automatique permet de garantir que les données sont bien livrées. Vous pouvez commencer à utiliser Data Connections pour l’ingestion d’événements via le portail Game Manager de PlayFab ou les API évolutives.
Bien que vous puissiez utiliser ADX, Blob ou Fabric KQL, ces options répondent à des cas d’usage potentiels différents. Vous pourriez préférer Blob si vous utilisez Synapse pour la modélisation ML et le traitement par lots, tandis qu’ADX prend en charge l’analytique ad hoc, les requêtes et le débogage en temps réel des services en production.
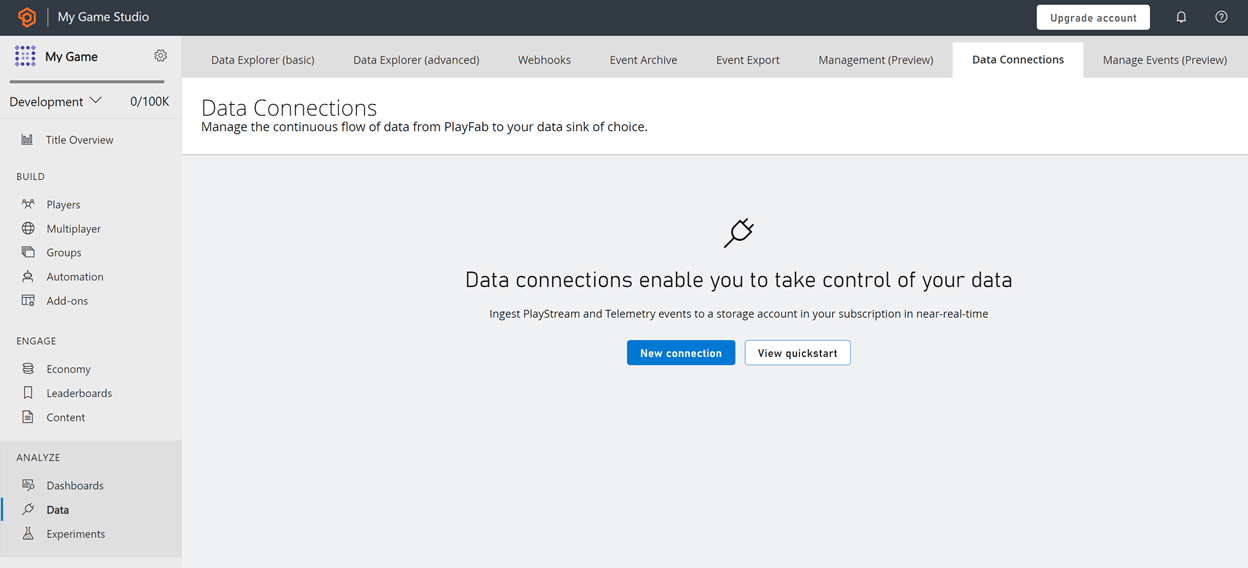
Capture d’écran de la vue d’ensemble de Data Connections

Pourquoi en avez-vous besoin ?

Data Connections remplace les fonctionnalités Event Export et Export to S3 actuellement prises en charge par PlayFab. Elle permet une exportation plus rapide dans les formats pris en charge pour le traitement hors ligne. Vous fournissez le compte de stockage dans lequel les données sont ingérées et livrées. Cela signifie que vous contrôlez le chiffrement au repos, la gestion du cycle de vie et l’accès réseau. La facturation est simplifiée, car les coûts de stockage sont inclus de manière centralisée dans la facturation globale de votre compte Azure.

Data Connection Azure Blob

Les données sont directement disponibles au format blob Parquet. Parquet est un format de fichier de données orienté colonnes, conçu pour un stockage et une récupération efficaces des données. Il offre des schémas de compression et d’encodage efficaces, avec des performances améliorées pour traiter des données complexes en masse, ce qui se traduit par une faible latence, un débit plus élevé et un faible coût de stockage des données. Il est conçu pour être un format d’échange commun pour les charges de travail par lots et interactives. Blob Storage est donc bien adapté au traitement hors ligne ainsi qu’à l’analytique et aux rapports optimisés en coûts (y compris les requêtes ad hoc sur les fichiers stockés).

Data Connection Azure Data Explorer

Data Connections vous permet d’exporter vers Azure Data Explorer pour une ingestion et une distribution de vos données en quasi temps réel. Azure Data Explorer peut interroger des millions d’enregistrements en quelques secondes, ce qui vous permet d’obtenir des insights précieux et de prendre des décisions éclairées rapidement et efficacement. Pour optimiser davantage les coûts et le contrôle des données, vous pouvez utiliser Data Connections avec l’échantillonnage d’événements (Event Sampling). L’échantillonnage vous permet de configurer le pourcentage de données d’événements que vous souhaitez recevoir.

Data Connection de base de données KQL Microsoft Fabric

Utilisez les Data Connections de PlayFab pour envoyer des événements de jeu vers des bases de données Real-Time Analytics (RTA), afin de générer des insights en quasi temps réel dans Power BI ou d’exécuter des requêtes KQL dans votre espace de travail Microsoft Fabric.

Data Connection Amazon AWS S3 (PRÉVERSION)

La Data Connection AWS S3 offre un moyen sécurisé et évolutif de diffuser vos données de télémétrie et d’événements PlayFab directement dans votre propre compartiment Amazon S3. Conçue pour la fiabilité et les charges de travail à haut débit, elle utilise un pipeline robuste pour valider, transporter et déposer les données de jeu dans un format ouvert, prêt pour l’analytique. En utilisant votre propre stockage AWS et vos propres rôles IAM, vous gardez le contrôle sur la gouvernance des données, le chiffrement, les stratégies d’accès, la gestion du cycle de vie et la visibilité des coûts. Cela permet également des workflows en aval tels que les rapports BI, l’apprentissage automatique et le traitement de données à grande échelle dans votre environnement AWS.
Dernière modification le 6 octobre 2026