
Ces informations étaient à jour en avril 2022. Plusieurs fonctionnalités ont été modifiées ou mises à jour depuis.
Lancer de rayons sur XBOX Series X|S
Nous avons constaté une excellente adoption de la fonctionnalité de lancer de rayons sur les consoles XBOX Series. Aujourd’hui, plus de 20 titres sont commercialisés avec la prise en charge du lancer de rayons sur XBOX Series X. Plusieurs de ces titres ont ensuite pris en charge le lancer de rayons sur XBOX Series S. Les effets simples comme les ombres et l’occlusion ambiante sont courants, et certains titres ont également implémenté des réflexions et l’illumination globale. Lors de Xfest 2019, le GDK de novembre 2019 venait d’être publié et aucun titre ne fonctionnait avec le lancer de rayons. Fin 2020, seuls trois titres fonctionnaient sur le GDK d’août 2020. Depuis, plusieurs améliorations ont été apportées au runtime. Nous comprenons désormais beaucoup mieux ce qu’il faut pour obtenir de bonnes performances de lancer de rayons sur nos consoles.Générateur de BVH au runtime
Le générateur de BVH (hiérarchie de volumes englobants) au runtime s’exécute sur le GPU ; il consomme donc du temps GPU qui serait autrement utilisé pour la rastérisation ou le lancer de rayons. À ce jour, tous les titres utilisent le générateur de BVH au runtime pour construire leur structure d’accélération de niveau supérieur (TLAS). Ils effectuent des reconstructions complètes à chaque image ; n’essayez donc pas de mettre à jour une TLAS. Pour les structures d’accélération de niveau inférieur (BLAS), environ la moitié des titres utilisent encore le générateur de BVH au runtime pour la géométrie statique. L’autre moitié utilise le générateur de BVH hors ligne. Pour la géométrie dynamique, tous les titres continuent d’utiliser le générateur de BVH au runtime, car c’est la seule option. Les performances de construction du générateur de BVH au runtime sont excellentes dès le départ. Il a été comparé aux GPU NVIDIA et AMD sur PC et offre d’excellentes performances. Les développeurs ont indiqué qu’ils souhaitaient une API de construction explicitement groupée, dans laquelle plusieurs structures d’accélération sont construites simultanément pour de meilleures performances GPU. Selon les retours des développeurs, les performances ont été multipliées par au moins 10, voire 20. Pour comprendre d’où proviennent ces gains de vitesse, il est important de comprendre le fonctionnement du générateur de BVH au runtime. La construction d’une BVH n’est pas un dispatch unique, ni même deux dispatchs. Il s’agit d’une série de nombreux dispatchs, tous exécutés les uns après les autres avec des barrières de vue d’accès non ordonné (UAV) entre eux. En fournissant toutes vos constructions de niveau inférieur dans un seul appel d’API, celles-ci peuvent être planifiées plus efficacement, ce qui réduit le nombre de barrières UAV au cours de cette phase. Figure 1. Diapositive 8.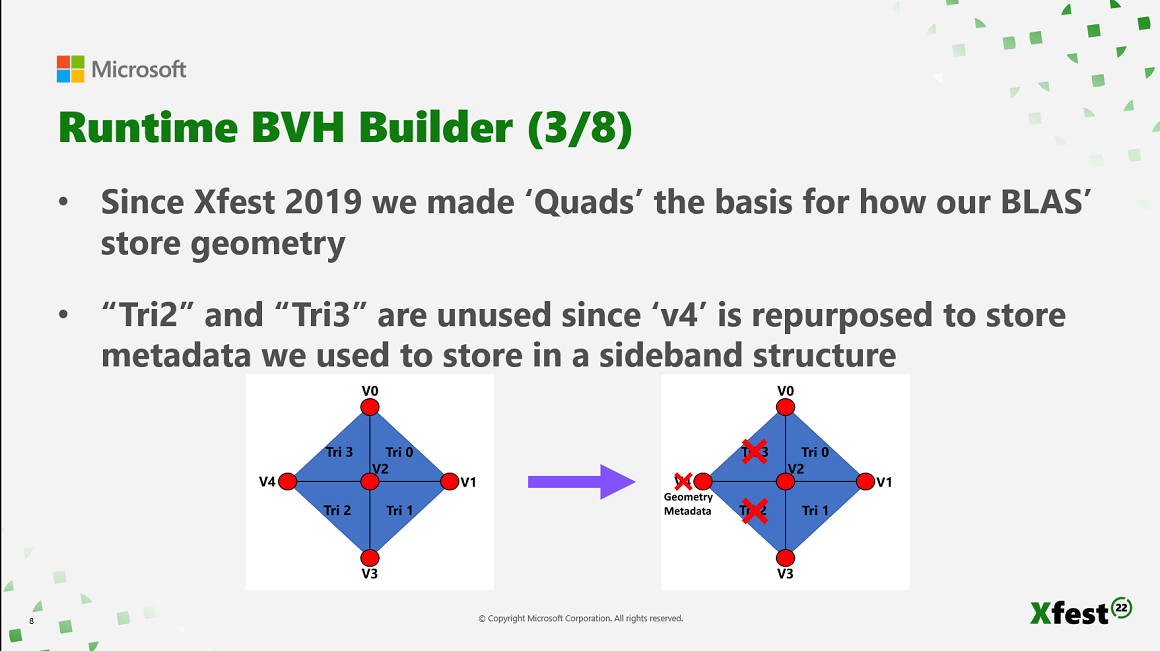
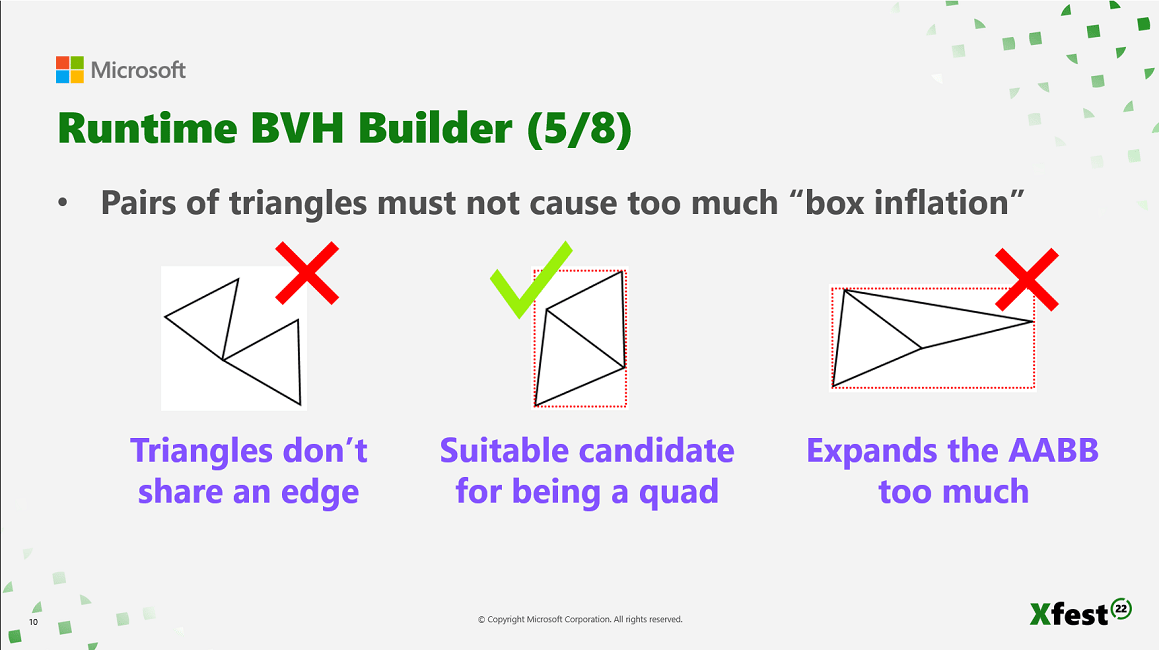
Reconstruction de treelets
Le générateur au runtime utilise une BVH linéaire (LBVH). Elle est facile à paralléliser et constitue un bon candidat pour une implémentation sur le GPU. Sous sa forme brute, la qualité d’une LBVH peut être médiocre. Pour améliorer la qualité de ces BVH, un processus de post-reconstruction de treelets est exécuté. Si les détails vous intéressent, consultez Fast Parallel Construction of High-Quality Bounding Volume Hierarchies. Ce processus permute les sous-arbres de la BVH pour améliorer l’heuristique de surface. Cela améliore à son tour les performances du parcours.Top-level Acceleration Structure Pull Up (TAPU)
Une autre option du générateur de BVH au runtime, liée à la TLAS, est le Top-level Acceleration structure Pull Up (TAPU). Dans la TLAS, les limites d’instances sont grandes et se chevauchent. Les caméras se trouvent souvent à l’intérieur des instances ; les origines des rayons se trouvent donc à l’intérieur des limites d’instances. Par conséquent, il devient difficile pour le code de parcours de suivre le meilleur chemin dans la BVH lors du parcours. Le matériel teste le rayon contre quatre boîtes simultanément et renvoie ces quatre intersections triées par distance. Si les rayons se trouvent à l’intérieur des quatre boîtes, la distance jusqu’à l’intersection est nulle dans tous les cas. L’ordre renvoyé est inconnu, mais vous avez besoin de limites d’instances qui épousent étroitement la géométrie. C’est là que l’optimisation TAPU s’applique et améliore la situation. Figure 3. Diapositive 17.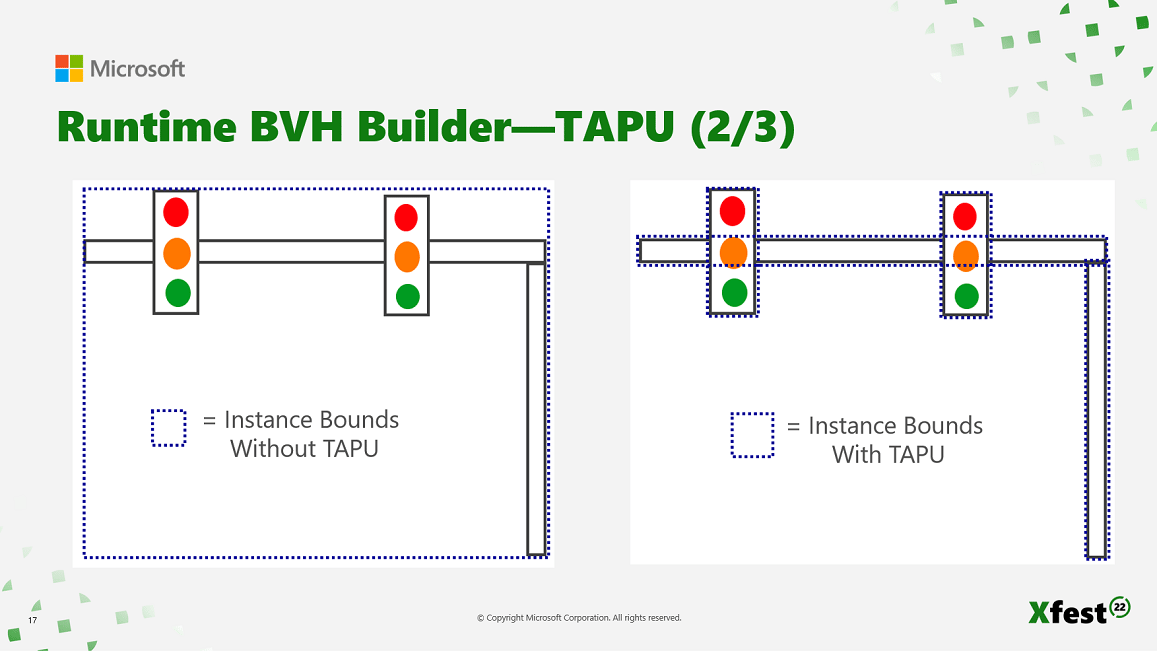
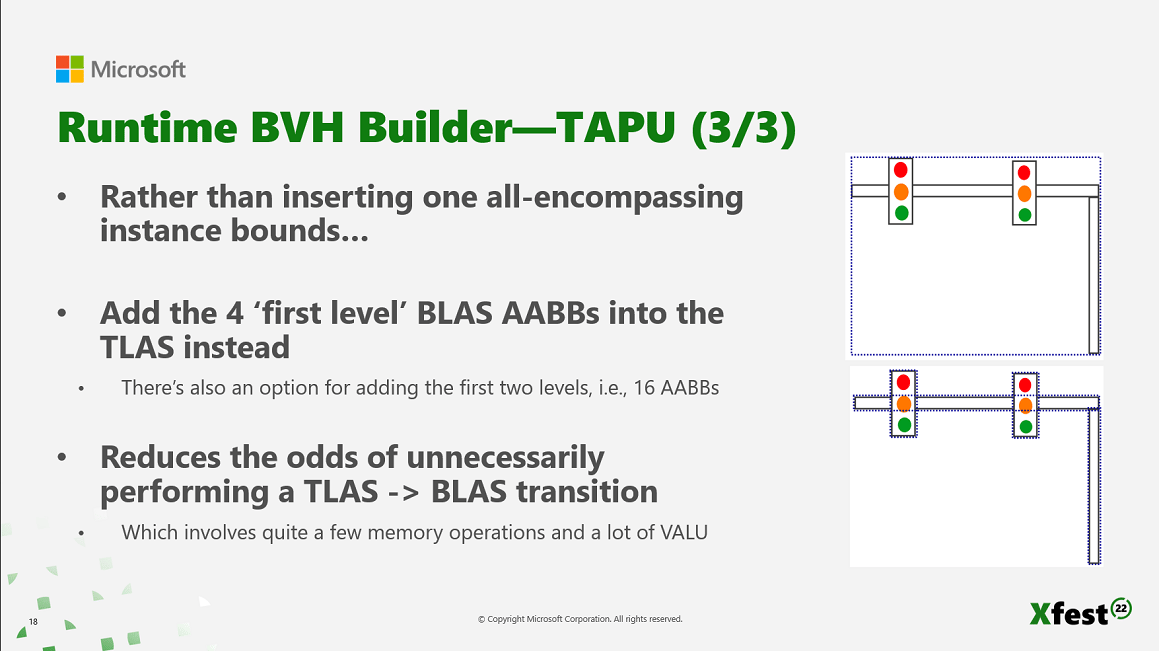
Générateur de BVH hors ligne
Le générateur de BVH hors ligne n’était pas disponible au lancement de XBOX Series X|S, mais il a été ajouté en 2020. Si vous avez publié vos titres sur PC, vous avez utilisé l’API standard pour construire les BVH. Le format de BVH vous est totalement opaque en tant que développeur. Il n’existe aucun moyen de construire vos BVH hors ligne, de les placer sur un disque optique ou dans votre téléchargement numérique, puis de faire télécharger aux clients des BVH préconstruites. Il existe sur PC une API permettant de construire une BVH au runtime, de la mettre en cache sur un disque dur, puis de la recharger. Comme la vitesse du disque dur peut être faible et que ces BVH peuvent être invalidées par des mises à jour de pilotes, l’intérêt de cette approche est assez limité. Comme les consoles XBOX Series sont des plateformes fixes et disposent d’un stockage SSD haute vitesse, nous pouvons construire nos BVH hors ligne, puis les livrer sur le SSD. De la même manière que nous pouvons livrer des textures pré-swizzlées pour XBOX Series X|S, nous pouvons également préconstruire nos BVH. Le GDK de mai 2020 a ajouté la prise en charge du générateur de BVH hors ligne. Il s’agit d’un processus qui s’exécute sur le CPU, et non sur le GPU. Le processus s’exécute sur un PC Windows plutôt que sur la console. Le générateur de BVH hors ligne est un générateur de classe mondiale construit sur la technologie de pointe Intel Embree. Nous travaillons avec cette technologie et pouvons convertir une BVH construite par Intel Embree en une BVH prête pour le matériel XBOX Series X|S. Aucun traitement supplémentaire n’est effectué au runtime pour utiliser cette BVH après son chargement. Actuellement, il n’est utilisé que pour les BLAS. Aucun développeur n’a encore demandé à construire une TLAS hors ligne. Ce type de construction présente peu d’intérêt. Lorsque nous avons initialement publié le générateur de BVH hors ligne en mai 2020, nous ne prenions pas en charge les constructionsBUILD_FLAG_ALLOW_UPDATE. Cela signifiait que tout ce qui était skinné, comme les personnages, les arbres et l’herbe, ne pouvait pas être construit hors ligne, car il n’y avait aucun moyen de les réajuster au runtime. Cet indicateur a été ajouté au GDK d’avril 2021 grâce à vos commentaires. Le générateur de BVH hors ligne convient désormais à tout contenu non procédural, par exemple une géométrie dont vous connaissez déjà l’apparence hors ligne. Cet indicateur peut ne pas convenir si un joueur peut modeler ou sculpter un nouveau contenu, car le développeur ne connaîtra pas son apparence hors ligne. C’est désormais le seul cas où le générateur de BVH hors ligne ne convient pas.
Utilisez cette option, car elle ne consomme pas votre budget d’image GPU de la même manière que le générateur de BVH au runtime. Le générateur de BVH hors ligne vous fait non seulement gagner du temps GPU, mais il produit également des BVH de bien meilleure qualité que le générateur de BVH au runtime. Le générateur de BVH hors ligne génère également des paires de quads quasi parfaites. Contrairement au générateur de BVH au runtime, où un seul thread analyse deux triangles adjacents, le générateur de BVH hors ligne effectue une recherche complète. Si le triangle 7 doit être associé au triangle 12 pour construire le meilleur quad, c’est ce qu’il fait. De plus, aucune mémoire de travail n’est requise pour les générateurs de BVH hors ligne. Vous pouvez simplement les charger depuis le disque. Vous n’avez pas besoin d’allouer de mémoire de travail supplémentaire sur la console au runtime pour la construction.
Le générateur de BVH hors ligne ne consomme qu’une partie de votre budget d’image GPU. Au runtime, appelez CopyRaytracingAccelerationStructure avec le nouvel indicateur D3D12_RAYTRACING_ACCELERATION_STRUCTURE_COPY_MODE_DESERIALIZE. La désérialisation, qui n’est qu’un simple memcpy, s’effectue sur la chronologie GPU. Elle est beaucoup plus rapide qu’une véritable construction. À l’avenir, si vous trouvez ce coût prohibitif, un processus de désérialisation sur CPU pourrait être ajouté. Il consisterait à supprimer certains en-têtes et à apporter quelques modifications. Si vous le souhaitez, faites-le-nous savoir.
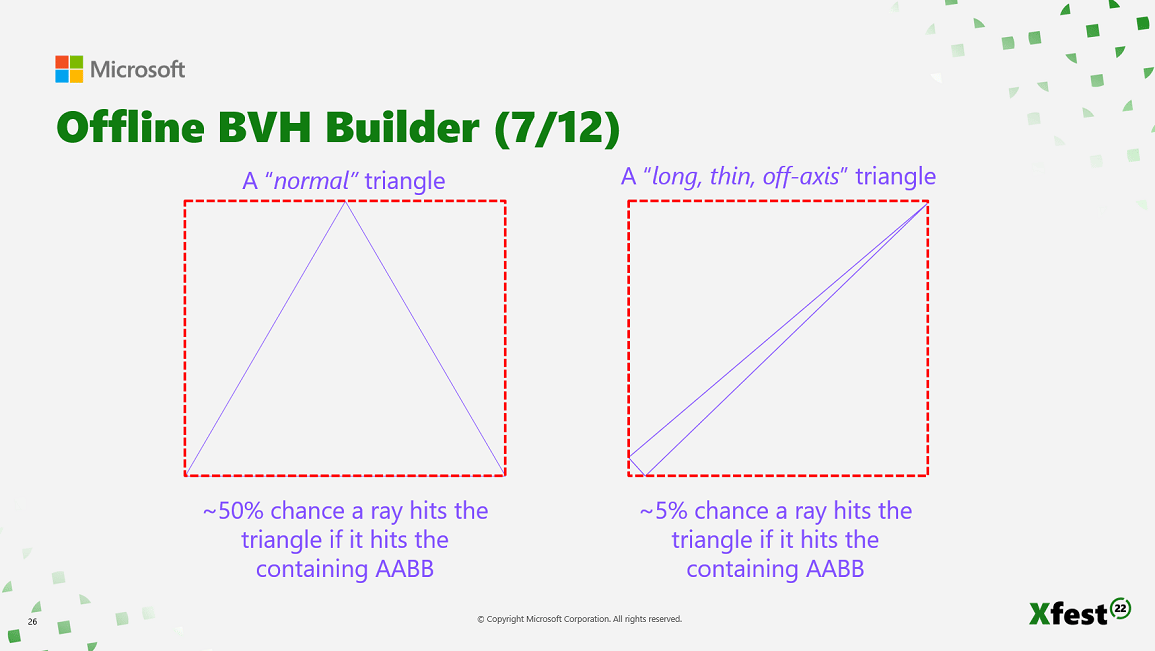
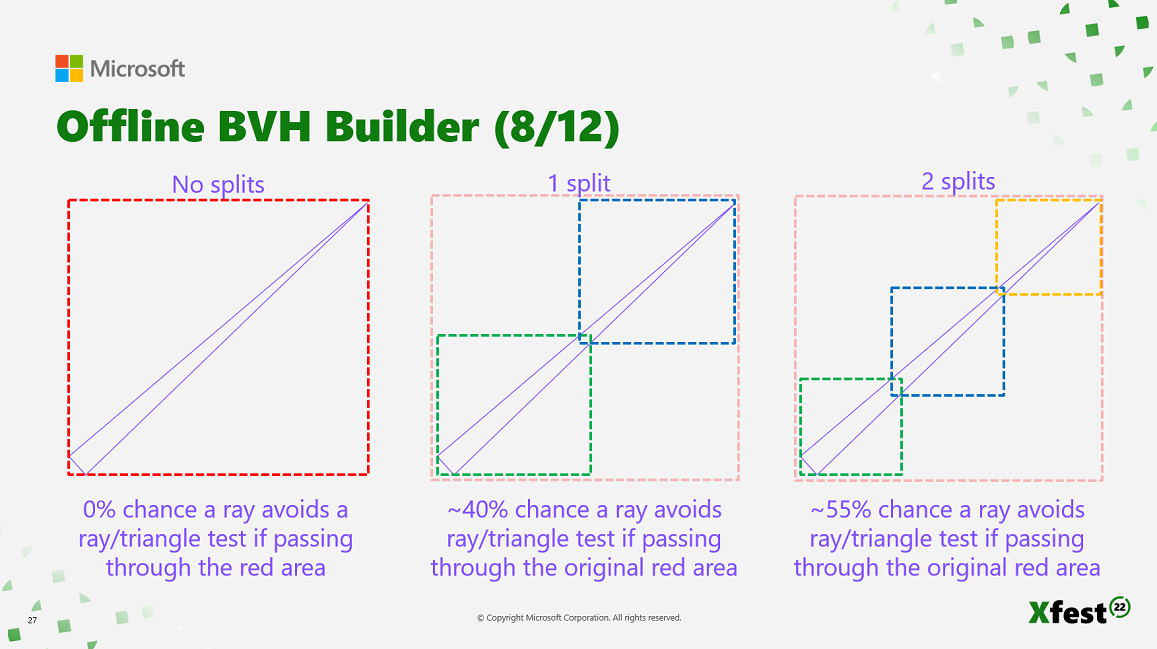
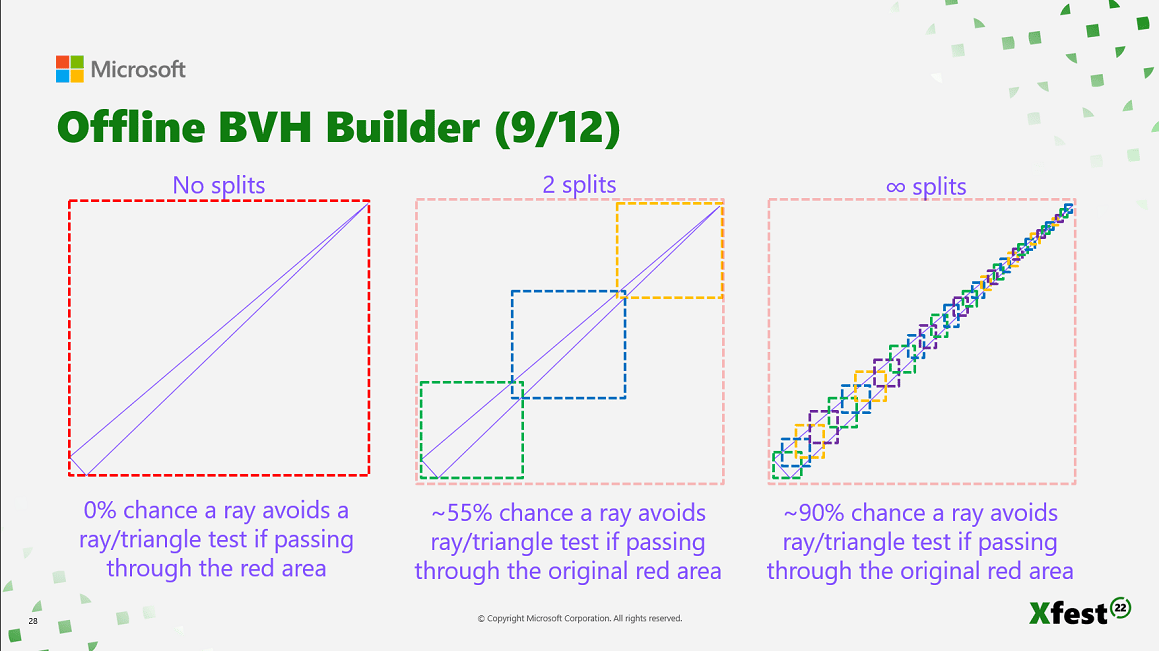
Le générateur de BVH hors ligne produit des BVH de meilleure qualité que le générateur de BVH au runtime grâce à la division des triangles. Les BVH contiennent souvent des triangles de forme irrégulière et orientés selon des angles inhabituels. Nous pouvons améliorer les performances en ajoutant des AABB supplémentaires autour de certains triangles. Cela réduit l’heuristique de surface pour obtenir un parcours plus rapide. Cela augmente la consommation de mémoire. Tenez-en compte lorsque vous décidez du degré d’agressivité avec lequel vous souhaitez appliquer cette optimisation.
Figure 5. Diapositive 26.
Compression de BVH
Les développeurs nous ont demandé de revoir la taille de nos BVH. Nous avons fourni une solution de compression dans le GDK de mars 2022. La compression de BVH vous offre une réduction de quatre à six fois de la taille de la BVH sur le disque. Le milliard de triangles que vous souhaitez livrer dans votre titre en monde ouvert ne nécessite plus que 25 Go au lieu de 140 Go. Avant que le GPU puisse accéder aux triangles, les BVH compressées doivent être décompressées. Ce processus fait intervenir le CPU. La compression de BVH ne permet pas d’économiser de la mémoire sur la console au runtime ; elle vous permet de livrer des jeux plus petits avec des tailles d’installation réduites. Une étape de compression basée sur le CPU est effectuée hors ligne sur une machine de build sur un PC Windows après la construction de la BVH hors ligne. Une étape de décompression basée sur le CPU est effectuée sur la console au runtime pour la rendre prête pour le GPU. Si vous utilisez le pilote PC XBOX Series X|S sur un PC Windows, un nouvel indicateur D3D12XBOX_RAYTRACING_ACCELERATION_STRUCTURE_COPY_MODE_SERIALIZE_AND_COMPRESS a été ajouté à l’APICopyRaytracingAccelerationStructure ; il demande la sérialisation et la compression en une seule étape. Pour la décompression au runtime sur la console, utilisez la bibliothèque XG et la nouvelle fonction XGBVHComputer::DecompressBVH. Vous utilisez peut-être déjà cette bibliothèque pour les textures.
Actuellement, la décompression au runtime s’effectue uniquement sur le CPU et elle est monothread, car les développeurs ne souhaitent généralement pas que nous gérions nous-mêmes le multithreading. En supposant un taux de compression moyen de 5:1, une entrée de 250 à 360 Mo par seconde lue depuis le SSD produit 1,2 à 1,8 Go de sortie par seconde. Comme le SSD peut lire des données jusqu’à 2 Go par seconde, un seul thread ne suffira pas à atteindre le débit de décompression requis. Si la décompression des BVH sur le CPU devient un goulot d’étranglement pour votre chargement, envisagez d’utiliser davantage de threads. Vous pouvez facilement décompresser des BVH sur 1, 2, 3 ou 4 threads simultanément pour accélérer vos temps de chargement.
DXR 1.0 + extensions
Sur XBOX Series X|S, DXR 1.0 (DirectX Raytracing) compatible PC est pris en charge tel qu’il a été publié il y a plusieurs années. La seule omission importante est l’API des shaders appelables (Callable shaders). Les développeurs ont rarement demandé cette API. DXR 1.0 est souvent utilisé par des développeurs qui ont déjà créé des titres avec lancer de rayons sur PC Windows, où le lancer de rayons fonctionne déjà, et qui souhaitent maintenant qu’il fonctionne également sur XBOX Series X|S. Bien que ce n’était pas le cas au lancement de XBOX Series X|S, de nombreux développeurs ont indiqué que cette option fonctionnait immédiatement. Ils ont appuyé sur F7, puis sur F5. Le jeu s’est exécuté et ils avaient le lancer de rayons. Bien que l’exécution d’un titre DXR 1.0 sur les consoles XBOX Series fonctionne (et ce depuis un certain temps), ce n’est pas la voie vers des performances optimales. Si vous souhaitez livrer DXR 1.0 avec votre titre, vous devrez peut-être consacrer du temps supplémentaire à l’optimiser pour XBOX Series X|S. Les extensions présentées à la figure 8 facilitent cette tâche. Figure 8. Diapositive 39.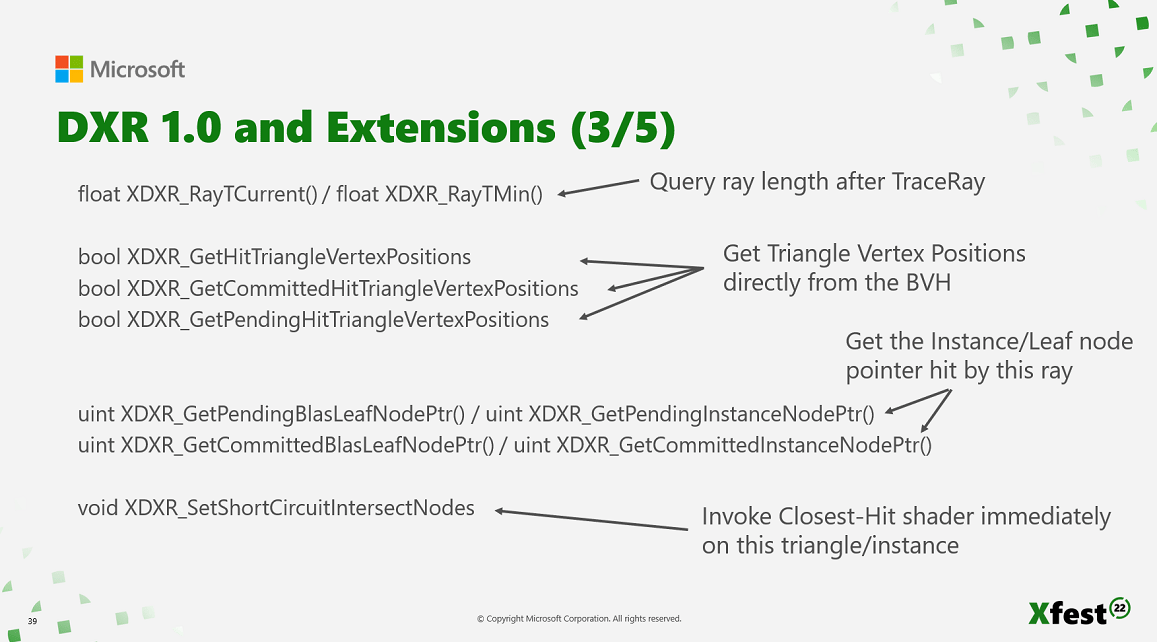
- XDXR_GetHitTriangleVertexPositions()
- XDXR_GetCommittedHitTriangleVertexPositions()
- XDXR_GetPendingHitTriangleVertexPositions()
- XDXR_GetPendingBlasLeafNodePtr()
- XDXR_GetPendingInstanceNodePtr()
- XDXR_GetCommittedBlasLeafNodePtr()
- XDXR_GetCommittedInstanceNodePtr()
TraceRay terminé. Vous n’avez pas besoin d’utiliser un shader miss ou un shader closest-hit pour replacer ces informations dans la charge utile du rayon. Pour des effets comme les ombres ou l’occlusion ambiante, vous devez savoir s’il y a eu une intersection. Vous n’avez pas besoin de connaître les informations de diffusion ni les coordonnées barycentriques. Tout ce dont vous avez besoin est un simple oui ou non. Il est inutile d’exécuter un shader miss ou un shader closest-hit et d’avoir une charge utile de 4 octets pour déterminer ce qui tiendrait en un seul bit. Deux de ces extensions peuvent être appelées après TraceRay. Vous pouvez obtenir la longueur finale du rayon et la comparer à la longueur d’origine pour savoir s’il y a eu une intersection. Vous pouvez également lire les trois positions de vertex de l’intersection validée. Au lieu de lier le vertex buffer contenant les positions à l’appel DispatchRays, puis de lire votre propre structure de données, ces positions de vertex sont renvoyées directement depuis la BVH. Cela peut vous faire économiser de la mémoire. Vous pouvez vous débarrasser de votre copie du vertex buffer.
Figure 9. Diapositive 41.
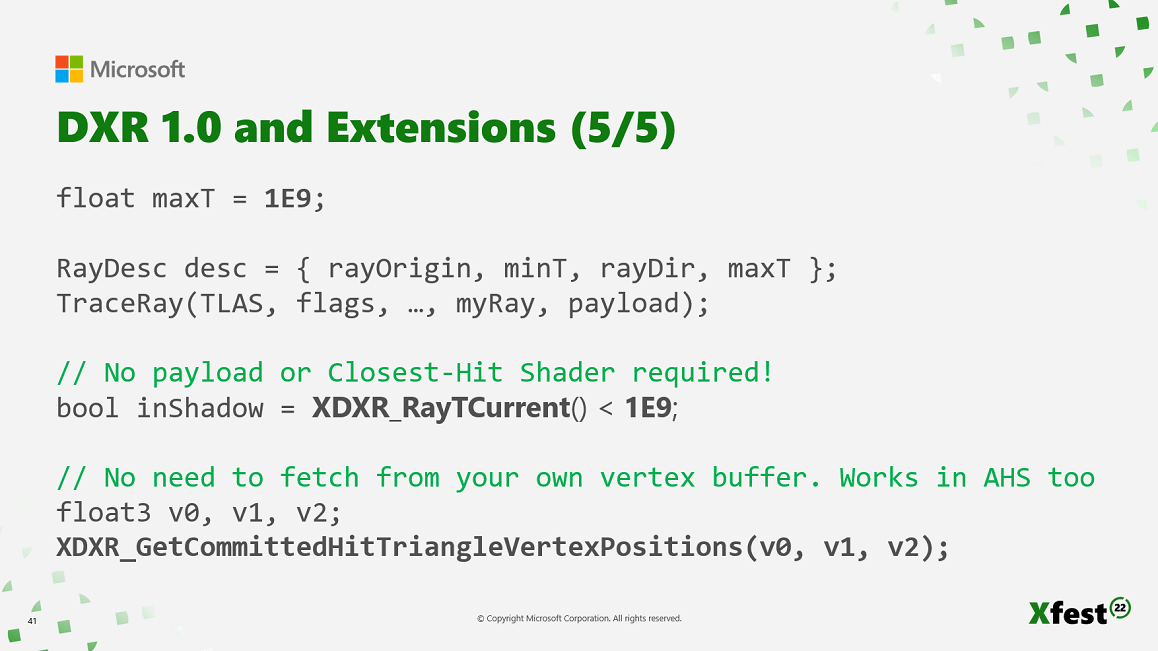
XDXR_RayTCurrent et XDXR_GetCommittedHitTriangleVertexPositions. Commencez par initialiser maxT à la longueur maximale du rayon, puis appelez TraceRay. Comparez XDXR_RayTCurrent une fois l’appel TraceRay terminé et le contrôle revenu au shader de génération de rayons. Si la valeur est inférieure à celle définie à l’origine, il y a eu une intersection. S’il y a eu une intersection et que vous souhaitez connaître les positions des vertex, appelez XDXR_GetCommittedHitTriangleVertexPositions. Vous obtenez les trois positions de vertex directement depuis la mémoire de la BVH.
Lancer de rayons inline
Bien que certains titres utilisent encore DXR 1.0, nous recommandons aux développeurs d’utiliser DXR 1.1 et le lancer de rayons inline. DXR 1.1, qui existe sur PC, a introduit une version du lancer de rayons inline appelée RayQuery. Elle vous permet de lancer des rayons depuis des étapes de shader traditionnelles, comme les compute shaders ou les pixel shaders.RayQuery ne peut pas appeler d’autres shaders. Vous ne pouvez pas, par exemple, gérer une transparence avec test alpha en appelant un shader hit. Tout doit être fait dans ce shader, sans appel de fonction possible. XBOX ne prend pas en charge l’API RayQuery de DXR 1.1. Cependant, il existe une autre option.
DXR 1.0 reste une boîte noire sur console, de la même manière que sur PC. Le code source du générateur de BVH au runtime n’est pas fourni, et le code de parcours est caché dans le pilote derrière l’appel DispatchRays. Le code de parcours des rayons a été implémenté en HLSL (langage de shader de haut niveau). Vous pouvez consulter ce code et l’inclure directement dans vos propres shaders. Le code de parcours est fourni en HLSL dans un fichier d’en-tête livré avec le GDK. Vous pouvez l’inclure avec hash #include dans vos shaders et l’utiliser comme vous le souhaitez.
Vous appelez hash #include avec le fichier XDXRStandaloneTraverseShortStack.hlsli inclus dans le répertoire d’installation du GDK. Il peut être utilisé dans n’importe quelle étape de shader capable d’allouer de la LDS ou de la mémoire partagée de groupe. Aujourd’hui, il s’agit du compute shader et du pixel shader. Comme la source est fournie, vous pouvez modifier le shader. S’il existe une fonctionnalité dont vous n’avez pas besoin (ou que vous payez) et que vous souhaitez supprimer, supprimez le code.
Si vous avez du code que vous souhaitez ajouter à votre shader pour personnaliser votre titre, ajoutez ce code directement à l’en-tête et continuez à l’inclure. Aucune exigence binaire n’impose à votre shader de correspondre à quoi que ce soit dans le pilote. Il n’est versionné d’aucune manière. Il est là pour que vous l’incluiez dans vos shaders.
IMPORTANT : nous nous réservons le droit de modifier le format de la BVH à tout moment, lors de n’importe quelle mise à jour du GDK. Ces shaders peuvent changer d’un GDK à l’autre. Si vous apportez des modifications, soyez prêt à fusionner vos modifications personnalisées à chaque mise à jour du GDK.
Figure 10. Diapositive 46.
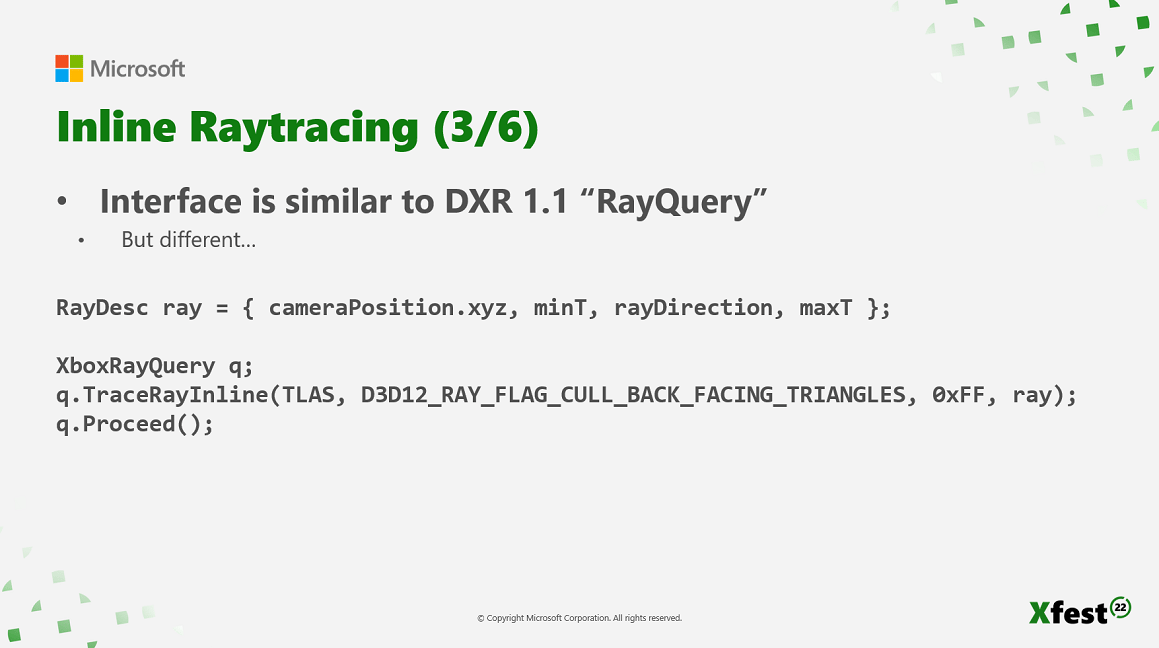
RayQuery de DXR 1.1. Elle s’appelle XboxRayQuery et accepte bon nombre des mêmes indicateurs et des mêmes entrées. En fait, elle se ressemble beaucoup, et c’est pourquoi nous n’avons pas investi de temps dans DXR 1.1.
Si vous utilisez l’approche du lancer de rayons inline, vous voudrez peut-être gérer le test alpha. Cela peut se faire de l’une des deux manières suivantes.
- La fonction Proceed retourne chaque fois qu’une intersection non opaque est trouvée et demande s’il faut valider cette intersection. Vous pouvez utiliser l’intrinsèque candidate pour obtenir des informations sur les coordonnées barycentriques, effectuer une lecture de texture, puis vérifier le canal alpha pour déterminer si vous souhaitez accepter l’intersection.
- Injectez votre fonction de test alpha directement dans la boucle de parcours. L’avantage en termes de performances est que vous ne sortez pas de la boucle de parcours pour exécuter votre code avant de devoir y revenir par le début. Exécutez votre fonction de test dans la boucle de parcours pour économiser des registres vectoriels à usage général (VGPR), augmenter l’occupation et exécuter moins d’instructions. Nous vous recommandons d’utiliser cette option en raison de ces avantages.
switch ou une instruction if. Cependant, lorsque vous devez appeler 1 000 fonctions différentes pour gérer 1 000 shaders closest-hit différents, ou du code pour gérer différents matériaux, cela pèse considérablement sur l’apparence du shader et sur sa compilation.
PIX ne reconnaît pas que vous effectuez un lancer de rayons. Il s’agit simplement d’un autre compute shader qui appelle du code fourni dans un fichier d’en-tête. Comme il n’est pas reconnu comme du lancer de rayons, le profilage des performances et le débogage sont délicats. De plus, si vous avez une implémentation DXR 1.0 en cours d’exécution, des étapes supplémentaires sont nécessaires pour faire fonctionner cette approche en plus de la solution qui fonctionnait déjà.
Occupation
L’occupation est importante pour obtenir de bonnes performances avec le lancer de rayons. Une faible occupation est le problème de performances le plus courant dans les titres. Les développeurs ont implémenté le lancer de rayons, mais constatent de mauvaises performances. Les titres ont souvent des objets d’état de pipeline de lancer de rayons (RTPSO) qui utilisent plus de 160 VGPR. Cela correspond à une occupation de seulement six waves en Wave32. Si le lancer de rayons était exécuté en Wave64, l’occupation serait de trois. C’est beaucoup trop faible. La bonne pratique consiste pour un titre à atteindre une occupation élevée avec au moins 12 Wave32 exécutées simultanément. Figure 11. Diapositive 52.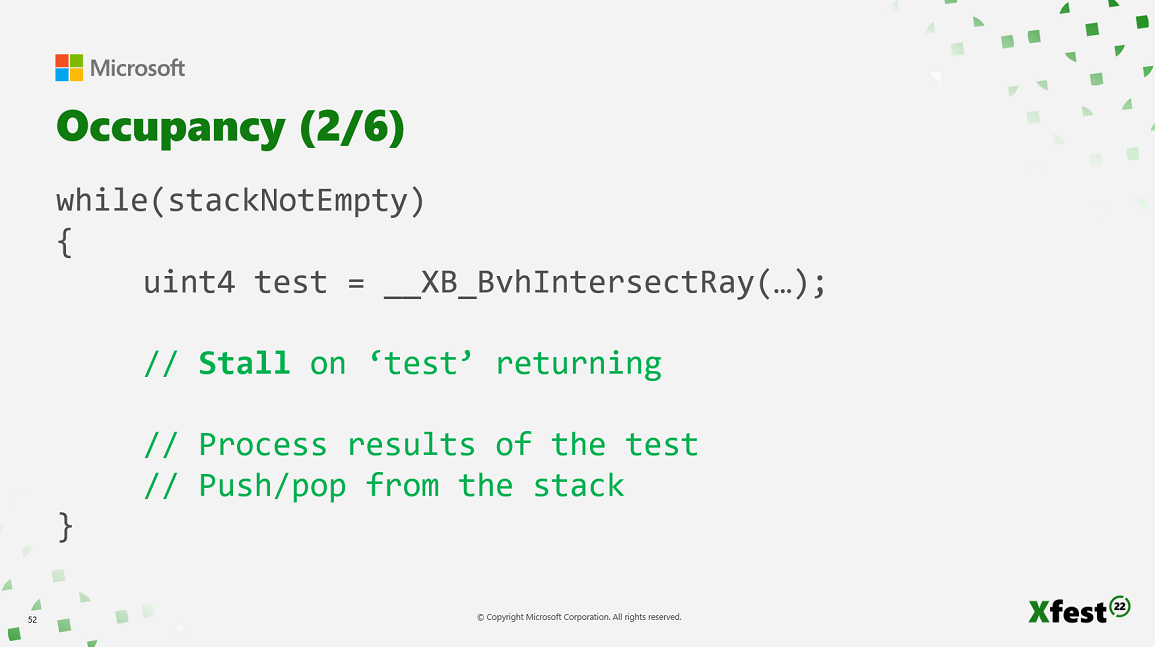
while qui signifie : « tant qu’il reste des zones de la BVH à explorer, effectuer un test d’intersection de rayon ». La figure 11 montre l’intrinsèque _XB_BvhIntersectRay. La wave n’a plus rien à faire : elle attend la réponse à « qu’a touché ce rayon, et à quelle distance ? », puis elle se bloque. Il est essentiel que le GPU planifie une autre wave pour remplacer celle-ci. Si vous êtes à une occupation de un, vous n’avez pas d’autre option que de bloquer l’ensemble du SIMD en attendant le retour de la requête d’intersection de cette wave. Plus l’occupation est élevée, plus le GPU dispose d’options pour planifier de nouvelles waves. C’est pourquoi il est important d’avoir 12, 13, 14, 15 ou 16 waves exécutées simultanément.
Comme notre code de parcours utilise 2 Ko de LDS ou de mémoire partagée de groupe pour chaque Wave32, il est impossible de dépasser une occupation de 16. C’est la limite, même si le matériel peut atteindre une occupation de 20. Vous ne pouvez pas l’atteindre en raison de la quantité de LDS utilisée par le shader. Une occupation de 16 ne pouvant pas être dépassée, il n’y a aucun intérêt à essayer de faire descendre votre nombre de VGPR en dessous de 64.
Les RTPSO doivent être lancés en allouant autant de VGPR que les shaders les plus coûteux de l’ensemble du RTPSO. Il n’est pas possible de savoir quels shaders vous appelez ; on suppose donc que n’importe lequel d’entre eux peut être appelé. Par conséquent, vous devez allouer les VGPR au niveau le plus élevé de tous ces shaders.
Les shaders any-hit utilisent leurs VGPR en plus de ceux utilisés par le parcours. Les VGPR ne sont pas sauvegardés ni restaurés en mémoire à chaque appel du shader any-hit. Il est important de maintenir un faible nombre de VGPR dans les shaders any-hit. Les shaders closest-hit sont généralement ceux qui ont les besoins en VGPR les plus élevés. Ces shaders s’apparentent à un pixel shader d’une passe de rastérisation normale. Ils évaluent généralement les matériaux, l’éclairage, la BRDF, etc. ; ils présentent donc le nombre de VGPR le plus élevé. Gardez cela à l’esprit lorsque vous examinez le nombre de VGPR de l’ensemble du RTPSO.
Nous vous recommandons de créer un RTPSO par usage. Cela signifie, par exemple, avoir un RTPSO pour les ombres, un RTPSO pour l’occlusion ambiante ou un RTPSO pour les réflexions.
Par exemple, les ombres ont généralement des besoins en VGPR inférieurs à ceux des réflexions. Lorsque vous effectuez le rendu des ombres par lancer de rayons, vous pouvez obtenir une occupation plus élevée pour les ombres que pour les réflexions. Si vous créiez un seul RTPSO pour les réflexions et les ombres, il serait plafonné aux besoins en VGPR des réflexions. Un RTPSO dédié aux ombres peut s’exécuter avec une occupation plus élevée et de meilleures performances.
Il est essentiel de garder les shaders any-hit aussi simples que possible. Ils sont appelés inline avec le parcours. Chaque fois qu’un seul rayon évalue un shader any-hit, il retarde tous les autres threads qui n’ont pas besoin d’exécuter le shader any-hit. Il est recommandé de garder les shaders aussi petits que possible. N’essayez pas d’y évaluer l’éclairage et de le stocker dans la charge utile. Effectuez le minimum de travail : décidez si vous souhaitez accepter l’intersection, puis revenez au parcours.
DXR 1.0 alloue une pile de 32 Mo lors de la création de l’appareil pour prendre en charge la sauvegarde et la restauration des registres, ainsi que la récursivité. En 2019, le conseil était de ne pas utiliser la récursivité. C’est toujours vrai aujourd’hui. C’est un problème de performances dont il est difficile de sortir.
Pour une allocation de pile de 32 Mo, le mot pile est légèrement ambigu. Il existe en fait deux piles. Il y a la pile que chaque wave alloue dans la LDS pour suivre son chemin dans la BVH et le nœud auquel elle doit revenir. Et il y a la pile qui existe en mémoire globale et qui sert à sauvegarder et restaurer les registres.
Pour le second type de pile, si une seule wave a de nombreux registres à déverser et doit écrire de nombreux registres en mémoire, les 32 Mo peuvent être rapidement épuisés. Dans les cas extrêmes, cette pile de 32 Mo peut agir comme une limite d’occupation. Depuis le GDK de mars 2022, 32 Mo sont alloués sur les consoles XBOX Series X et XBOX Series S. Dans le GDK de juin 2022, XBOX Series S alloue une pile beaucoup plus petite, car elle dispose de moins de processeurs de groupe de travail que XBOX Series X. Si vous n’utilisez pas cette pile, vous pouvez la désactiver lors de la création de l’appareil. Par exemple, si vous utilisez exclusivement DXR 1.1 et l’approche du lancer de rayons inline, aucun registre ne serait déversé, quel que soit l’usage.
RTPSO hors ligne
XBOX peut toujours compiler les shaders en DXBC ou en DirectX Intermediate Language (DXIL), comme sur PC Windows. Mais en tant que plateforme fixe, XBOX peut également précompiler les shaders jusqu’au microcode AMD, prêt à être exécuté sans compilation supplémentaire. Il n’y a aucune difficulté pour les vertex shaders, les pixel shaders et les compute shaders si vous fournissez une signature racine. Les compute shaders, les vertex shaders et les pixel shaders sont des éléments de code indépendants, compilés et autonomes. Ils n’effectuent pas d’appels de fonction vers d’autres codes. Il n’y a pas d’ABI à gérer lors d’un autre appel. Ils sont faciles à compiler en microcode. Malheureusement, les shaders de lancer de rayons sont beaucoup plus complexes. Ils ont des dépendances externes envers du code que le compilateur ne peut pas voir. Le code de parcours existe dans le pilote, mais pas dans le compilateur. Lorsque vous compilez un shader de lancer de rayons, l’intégralité du shader ne peut pas être compilée jusqu’au microcode AMD. La compilation ne va que jusqu’au DXIL. Lorsque vous compilez des shaders DXR, utilisez la cible lib_6_3 (Library Shader Model 6.3). Ces shaders sont compilés en DXIL. Cela fonctionne de la même manière que sur PC. Ce n’est que lorsque vous appelez CreateStateObject au runtime que le microcode AMD est produit. Dans certains cas, les RTPSO contenant des centaines ou des milliers de shaders peuvent prendre des secondes plutôt que des millisecondes. Un appelCreateStateObject de plusieurs secondes est à prévoir. Un temps de compilation de deux secondes peut éventuellement être masqué derrière un écran de chargement. Si votre titre en monde ouvert permet aux joueurs de s’y déplacer à grande vitesse et que vous ne pouvez pas retarder de deux secondes l’affichage d’un objet pour compiler un nouveau RTPSO, cela posera problème. Comme XBOX ne prend pas actuellement en charge DXR 1.1, l’API AddToStateObject, qui ajoute des shaders aux RTPSO, ne vous aidera pas.
À la place, vous pouvez précompiler entièrement les RTPSO hors ligne. C’est plus complexe que d’appeler DXC. À l’aide du pilote PC XBOX Series X|S, qui est le même pilote que celui que vous utiliseriez avec le générateur de BVH hors ligne, compilez vos RTPSO jusqu’au microcode AMD. Appelez CreateStateObject, qui est la même API que celle à appeler au runtime sur la console. Sérialisez le RTPSO sur le SSD à l’aide de l’API SerializeStateObjectX. Une fois écrit sur le SSD, ce blob ne pèse que quelques Mo, selon le nombre de shaders dont vous disposez. Vous pouvez charger ce bloc depuis le SSD au runtime et utiliser l’API DeserializeStateObjectX pour obtenir un RTPSO précompilé et chargeable sans étape de compilation.
Ces bibliothèques DXIL peuvent être compilées en RTPSO de deux manières présentant une différence subtile.
La première option est un RTPSO entièrement autonome. Il s’agit d’un RTPSO prêt à être lié au pipeline et utilisé dans un appel DispatchRays.
La seconde option, que nous appelons également un RTPSO, est une collection. Il s’agit d’un groupe de shaders ayant soit un objectif commun, soit une relation commune avec un objet ou un niveau spécifique. Ces shaders peuvent être compilés sous la forme d’un seul blob ou d’une seule entité, puis partagés entre plusieurs RTPSO au runtime. Avec cette option, vous pouvez construire un RTPSO au runtime à partir de plusieurs collections précompilées hors ligne. Au lieu d’être compilées en microcode AMD au runtime, ces collections précompilées sont liées dans le pilote. Ce processus prend généralement environ 10 millisecondes. Cette étape de précompilation hors ligne supprime le DXIL et les métadonnées afin de réduire la taille. Si vous effectuez une association de sous-objets au runtime, qui est une fonction de l’API DXR, cela n’est pas possible avec cette option.
Avec la seconde option, vous obtenez les identificateurs de shader à partir du RTPSO. Ils sont requis au début de chaque enregistrement de votre table de liaison de shaders. Ce processus, ainsi que la compression de BVH, est illustré dans l’exemple ATG OfflineRT.
PIX
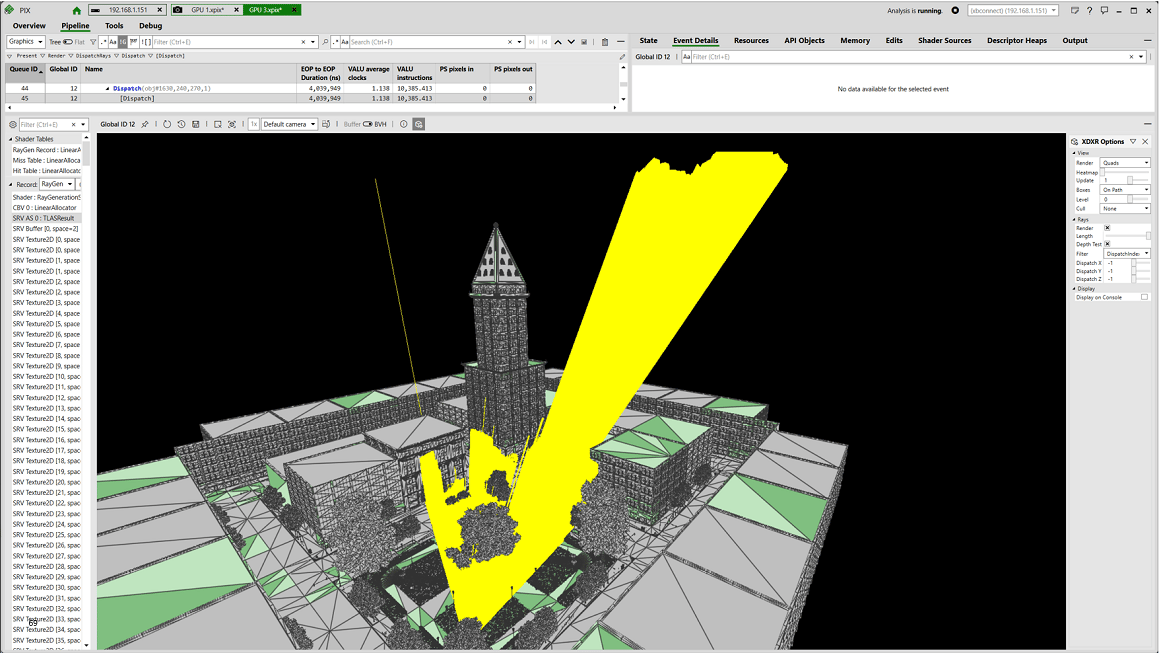
PIX a beaucoup investi dans la prise en charge de DXR. L’Acceleration Structure Viewer et l’affichage des ressources dans la vue Pipeline ont également fait l’objet de travaux. Deux domaines actuellement insuffisants, mais qui font l’objet d’un travail actif important, sont les PDB de shaders pour le lancer de rayons, qui ne sont pas encore pris en charge, et la possibilité de déboguer des rayons ou des threads dans les appels DispatchRays. Si vous avez des suggestions pour améliorer PIX, la prise en charge de DXR ou d’autres commentaires, sélectionnez le bouton Feedback dans le coin supérieur droit de PIX et faites-nous part de vos commentaires sur la prise en charge de DXR ou sur tout autre domaine dont vous souhaitez nous informer. Figure 12. Diapositive 65. Les images suivantes vous montrent à quoi ressemble l’Acceleration Structure Viewer.
La figure 12 montre un appel de dispatch. La sélection d’une structure d’accélération sur la gauche vous donne une caméra libre pouvant orbiter autour d’une vue d’ensemble de votre structure d’accélération. Vous pouvez voir les triangles individuels, les instances individuelles et les BLAS qui composent l’ensemble de votre TLAS.
Figure 13. Diapositive 66.
 La figure 13 montre une carte thermique. Utilisez-la pour voir où se trouvent les points chauds de performances dans votre scène. Elle prend le shader de lancer de rayons inline et le rend compatible PC. Votre PC hôte exécute désormais le code de parcours dans PIX. Comme il s’agit d’une version instrumentée, des informations peuvent être extraites sur le nombre d’itérations de la boucle de parcours nécessaires pour ce rayon. Ces informations peuvent être visualisées à l’écran sous forme de couleurs.
Figure 14. Diapositive 67.
 La figure 14 montre que les objets, comme cette poubelle mise en surbrillance à l’avant de la scène, sont sélectionnables. Vous pouvez déterminer qu’elle n’est pas fusionnée avec le sol. Si elle l’était, cela créerait une grande limite d’instance. Il est important de pouvoir sélectionner des objets et voir où ils se trouvent dans la scène.
Figure 15. Diapositive 68.
 Dans la figure 15, un arbre est sélectionné. L’Acceleration Structure Viewer affiche également toutes les autres copies de cet arbre. Cette figure contient environ 10 copies de l’arbre. En sélectionnant un arbre, les neuf autres sont mis en surbrillance. Cela montre que l’instanciation est utilisée et que 10 BLAS différentes ne sont pas utilisées pour ces arbres.
Figure 16. Diapositive 69.
Résumé
En résumé :- Le lancer de rayons est possible sur les consoles XBOX Series X|S.
- Vous devez porter une attention particulière aux performances.
- Tenez compte des ressources artistiques au moment de leur création. Cela inclut les shaders que vous écrivez, les indicateurs de build que vous utilisez, le fait que vous utilisiez une API propre à XBOX ou le calcul asynchrone.
- La mémoire peut être une préoccupation importante. En particulier sur les consoles XBOX Series S, environ 500 Mo de mémoire sont nécessaires pour vos BLAS ou TLAS.
Étapes suivantes
Si vous souhaitez consulter les supports de présentation associés à cette vue d’ensemble, téléchargez les fichiers suivants depuis XBOX Developer Download Secure Data Storage (SDS).- Diaporama : GR09_Best Practices for Raytracing on XBOX Series X|S.pptx dans Xfest 2022 Graphics Track PowerPoints (Xfest2022GfxPPTs.ZIP)
- Présentation vidéo : GR09.mp4 dans Xfest 2022 Graphics Track Videos (Xfest2022GfxVids.ZIP)
Télécharger les présentations Microsoft PowerPoint et les vidéos
- Accédez à Téléchargements du Game Development Kit (GDK).
- Sous Select file type, sélectionnez Conference Materials, puis Confirm.
- Sous Select build/version number, choisissez l’une des présentations graphiques suivantes.
- Xfest 2022 Graphics Track PowerPoints
- Xfest 2022 Graphics Track Videos
- Sélectionnez Download Now, puis attendez la fin du téléchargement du fichier .zip.
- Accédez à votre dossier Téléchargements local, puis décompressez (extrayez) les fichiers du dossier compressé.