舊版管線
在過去 20 年中,圖形管線不斷演進,才達到現今大家熟悉的狀態。隨著獨立硬體廠商 (IHV) 專注於核心數量、記憶體容量和頻寬日益擴大的競爭,幾何處理模型中某些固定功能的瓶頸也變得明顯。 圖 1. 舊版圖形管線。藍色階段為固定功能。綠色階段為可程式化著色器。
Mesh Shader 管線
Mesh Shader 管線針對的就是舊版圖形管線的這些限制。首先,它從管線中移除了 IA 和鑲嵌器。其目的是將著色器 wave 啟動速率最大化,並將 IA 移至可隨 GPU 擴充的著色器程式碼。這有助於讓 GPU 核心達到飽和,並維持對 PA 的壓力。 此管線也提供在管線中多個點剔除工作負載的能力。Amplification Shader 可用來進行低細微度的剔除,例如針對分組的物件、執行個體或 meshlet。Mesh Shader 可以在每個基本型別的細微度進行剔除。這提供了一種及早且經常捨棄可輕易剔除之基本型別的方法,可節省寶貴的運算、記憶體頻寬和 PA 輸送量。 圖 2. Mesh Shader 管線的各個階段。綠色階段為可程式化。藍色階段為固定功能。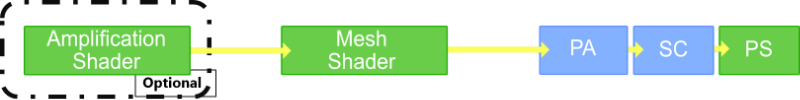
Mesh Shader
Mesh Shader 的設計目的是為幾何管線提供原本只有計算著色器才有的通用性。這讓開發人員能完全控制每個執行緒的工作負載。將索引和頂點屬性擷取移至著色器程式碼,可消除對固定功能硬體的相依性,將 wave 啟動速率最大化,並讓 IA 能隨 GPU 的其餘部分擴充。 它們能動態指定頂點和基本型別匯出數量,為有效率的晶片上基本型別剔除支援開啟了大門。這可以在 Mesh Shader 內針對任意剔除準則,以每個 meshlet 或每個基本型別的方式完成。這可讓著色器將頂點屬性擷取和著色延遲到管線的結尾,也就是在已執行多層剔除之後。Amplification Shader
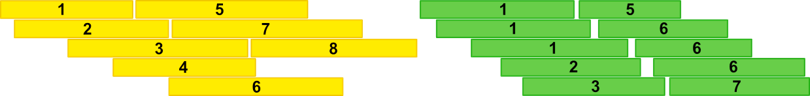
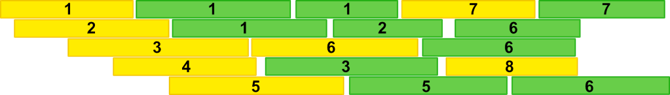
計算著色器經常用來預先處理資源,接著再透過 ExecuteIndirect 進行使用其結果的繪製呼叫。這是許多形式之每個檢視剔除的常見技術。這有幾個細微的缺點,若有適當的硬體支援即可最佳化。 首先,計算著色器執行個體必須將其資料寫入全域記憶體。這會產生擷取延遲,並使其受到整個 GPU 的記憶體頻寬爭用影響。其次,如果計算產生者和圖形取用者是連續的作業,GPU 必須等待所有計算著色器執行個體結束,才能啟動取用的繪製呼叫。這是由無序存取檢視 (UAV) 資源屏障所造成,該屏障必須強制確保所有對最終 UAV 的計算著色器寫入都已完成,任何著色器才能取用它。 圖 3. 計算著色器緊接著 ExecuteIndirect「DispatchMesh」繪製的簡化 wave 排程視覺化呈現。由於 UAV 屏障,計算著色器 wave (黃色) 與 Mesh Shader wave (綠色) 的執行之間被管線停滯隔開。編號的識別碼將叫用的計算著色器執行緒群組與其 Mesh Shader 子系群組相關聯。