Hardware
Diversos fornecedores independentes de hardware (IHVs) definem topologias de CPU heterogêneas de maneiras diferentes. A Intel e a Qualcomm usam os termos Performance e Efficiency, enquanto a AMD usa os termos Performance e Compact. Cada fornecedor faz concessões entre desempenho e eficiência ao projetar sua topologia de núcleos. Os exemplos a seguir ilustram algumas das escolhas de design envolvidas:- Tamanhos de cache diferentes
- Os diferentes núcleos podem ter tamanhos de cache diferentes.
- Por exemplo, os núcleos de desempenho podem ter caches L1 e L2 maiores.
- Compartilhamento de cache
- Pode haver diversos níveis de compartilhamento dos caches entre os núcleos.
- Por exemplo, os núcleos de maior desempenho podem ter, cada um, um cache L2 privado, enquanto os núcleos mais eficientes podem compartilhar um único cache L2.
- Suporte a multithreading simultâneo (SMT)
- Alguns núcleos podem oferecer suporte a SMT, enquanto outros não.
- A Intel chama o SMT de Hyper-Threading.
- Layout interno do núcleo
- Os recursos internos dos vários tipos de núcleo podem ser diferentes.
- Por exemplo, os núcleos de desempenho podem incluir mais pipes de ponto flutuante, pipes de ALU ou faixas de dados mais largas.
- Frequência máxima
- A frequência máxima pode ser diferente entre os tipos de núcleo.
- Por exemplo, os núcleos de desempenho podem atingir uma frequência mais alta do que os núcleos eficientes.
Números de desempenho
É esperado que núcleos com diferentes níveis de eficiência tenham desempenhos diferentes. Um núcleo é projetado para desempenho e o outro para economia de energia. A questão é o quanto os núcleos são diferentes. Os dados mostrados são um conjunto agregado de vários IHVs. Cada IHV tem uma escala diferente para cada teste, com base nas escolhas feitas para sua topologia. Embora os números exatos sejam diferentes, os padrões são semelhantes entre todos os IHVs. Além disso, cada geração de CPU faz concessões diferentes, o que ajusta seus números relativos. Gerar números para todos os IHVs e gerações existentes está além do escopo deste artigo.Testes sintéticos
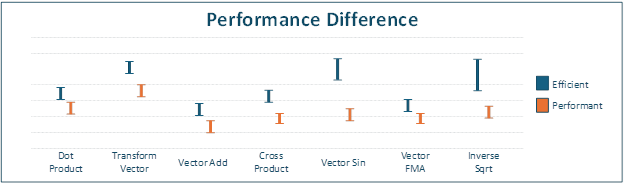
A matemática vetorial é uma parte importante do trabalho que um título de jogo realiza em um quadro. Essa carga de trabalho pode ser qualquer coisa, de física a IA e renderização. O jogo realiza esse trabalho usando tipos vetoriais com três ou quatro floats que cabem em um único registro SSE de 128 bits. Eles abrangem uma ampla variedade de operações, como produtos escalares, multiplicação de matrizes, cálculos de raiz quadrada e transformações de vetores. Diferenças de desempenho nessas operações podem ter um efeito significativo no tempo total do quadro. Os gráficos a seguir mostram o custo relativo de realizar sete operações matemáticas comuns. As medições usam um vetor de quatro valores de ponto flutuante de 32 bits armazenados em um único registro SSE de 128 bits. Uma matriz é composta por quatro vetores, totalizando dezesseis valores de ponto flutuante de 32 bits em quatro registros SSE de 128 bits. Essas operações foram selecionadas porque são usadas com frequência em um quadro.- Produto escalar: calcula o produto escalar de um vetor.
- Transformação de vetor: transforma um vetor multiplicando-o por uma matriz.
- Soma de vetores: soma dois vetores.
- Produto vetorial: calcula o produto vetorial de dois vetores.
- Seno vetorial: calcula uma aproximação do seno de cada elemento de um vetor.
- FMA vetorial (multiplicação e adição fundidas): multiplica dois vetores e soma um terceiro.
- Raiz quadrada inversa: calcula a raiz quadrada inversa do comprimento de um vetor.
Mundo real
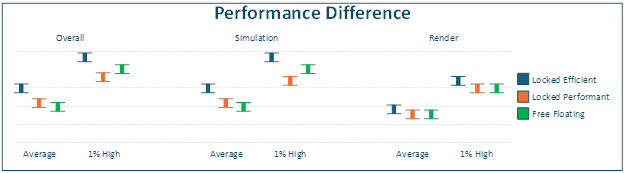
Os números anteriores mostram benchmarks específicos de forma isolada e contam apenas parte da história. Os números a seguir vêm de benchmarks de um mecanismo de jogo AAA que usa dois threads principais (Simulação e Renderização) com um conjunto de threads de trabalho. O benchmark usa três configurações de teste.- Os dois threads principais são executados apenas nos núcleos de maior desempenho.
- Os dois threads principais são executados apenas nos núcleos eficientes.
- Os dois threads principais são executados em todos os núcleos do sistema.
Cada fabricante pode ajustar essas heurísticas do agendador para adaptá-las ao seu hardware. Por exemplo, a AMD tem o Workload Profile Scheduling e a Intel tem a tecnologia Thread Director. Cada IHV também costuma ajustar as heurísticas para corresponder à topologia específica do SoC.
Recomendações
Afinidade de threads
A recomendação de afinidade de threads ao executar em um computador desktop com apenas uma classe de eficiência é evitar definir afinidades rígidas de threads e, em vez disso, permitir que os threads flutuem entre todos os núcleos. O principal motivo dessa incerteza é que não se sabe com antecedência quais outros processos podem estar em execução no computador do usuário. É possível que um thread com afinidade rígida acabe compartilhando um núcleo com outro thread de alta prioridade do sistema. O efeito final é que o thread do título fica sem tempo de execução. Se essa contenção ocorrer em um thread crítico para o quadro, o título pode apresentar tempos de quadro inconsistentes. Você deve garantir que o sistema operacional tenha para onde mover os threads do título para mantê-los em execução. No entanto, essa recomendação precisa mudar ao executar em CPUs heterogêneas. O principal motivo é que o sistema operacional não sabe necessariamente quais threads ou trabalhos do título são críticos para o quadro. Ele tem algumas heurísticas para determinar o que considera threads críticos para o quadro, mas essas heurísticas ainda podem fazer escolhas incorretas. Ele pode decidir mover um desses threads ou trabalhos para um núcleo de menor desempenho e, assim, aumentar a probabilidade de problemas de desempenho no título. A recomendação é permitir que os threads do título sejam executados em, no mínimo, três a quatro núcleos, sendo preferível mais. Por exemplo, em um sistema de nível inferior que tenha um núcleo de maior desempenho e três núcleos de menor desempenho, você deve permitir que os threads flutuem entre todos os núcleos. Em computadores com três ou mais núcleos de desempenho, você pode restringir os threads críticos para o quadro apenas a esses núcleos de maior desempenho. Em computadores de nível superior com muitos núcleos que também oferecem suporte a SMT, alguns títulos podem tentar fixar seus threads em núcleos físicos. Essa técnica evita a contenção no nível do núcleo físico, já que vários threads de alta prioridade compartilham os mesmos recursos de um núcleo físico. Em geral, porém, não é recomendável considerar esse caso. O sistema operacional já aplica esse comportamento em todo o sistema. Ele agenda os threads primeiro entre os núcleos físicos e usa mais núcleos lógicos somente quando necessário. O único caso que um título deve considerar é quando há núcleos de maior desempenho suficientes no sistema para dar suporte aos threads críticos do título. Nesse caso, pode ser desejável fixar os threads críticos para o quadro em núcleos de maior desempenho. No entanto, esses threads devem poder flutuar entre todos os núcleos de maior desempenho. Embora, em alguns casos, permitir que todos os threads flutuem entre todos os núcleos possa melhorar o desempenho, esse comportamento não é consistente entre todos os fabricantes de CPU. Se o título implementar um sistema de roubo de trabalho capaz de equilibrar totalmente a carga de trabalho entre todos os threads, qualquer thread de trabalho deverá poder flutuar entre todos os núcleos. Não importa se são threads de trabalho de alta ou baixa prioridade. O algoritmo de roubo de trabalho equilibra a carga automaticamente e permite que a maior quantidade de trabalho seja concluída no menor tempo. Threads nos núcleos de maior desempenho executam mais trabalhos durante o quadro. Se houver vários threads críticos para o quadro, pode ser útil definir sua afinidade de modo que dois threads críticos nunca possam ser executados no mesmo núcleo. Por exemplo, se houver dois threads críticos para o quadro, definir suas afinidades como mutuamente exclusivas (OU exclusivo) elimina a possibilidade de o sistema operacional fazer com que os threads disputem entre si. Novamente, porém, considere essa opção apenas se houver núcleos suficientes para dar suporte a esse caso e, ao mesmo tempo, permitir que cada thread crítico para o quadro flutue entre, no mínimo, três a quatro núcleos.Topologia de threads
Ao considerar como atribuir trabalho a threads em um ambiente heterogêneo, os dados principais giram em torno da duração das várias tarefas e de como elas interagem entre si. Qual é a duração média de cada tarefa, quais são as dependências entre as tarefas, quais são as prioridades de cada tarefa etc. Quanto os threads de trabalho conseguem absorver picos de tempo em quaisquer threads ou trabalhos críticos? Se um desses threads ou trabalhos for executado 35% mais lentamente, quanto isso afeta o tempo de quadro? Por exemplo, se uma tarefa demorar mais, quanto esse atraso afeta o restante do quadro? O sistema fica parado até que essa tarefa seja concluída? Pode ser útil determinar quanto um sistema heterogêneo afeta o tempo de quadro adicionando sobrecarga extra aos threads ou trabalhos críticos. Como teste, faça com que um trabalho ou bloco de trabalho leve aleatoriamente de 25% a 35% a mais de tempo. O grau de mudança no tempo total do quadro indica o quanto o sistema de trabalhos consegue absorver picos de execução. A situação ideal é que os tempos de quadro quase não mudem. Isso significa que o sistema consegue absorver picos arbitrários no tempo de quadro. Os picos vêm da execução em um núcleo de menor desempenho ou de outro processo aleatório do sistema usando tempo de CPU.Comunicação entre threads
É preciso ter cuidado com a comunicação entre threads usando primitivas de bloqueio. A sobrecarga de uma troca de contexto está fortemente ligada ao C-State do núcleo receptor antes de o novo thread começar a ser executado. O núcleo precisa estar em C0, o estado de execução, antes que o novo thread possa começar a ser executado. O cenário mais barato é quando o núcleo já estava em execução, ou seja, já está em C0. No entanto, se o núcleo estiver ocioso, ele estará em um C-State inferior. O nível do C-State corresponde a níveis mais profundos de suspensão. Uma suspensão mais profunda resulta em menos energia usada pelo núcleo. No entanto, é mais caro despertar e voltar a executar a partir de uma suspensão mais profunda. O C-State de baixo consumo mais comum é o C1, que pode adicionar uma sobrecarga de 2 a 7 μs. O C-State seguinte, C2, pode adicionar uma sobrecarga de aproximadamente 40 a 100 μs. O número exato é específico do IHV e do SoC. Há muitas variáveis que controlam em qual C-State um núcleo fica quando ocioso; trata-se de um equilíbrio entre capacidade de resposta e consumo de energia. Um C-State mais baixo usa menos energia do que um C-State mais alto. É comum que um núcleo entre primeiro em C1 e depois mude para C2 se não tiver executado código por algum tempo. Há outra preocupação: o que acontece quando o thread que envia o trabalho e o thread que executa o trabalho estão em núcleos com perfis de desempenho diferentes. Tecnicamente, é possível que o thread de trabalho conclua trabalhos mais rapidamente do que novos trabalhos são criados. Essa situação é mais provável quando o thread que executa o trabalho está em um núcleo mais rápido do que o thread que envia os trabalhos. Se um trabalho levar menos tempo para ser executado do que para ser criado, o título pode entrar em uma situação em que um thread de trabalho fica constantemente suspenso aguardando novos trabalhos. O efeito final é que os trabalhos se tornam mais caros de executar, pois o thread de trabalho é suspenso constantemente. O custo da sobrecarga de uma troca de contexto é adicionado ao tempo de execução de cada trabalho. Paradoxalmente, essa sobrecarga pode levar a taxas de quadros mais baixas ao executar em núcleos de maior desempenho. Por exemplo, um trabalho que levava 250 μs pode de repente começar a levar 275 μs; essa regressão é uma queda de 10% no desempenho. Por causa desse caso, a recomendação é que os trabalhos sejam enviados em lotes, e não à medida que são criados. Por exemplo, se o sistema seguir um padrão em que cria um trabalho, envia o trabalho, cria um trabalho, envia um trabalho etc., esse padrão deve ser ajustado para primeiro criar um lote de trabalhos e depois enviar todos ao mesmo tempo. Se o título estiver usando um objeto que exige WaitForSingleObject, ele deverá ser colocado dentro de um pequeno loop de rotação (spin). Chame a função com um tempo limite de 0 e, quando a rotação terminar, use o valor de tempo limite normal do título. A melhor solução para esse problema, no entanto, é usar APIs de sincronização modernas, como Bloqueios SRW (Slim Reader/Writer), Seções Críticas e WaitOnAddress. Todas essas APIs de sincronização incluem internamente alguma forma de rotação, o que pode impedir que um thread seja suspenso constantemente. Essa rotação é especialmente útil para bloqueios mantidos por um curto período. É importante evitar spin locks longos. Por exemplo, um padrão em que os threads ficam constantemente em rotação aguardando trabalho a ser realizado. Se houver outro trabalho a ser realizado no núcleo, o agendador acabará suspendendo o thread em rotação para realizar esse trabalho. Quando essa preempção ocorre, há uma grande probabilidade de que o thread suspenso permaneça suspenso por um período significativo. Todo esse comportamento existe para evitar a falta de recursos para outros threads. Como o título tem pouco controle sobre quando a suspensão acontece, isso pode levar a travamentos na taxa de quadros.Sistemas de trabalhos
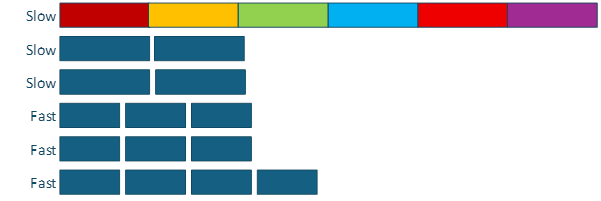
Para obter o melhor desempenho, estruture o mecanismo em torno de trabalhos, em vez de depender de threads dedicados, de longa duração e críticos para o quadro. Por exemplo, um modelo de threads de Simulação/Renderização cria dois threads persistentes críticos para o quadro. No entanto, trabalhos longos podem fazer com que qualquer thread de trabalho se comporte como um thread crítico para o quadro. Se um trabalho levar 10 ms, o thread que o executa se tornará crítico para o quadro durante esse período, independentemente de sua função original.Roubo de trabalho
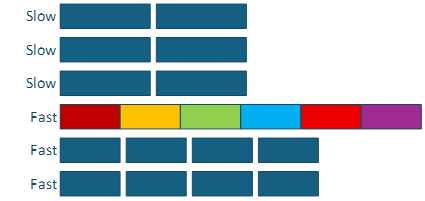
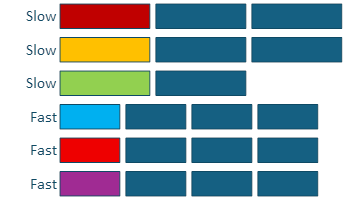
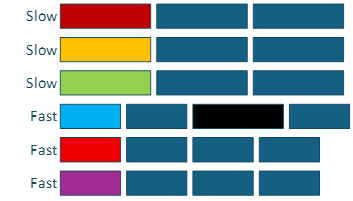
A principal recomendação é usar o roubo de trabalho em todo o sistema de trabalhos e permitir que todos os threads críticos para o quadro participem do algoritmo de roubo de trabalho. Por exemplo, se o thread de renderização estiver aguardando a conclusão de trabalhos relacionados à renderização, ele deverá executar alguns desses trabalhos. Esse comportamento já é uma prática comum em muitos mecanismos de jogo. No entanto, vale a pena mencioná-lo aqui porque esse tipo de comportamento é fundamental para que o mecanismo de jogo consiga absorver picos de quadro causados por núcleos heterogêneos e por uma possível preempção do sistema operacional. Quando um trabalho leva mais tempo para ser executado, aumenta o risco de um pico no tempo de quadro. Esse comportamento pode ser causado pela execução do trabalho em um núcleo de menor desempenho ou por outra atividade no PC. A recomendação é que o mecanismo tenha como objetivo que um trabalho leve cerca de dois por cento do quadro. Esse orçamento significa, por exemplo, no máximo cerca de 333 μs para um jogo executado a 60 fps. Se necessário, vários trabalhos menores devem ser agrupados em um trabalho maior para atingir os dois por cento. Essa abordagem oferece um bom equilíbrio entre o tamanho do trabalho, a comunicação entre threads e a capacidade de absorver picos. Estes exemplos mostram os efeitos que trabalhos longos e críticos para o quadro podem ter no desempenho do sistema. Nestes exemplos, cada trabalho consiste no mesmo número de operações. Neste exemplo, há um único trabalho que leva 375 μs em um núcleo lento e 250 μs em um núcleo rápido. O trabalho mais longo (long pole) é 6 vezes mais caro do que os outros trabalhos. A pior situação ocorre quando o trabalho mais longo acaba em um dos núcleos lentos. Isso pode ter um efeito drástico nos tempos de quadro. Nesse cenário, o tempo total para executar o trabalho é de 2.250 μs, seis vezes 375 μs. Figura 3: Exemplo de trabalho mais longo executado em um núcleo mais lento.