
Pipelining
Para implementar a sincronização correta e mais eficiente, é importante entender os blocos de hardware da GPU do XBOX Series X|S, desde o momento em que ela recebe um comando para iniciar uma ação até quando termina de executar essa ação. O Command Processor (CP) é o bloco da GPU que recebe comandos da memória (em termos simples, os comandos que enviamos para as D3D12CommandLists) na forma de pacotes (que podem ser visualizados na exibição de desmontagem de comandos do PIX). O CP é um bloco complexo com muitas partes, mas podemos simplificá-lo dividindo-o em três:- Command Processor Fetcher (CPF), que busca pacotes da memória e os envia ao CPG ou ao CPC para processamento adicional.
- Command Processor Graphics (CPG), que gerencia e processa comandos para o pipe de gráficos.
- Command Processor for Compute (CPC), que é executado em paralelo com o CPG e gerencia e processa comandos para o pipe de computação (usado pelo Async Compute).
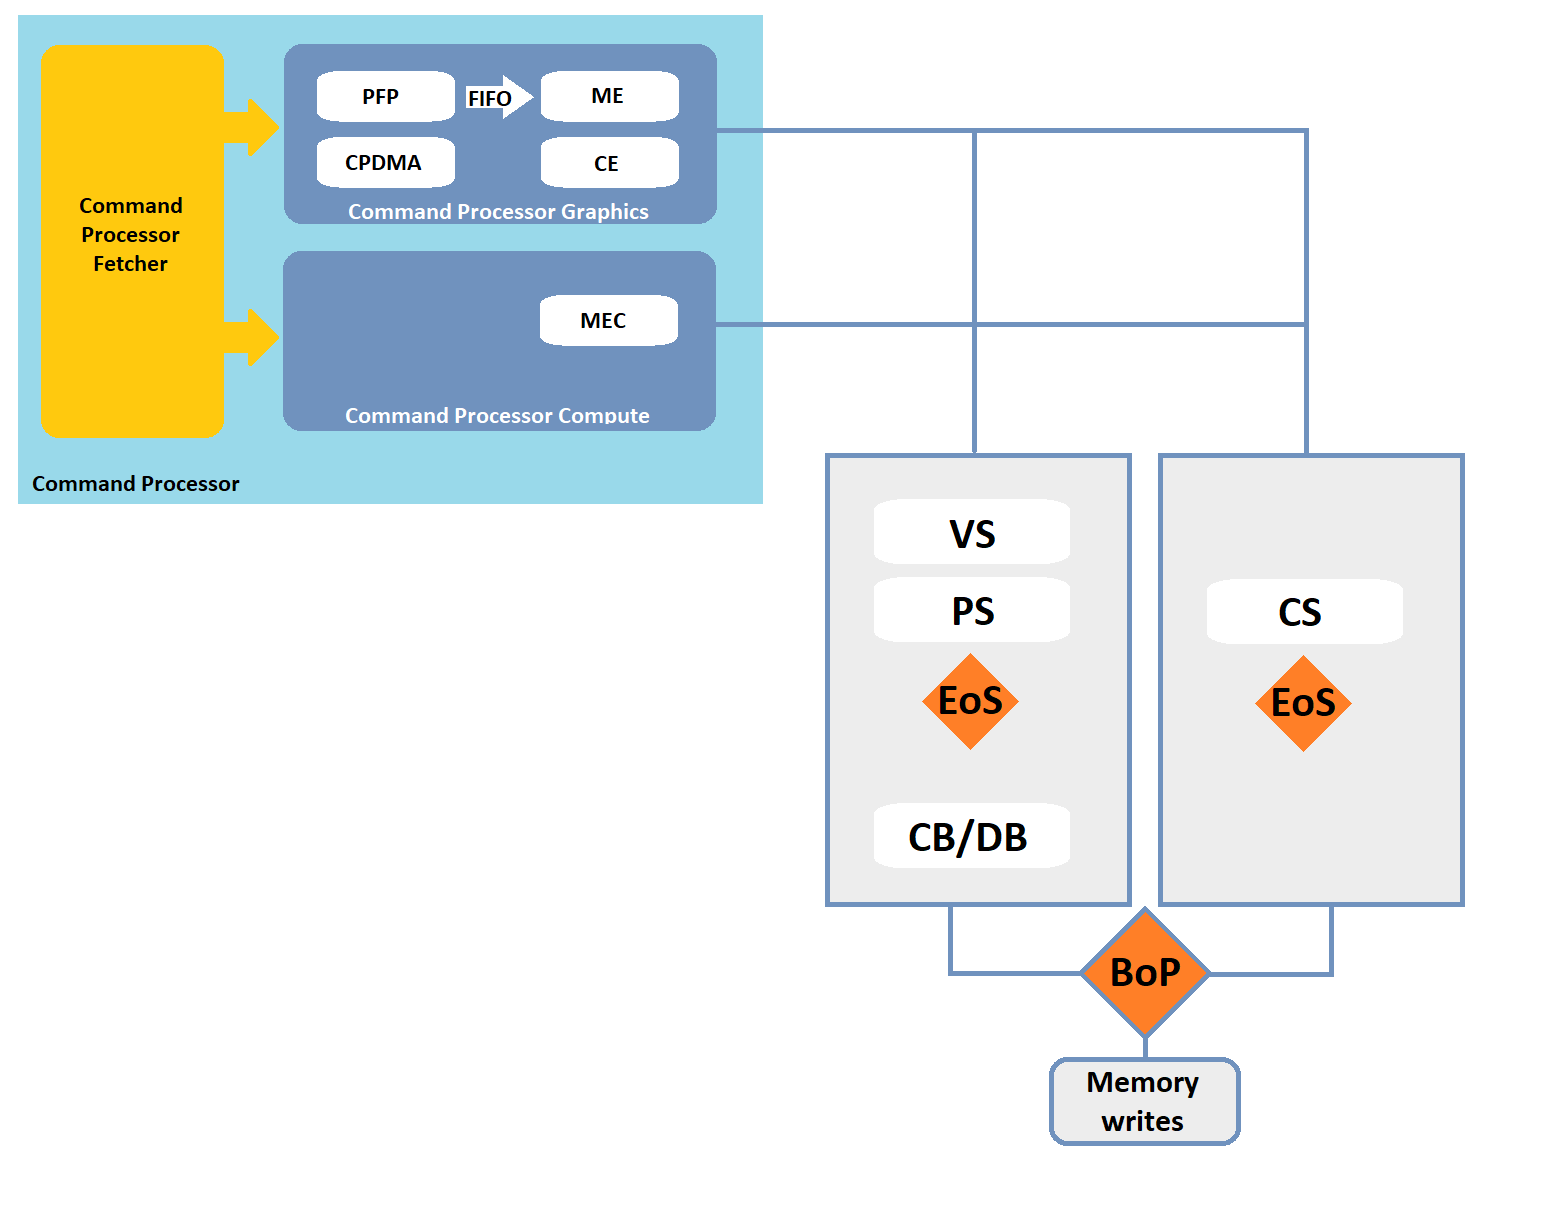
- O PFP busca os dados dos buffers de índices, lida com argumentos indiretos, informações de predicação e com a sincronização com o ME.
- O ME pode acionar flushes, iniciar desenhos/dispatches e tem slots de CPDMA para iniciar cópias.
- O Constant Engine (CE) é um bloco dentro do CPG que tem RAM usada para armazenar as constantes necessárias para cada comando de desenho. Ele copia essas constantes para o L2 e então sinaliza o ME quando os dados estão prontos (para que o ME possa reter os comandos de desenho até que as constantes estejam no lugar). O ME também pode sinalizar o CE quando os desenhos forem concluídos, para que ele possa reutilizar seus recursos.
- O CP Direct Memory Access (CPDMA) é responsável por executar cópias (de e para memória/registradores) e pode ser acionado pelo PFP, pelo ME ou pelo MEC. Ele pode copiar de e para qualquer memória virtual.
- Os eventos End of Shader (EoS) são executados depois que todas as waves do dispatch/desenho terminam, mas não aguardam a conclusão do render backend (no cenário de pipeline fixo).
- O Bottom of Pipe (BoP) ocorre quando todo o trabalho dos sombreadores e do render backend é concluído, mas não oferece garantias em relação às gravações na memória.
- para computação, EoS e BoP são iguais, pois não há trabalho do render backend.
- Fences
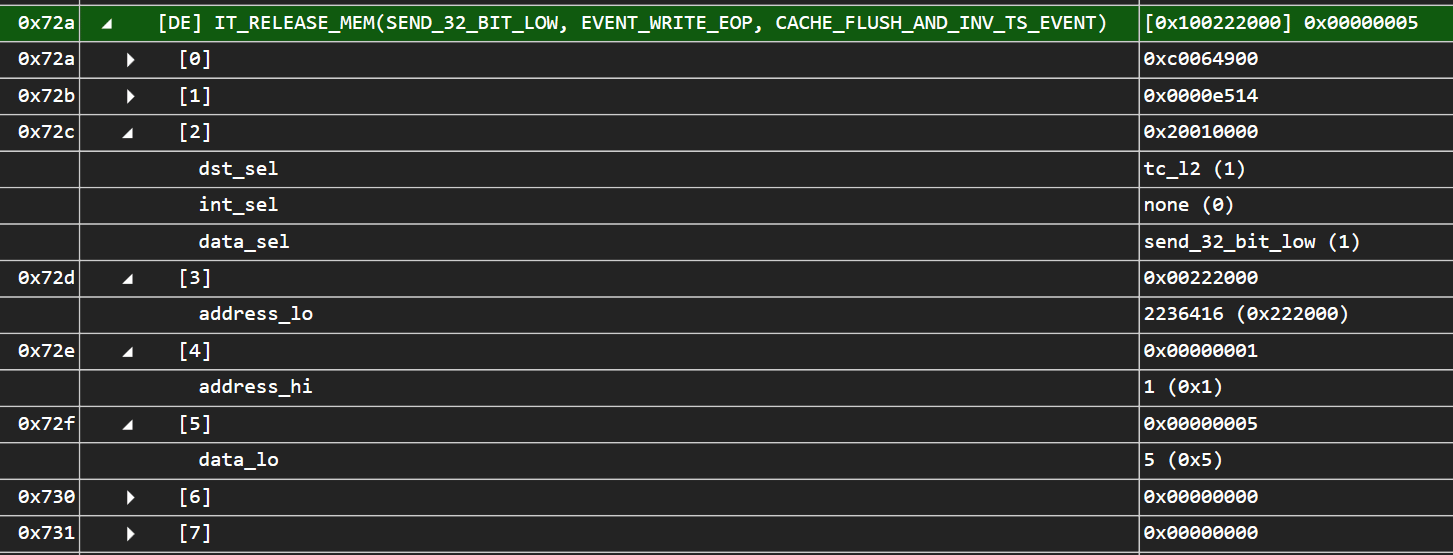
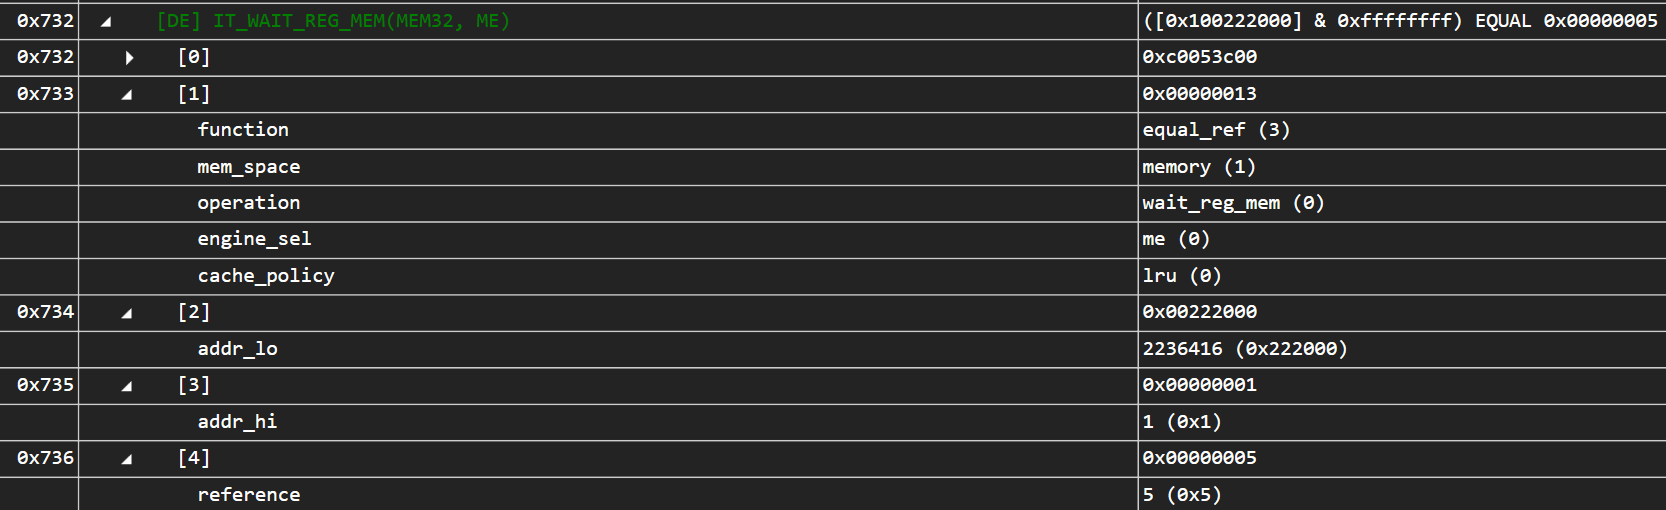
- Primitivas de sincronização compostas por (pelo menos) dois pacotes. O primeiro grava um valor de referência em um local de memória. Esse pacote é um evento que pode ser configurado para ser executado como um evento EoS ou como um evento BoP. O segundo pacote é uma espera que bloqueia um mecanismo (PFP ou ME), não permitindo que os pacotes subsequentes passem, enquanto consulta continuamente o local de memória até que o valor consultado satisfaça uma função de comparação. Nesse ponto, o mecanismo bloqueado é liberado e o trabalho pode continuar.
- Partial flush
- Os partial flushes fazem o CP aguardar até que todo o trabalho relacionado aos sombreadores de vértice, de pixel ou de computação (dependendo do pacote) seja concluído. O ME bloqueia todos os pacotes subsequentes até ser sinalizado pela SPI.
- Para o Fence, criaríamos um fence EoS que grava na memória após o trabalho de computação (assim, o primeiro pacote do fence viria após o dispatch). E faríamos o segundo pacote do fence bloquear no mecanismo ME até que o valor na memória seja atualizado (não podemos bloquear seletivamente os estágios posteriores ao ME, então, neste cenário, a escolha do mecanismo a ser bloqueado será ME ou PFP).
- Isso também pode ser feito com um partial flush de CS, que bloqueará no ME até receber o sinal de que todo o trabalho do compute shader foi concluído antes de desbloquear o mecanismo. O partial flush requer apenas um pacote, contra dois do fence (portanto, é mais barato em termos de operações de memória). Mas o fence oferece mais flexibilidade em termos de qual trabalho precisa ser aguardado enquanto o mecanismo está bloqueado (já que a gravação na memória pode acontecer após um dispatch específico, em vez de todo o trabalho de computação).
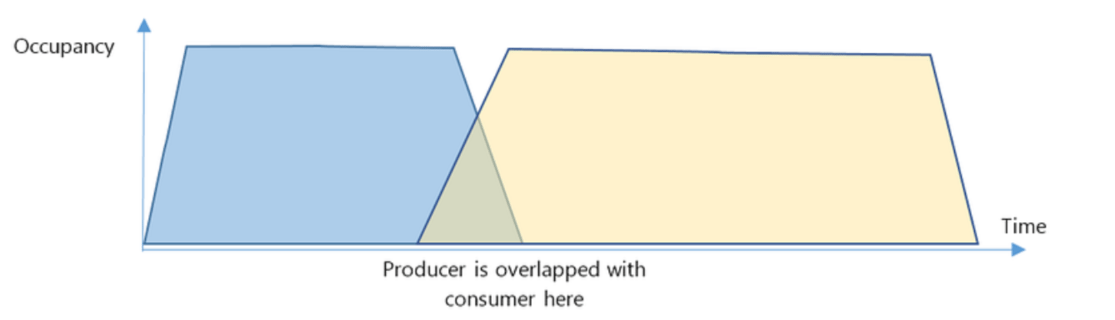
Mecanismos de sincronização em nível de hardware disponíveis no XBOX Series X|S:
É útil conhecer os pacotes produzidos pelo driver quando usamos Fences ou Partial flushes (ou APIs de sincronização como as Barreiras), pois eles aparecerão nas capturas do PIX sempre que examinarmos um evento de sincronização (e mais detalhes sobre a máscara de bits de cada pacote podem ser vistos na guia de desmontagem de comandos).- ACQUIRE_MEM: esse pacote é usado pelo driver para garantir que uma superfície não esteja mais sendo usada (comandos de desenho ativos) e que todos os caches associados a ela sejam liberados antes das operações subsequentes. Ele é usado pelo driver em operações que exigem a drenagem do CB e do DB (todo o trabalho do CB/DB concluído) junto com a invalidação de um ou mais dos seguintes caches ($K, $I, L0, L1, L2, LM, caches do CB, caches do DB) e/ou o writeback do L2 (siga este link para ver as definições dos caches). Ele funciona da seguinte forma: primeiro aguarda até que o endereço de memória em questão não seja mais referenciado por trabalho em andamento e, em seguida, faz o flush dos caches associados a ele. Ele pode bloquear no PFP ou no ME (esse pacote é executado no topo do pipe).
- RELEASE_MEM: permite inserir um evento (End of Pipe ou End of Shader) no pipeline. Por exemplo, pode ser usado para atualizar o valor de um Fence ou executar operações de memória (invalidação/flushes de cache).
- WAIT_REG_MEM: esse pacote é usado para aguardar até que um local no espaço de registradores ou de memória satisfaça uma função de comparação. Pode ser usado para avaliar fences. O pacote permite definir a função de comparação (por exemplo, equal ref verifica se o valor na memória corresponde ao valor de referência), e a referência é o valor com o qual queremos comparar. Ele também define qual mecanismo aguardará (PFP, ME ou CE), uma máscara para definir quais bits comparar e o intervalo de consulta (com que frequência o mecanismo verificará o espaço de memória/registrador, em ciclos de clock).
- EVENT_WRITE: permite inserir eventos no pipeline. Os partial flushes de VS, PS e CS são do tipo EVENT_WRITE.
- PFP_SYNC_ME: força o PFP a sincronizar com o bloco ME. O PFP encaminha o pacote ao ME e passa a reter os pacotes recebidos até ser liberado pelo ME (o ME concluiu o trabalho e a fila FIFO entre o ME e o PFP está vazia).
- DMA_DATA: permite que o PFP ou o ME instrua o CP DMA a copiar de/para registradores ou memória (em um pacote atômico). O mecanismo que solicita a cópia (PFP ou ME) pode, opcionalmente, aguardar os resultados. É possível especificar se a cópia é síncrona ou assíncrona.
Coerência de cache
O que foi descrito acima conta apenas parte da história, pois ainda precisamos garantir que os acessos à memória estejam sendo executados corretamente. A GPU tem uma estrutura de hierarquia de memória muito mais complicada do que uma CPU, dada a sua carga de trabalho altamente paralela. Seus muitos caches não são coerentes e, por isso, é preciso fazer mais em termos de sincronização. Conceitos importantes ao discutir caches:- Writeback (WB): operação em que um intervalo (ou todas) das linhas de cache é gravado de volta na memória principal (ou em um cache acima na hierarquia).
- Invalidação: quando um cache é invalidado, um intervalo (ou todas) de suas linhas de cache é marcado como inválido, e as leituras futuras são encaminhadas ao próximo cache da hierarquia para buscar um valor atualizado.
- Write-through: as gravações acontecem no cache e também são encaminhadas ao próximo nível.
- Dirty bit: se uma linha de cache estiver marcada como suja (dirty), significa que o cache foi modificado e a memória principal (e outros caches) têm uma cópia desatualizada. Será necessário um flush (WB) (e também marcar esses dados como inválidos em outros caches para que eles possam obter o valor atualizado).
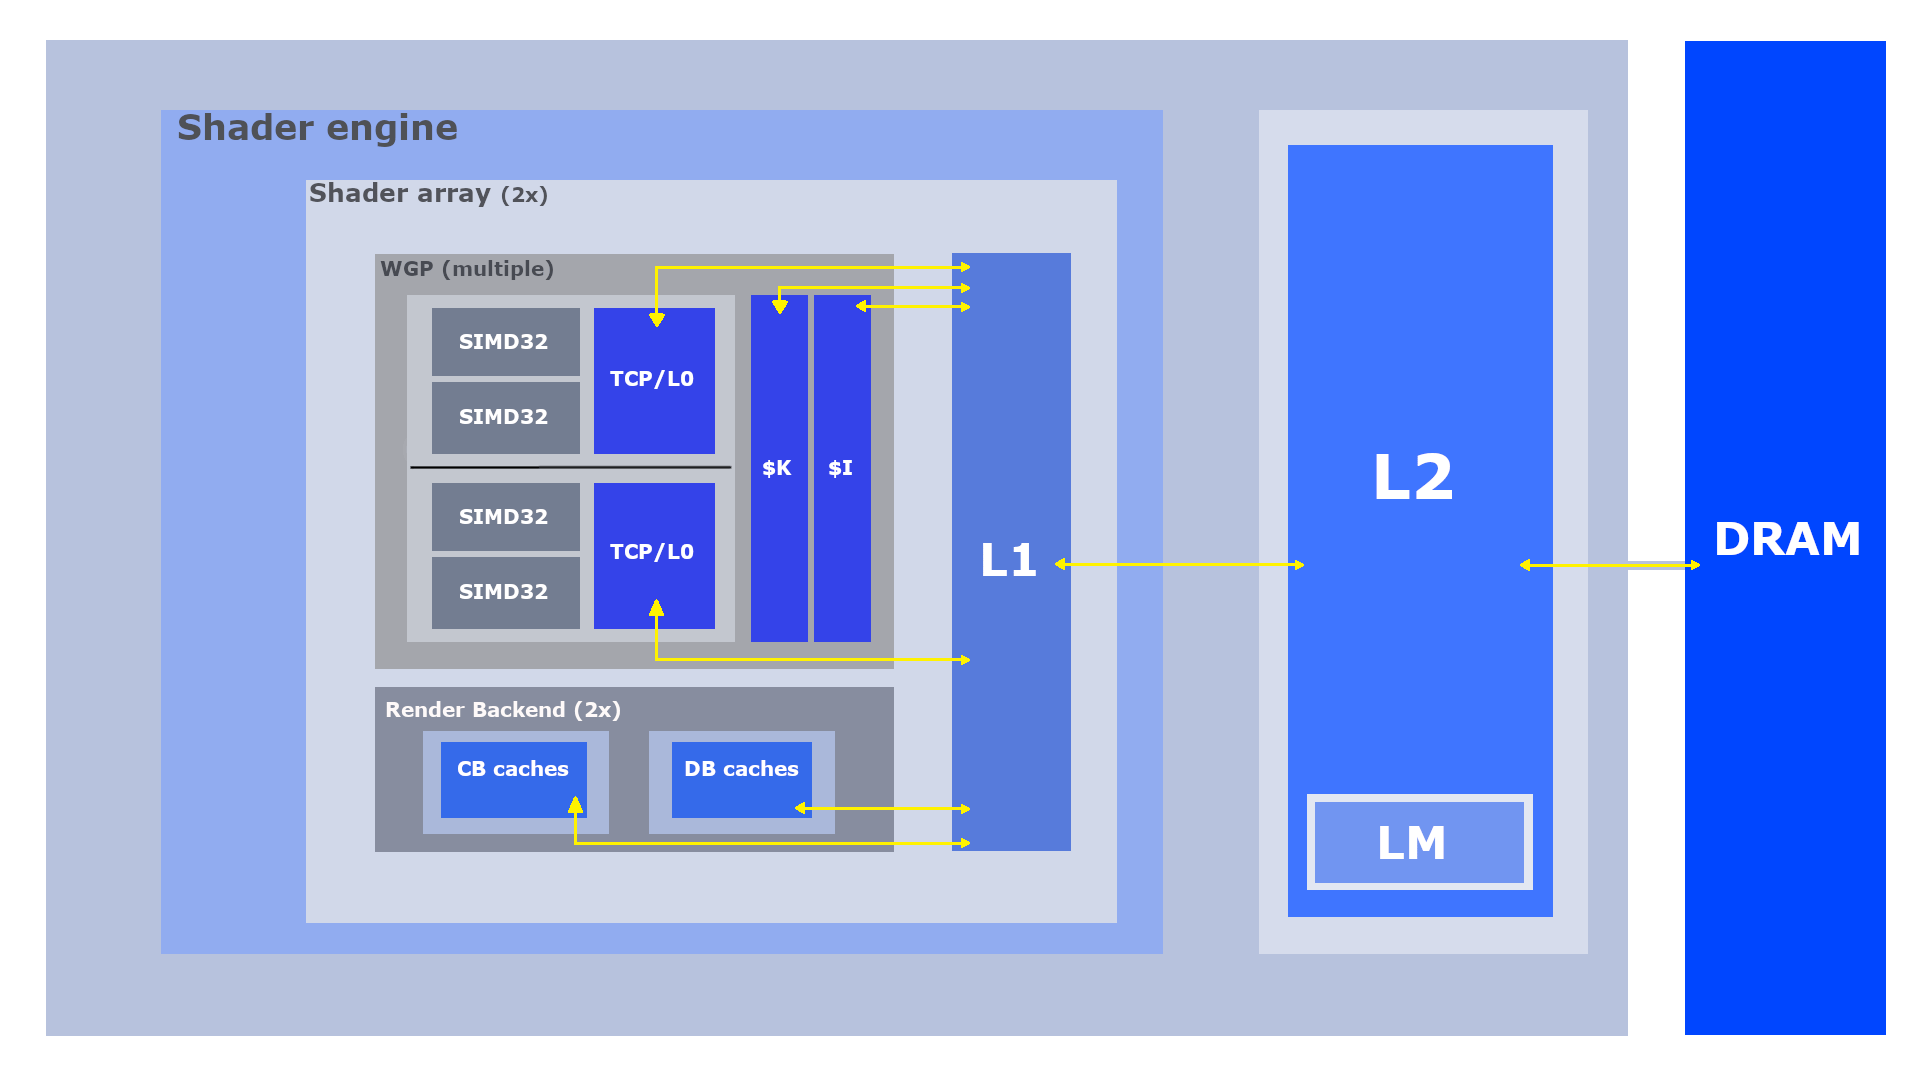
Os caches relevantes no XBOX Series X|S são
Além disso, caches diferentes terão estratégias diferentes para quando fazer writeback/invalidação:
Voltando ao exemplo da transição de uma gravação de CS para uma leitura de PS, agora podemos examinar os caches. As gravações de UAV usam os caches L0-L1-L2 e LM. A SRV também usa os mesmos caches. Como estamos fazendo a transição de um estado de gravação para um de leitura, o L0 e o L1 serão invalidados. O LM também será invalidado, pois o pixel shader poderia potencialmente ler dele. (A invalidação do LM acontecerá somente se o recurso tiver metadados).