
Introduction
Le Scalable Hardware Audio Processing Engine (SHAPE) fournit une accélération matérielle pour un certain nombre des blocs de construction les plus courants de la lecture et de la manipulation audio. Un titre contrôle entièrement la configuration et l’ordre des blocs de traitement SHAPE, gérés par l’Audio Control Processor (ACP). L’ACP est un composant matériel. Le titre crée des chemins définis pour enchaîner un ou plusieurs composants SHAPE de l’entrée à la sortie. Ces chemins sont appelés graphes de flux (flowgraphs). Une fois créé, chaque graphe de flux est soumis sous forme d’une série de commandes que l’ACP doit traiter. Cette rubrique présente les bonnes pratiques pour créer et soumettre des graphes de flux qui mettent en œuvre avec succès les scénarios d’exécution que vous rencontrerez le plus fréquemment, ainsi que les configurations à éviter pour optimiser les performances. Cette rubrique couvre les points suivants :- Composants et fonctionnalités de SHAPE
- Scénarios peu performants et cas pathologiques
- Planification et révision des graphes de flux SHAPE
- Graphes de flux persistants et non persistants
- Débogage des problèmes SHAPE
Composants et fonctionnalités de SHAPE
Les files d’attente de commandes sont automatiquement gérées et remplies par l’ACP lorsque les graphes de flux sont soumis au matériel. Le tableau suivant présente une liste consolidée des composants et de leurs capacités d’instanciation.
Le tableau suivant présente une liste consolidée des composants et de leurs règles de routage des mémoires tampons de mixage.
| Composant SHAPE| Mémoires tampons de mixage d’entrée par instance| Mémoires tampons de mixage de sortie par instance|
| --- | --- | --- | --- | --- | --- | --- | --- | --- |
| XMA| Non applicable. Lit depuis la mémoire.| Non applicable. Décode vers la mémoire, généralement consommé par SRC.|
| SRC| 0 ; lit depuis la mémoire.| 1 pour le mono, 2 pour la stéréo.|
| FLT/VOL| 1.| 1.|
| EQ/CMP| 1 (ou 2, pour les configurations sidechain).| 1.|
| MB| Non applicable. Les mémoires tampons de mixage ne peuvent pas lire directement depuis d’autres mémoires tampons de mixage.| Non applicable. Les mémoires tampons de mixage ne peuvent pas écrire directement dans d’autres mémoires tampons de mixage.|
| DMA| 1 ; jusqu’à 32 trames audio par transfert.| 1 ; jusqu’à 32 trames audio par transfert.|
Pour plus de détails sur les blocs de construction de SHAPE, consultez la présentation Xfest associée The Sound of XBOX One (Conference Material > Xfest 2012) et le livre blanc The Sound of the Future (Developer Education Materials > All NDA Whitepapers).
Remarque sur les scénarios d’utilisation des graphes de flux
De nombreux titres n’implémenteront peut-être jamais directement de graphes de flux. XAudio2 implémente implicitement les composants SHAPE, et les intergiciels audio peuvent masquer les graphes de flux matériels aux développeurs de titres. Cependant, la construction de graphes de flux vous permet de tirer directement parti des capacités d’accélération audio de la console XBOX One, en particulier si vous développez et implémentez votre propre solution de rendu audio ou si vous disposez d’une configuration personnalisée qui n’est pas prise en charge par XAudio2 ou par un intergiciel. Pour tous les titres que vous développez, il est utile de comprendre les capacités de SHAPE, décrites plus loin dans cette rubrique, et de planifier à l’avance les topologies potentielles de graphes de flux.Scénarios peu performants et cas pathologiques
Les sections suivantes décrivent des scénarios courants pouvant entraîner des problèmes de performances. Elles fournissent également des recommandations pour éviter ces problèmes.Graphes de flux mal formés
Vous pourriez créer des graphes de flux qui construisent des flux de signal impossibles ou des données qui ne sont jamais réalisées en sortie. Voici quelques-unes des erreurs les plus courantes lors de la création de graphes de flux.- Références à des objets SHAPE qui ne sont pas créés ou alloués
- Commandes ou paramètres non valides
- Exactitude du comptage de références d’entrée/sortie des mémoires tampons de mixage
- Réallocation d’un ID virtuel de mémoire tampon de mixage existant
- Omission de mémoires tampons de mixage de connexion entre les composants SHAPE
- Utilisation de plus d’une seule mémoire tampon de mixage comme sortie d’un composant SHAPE, à l’exception du bloc SRC, qui peut être acheminé vers deux mémoires tampons de mixage lors du rendu de contenu stéréo
- Références circulaires dans les mémoires tampons de mixage Une mémoire tampon de mixage ne devient disponible que lorsque toutes ses entrées sont présentées et que ses sorties sont consommées. Si une référence circulaire existe dans une mémoire tampon de mixage, celle-ci a en fait un nombre infini d’entrées, ne devient jamais disponible et bloque le graphe.
- Mémoires tampons de mixage orphelines Une mémoire tampon de mixage sans sortie devient disponible immédiatement lorsque sa dernière entrée est traitée. Une mémoire tampon de mixage destinée au rendu vers un périphérique audio (par exemple, des haut-parleurs ou un casque) doit se terminer par un bloc de sortie DMA. Cela présente la mémoire tampon de mixage à la mémoire principale pour le mixage final.
Ordre des commandes
L’ACP remplit automatiquement les files d’attente de commandes de chaque composant SHAPE. Lors du remplissage des files d’attente, l’ACP ignore les commandes suivantes destinées à un composant particulier jusqu’à ce que les entrées de ce composant soient libres. En général, le fait d’ignorer des commandes représente une pénalité de performances négligeable. Cependant, selon l’ordre des commandes, les titres peuvent créer un ordre sous-optimal des composants SHAPE. Une ou plusieurs files d’attente non pleines attendraient alors d’autres files d’attente. Cette attente réduit le nombre d’instances disponibles par trame. La figure 1 montre comment l’ordre des commandes peut affecter les performances. Comme bonne pratique, émettez les commandes FLT/VOL de haut en bas, comme indiqué dans le graphe de flux, plutôt que de gauche à droite, ce qui permet de terminer davantage de voix. Cette méthode permet à un EQ/CMP, illustré en bas du graphe de flux, d’être traité en parallèle. Figure 1. Graphe de flux montrant comment émettre les commandes FLT/VOL de haut en bas, plutôt que de gauche à droite, afin de permettre le traitement en parallèle d’un EQ/CMP et d’améliorer les performances.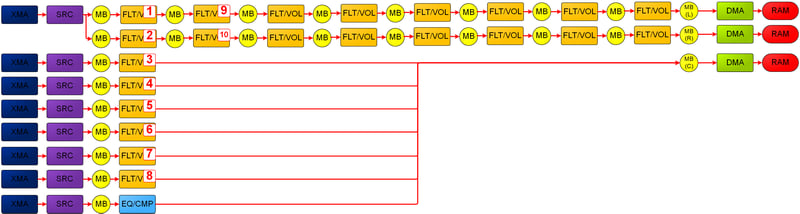
Allocation des instances de mémoire tampon de mixage
Les mémoires tampons de mixage sont verrouillées pendant l’écriture. Aucune sortie ne peut y être lue tant que toutes les entrées n’ont pas contribué au mixage. Du point de vue de l’implémentation, les mémoires tampons de mixage utilisent les champsnumIn et numOut pour gérer cela. Il est donc possible de construire des scénarios qui nécessitent plus de 128 mémoires tampons de mixage physiques en même temps.
SHAPE virtualise les mémoires tampons de mixage de sorte que, même avec une polyphonie élevée, ce scénario ne pose généralement pas de problème. Toutefois, vous pouvez construire des graphes de flux qui nécessitent un accès simultané à un grand nombre de mémoires tampons de mixage. En particulier, les mémoires tampons de mixage qui effectuent un sous-mixage ou un mastering de plusieurs voix sont verrouillées jusqu’à ce que la dernière voix y soit mixée et que la dernière sortie des mémoires tampons de mixage soit consommée par un bloc SHAPE ultérieur.
Dans un scénario typique, une seule voix de mastering 7.1 dans laquelle toutes les voix SHAPE sont mixées, 8 des 128 voix sont verrouillées pendant toute la trame. Des mémoires tampons de mixage supplémentaires peuvent être verrouillées pendant une partie importante de la trame (réduisant la capacité des mémoires tampons de mixage virtuelles) en cas de sous-mixage multicanal étendu avec des chaînes de dépendances de graphes de flux. Par ailleurs, des voix de mastering supplémentaires sont créées si, par exemple, vous deviez créer à la fois un mixage pour les haut-parleurs principaux et un mixage casque 7.1 par joueur pour un titre à quatre joueurs, ce qui pourrait consommer 40 mémoires tampons de mixage simultanées.
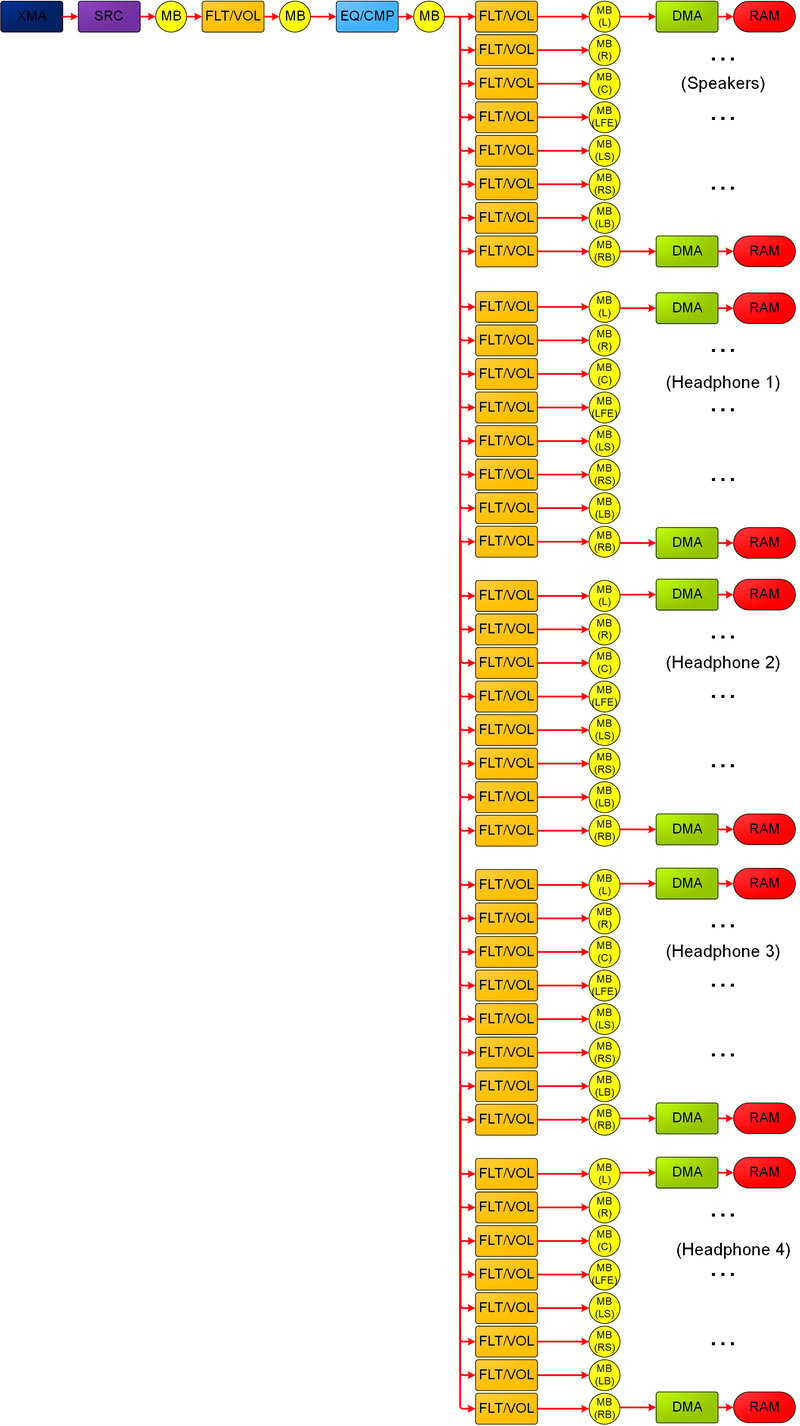
En général, un cas qui nécessite plus de 128 mémoires tampons de mixage physiques simultanées est pathologique. Cependant, les mémoires tampons de mixage verrouillées inutilement pendant toute la trame réduisent la capacité de votre titre à atteindre le débit potentiel. La figure 2 représente un sous-mixage inutile qui pourrait réduire le nombre de mémoires tampons de mixage disponibles à un moment donné.
Selon l’ordre des commandes (figure 2), les 5 mémoires tampons de mixage de mastering 7.1 distinctes pourraient être verrouillées pendant presque toute la trame, ce qui représente 40 des 128 mémoires tampons de mixage physiques. Bien que ce chemin ne nécessite que 2 autres mémoires tampons de mixage utilisées à la fois, c’est-à-dire l’entrée et la sortie associées pour un FLT/VOL ou un EQ/CMP, envisagez de traiter d’abord toutes les mémoires tampons de mixage destinées aux haut-parleurs. Vous pouvez ensuite libérer ces mémoires tampons de mixage et traiter les casques 1, 2 et suivants.
Figure 2. Graphe de flux montrant un sous-mixage inutile et le verrouillage d’instances de mémoire tampon de mixage allouées en raison d’un mauvais ordre des commandes.
Sélection et équilibrage des composants SHAPE (FLT/VOL et EQ/CMP)
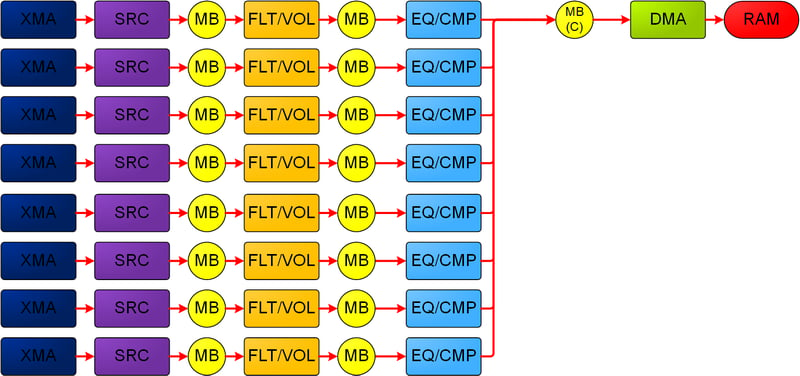
Si vous utilisez les mêmes composants SHAPE de manière répétée en séquence, vous pouvez réduire la capacité à atteindre le débit maximal. En revanche, en alternant différents composants, vous vous assurez que chaque bloc SHAPE effectue un traitement parallèle utile. La figure 3 montre un exemple courant : les FLT/VOL ne peuvent pas tous être traités en parallèle. Les performances peuvent en pâtir. Figure 3. Graphe de flux montrant une tentative de traitement en parallèle de tous les FLT/VOL.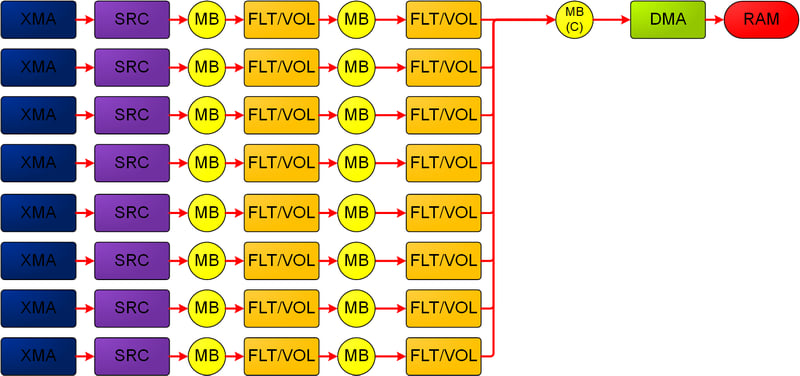
Allers-retours DMA trop nombreux, trop fréquents ou de faible valeur
Le DMA est limité par la bande passante de lecture/écriture disponible sur le bus de SHAPE. Si vous consommez toute la bande passante disponible (bien que ce scénario soit généralement pathologique), les blocs DMA se bloquent et réduisent le débit. Comme indiqué précédemment, tout le traitement qui a lieu après un bloc d’entrée DMA doit attendre que le DMA soit terminé. Vous pouvez donc créer des graphes de flux dont une grande partie est bloquée en attendant la fin d’un DMA avant de pouvoir commencer le traitement. Vous devez également évaluer les allers-retours DMA par rapport à la valeur qu’ils apportent au flux audio. L’ajout minimal de latence (que vous pouvez contrôler en termes de nombre de trames accédées via DMA, par multiples de la taille de trame audio de 2,667 ms) n’est peut-être pas un problème pour la plupart des scénarios de lecture audio. En effet, les blocs situés à droite d’un DMA traitent des données audio des trames précédentes. En particulier, renvoyer un DMA dans SHAPE uniquement pour effectuer un mixage final peut être inutile si vous prévoyez également de renvoyer ce mixage final par DMA vers la mémoire pour le présenter à un point de terminaison audio. La figure 5 montre un exemple de valeur potentiellement faible, où une voix envoyée par DMA vers la mémoire pour un traitement CPU/GPU est ramenée dans SHAPE, uniquement pour être panoramisée en 7.1 dans le mixage de mastering. La voix est ensuite renvoyée par DMA vers la mémoire. La figure 5 suppose qu’aucun filtrage n’est appliqué aux voix dans les blocs FLT/VOL et que d’autres voix sont acheminées vers les mémoires tampons de mixage de mastering 7.1. Figure 5. Graphe de flux montrant un routage potentiellement de faible valeur, impliquant des composants FLT/VOL inutiles et des allers-retours DMA inutiles.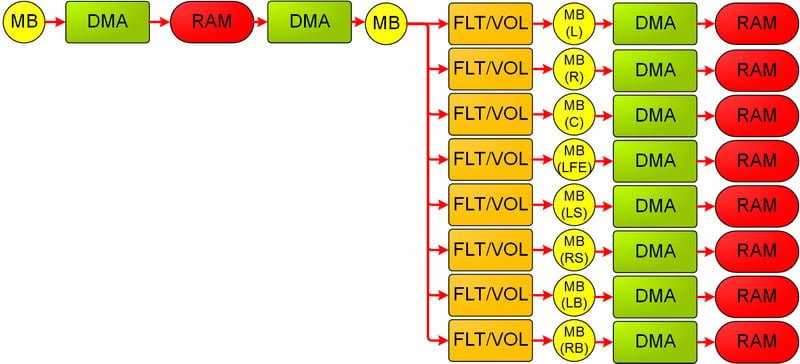
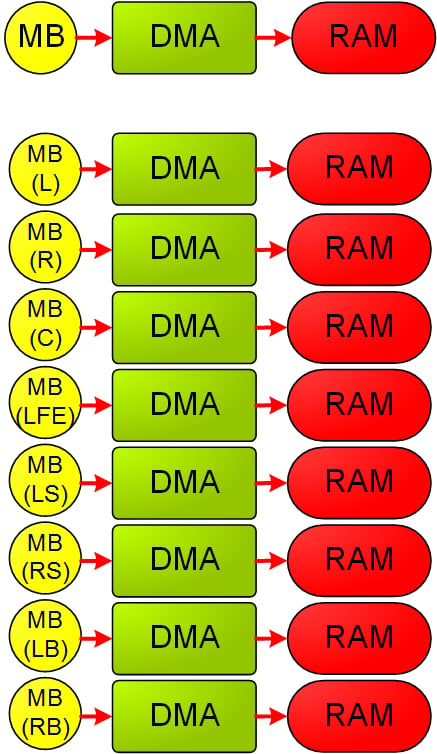
- Prévoyez d’effectuer une quantité importante de traitement SHAPE supplémentaire pour une voix particulière.
- Souhaitez tirer parti de la mesure matérielle et de la détection d’écrêtage offertes par les mémoires tampons de mixage.
Planification et révision des graphes de flux SHAPE
À titre d’exercice, avant l’implémentation, créez une représentation visuelle d’un graphe de flux de l’utilisation des voix que vous prévoyez dans une trame, avec les voix catégorisées et quantifiées, par exemple en termes de nombre d’effets sonores et de flux musicaux simultanés. La capture visuelle de ces informations peut vous aider à comprendre comment éviter certains des pièges de performances évoqués précédemment. Voici quelques-unes des principales mesures que vous pouvez déduire d’un tel graphe de flux.-
Le nombre maximal de chaque composant SHAPE, simultanés et sur l’ensemble de la trame :
- Vérifiez que ce graphe de flux se situe suffisamment en dessous des pics théoriques.
- Notez la sous-utilisation et la surutilisation des composants. Rééquilibrez les composants si nécessaire.
- Envisagez de restructurer l’utilisation des mémoires tampons de mixage si un trop grand nombre doivent rester verrouillées pendant la majeure partie du graphe de flux.
-
Planification de l’implémentation du positionnement 3D via SHAPE :
- Toutes les voix seront-elles panoramisées en 7.1, ou seront-elles panoramisées entre les 2 ou n haut-parleurs les plus proches ?
- Tout le panoramique 7.1 doit-il être effectué dans SHAPE, ou est-il préférable de panoramiser directement sur le CPU les voix qui ont déjà été envoyées par DMA au CPU ?
- Nombre de transitions DMA vers et depuis la mémoire, et caractère asymétrique ou non de ces transitions. Par exemple, certaines voix sont écrites vers et depuis SHAPE plus de fois que d’autres, ce qui signifie qu’elles auront probablement une latence supplémentaire.
Graphes de flux persistants et non persistants
Vous pouvez soumettre des graphes de flux à traiter de manière persistante ou non persistante. Les graphes de flux persistants effectuent leur traitement puis restent résidents pour le répéter à la trame suivante, une fois que les pointeurs de lecture et d’écriture ont avancé et que les autres informations de contexte ont été mises à jour. Utilisez des graphes de flux persistants dans l’un des scénarios suivants.- Graphes de flux très complexes : graphes de flux qui nécessitent une quantité importante de traitement CPU pour être réassemblés à chaque trame
- Graphes de flux très statiques : graphes de flux qui conservent le même nombre et la même configuration de voix pendant une période prolongée
- Les topologies de voix changent souvent.
- La cadence de traitement du moteur logiciel audio de votre titre est dissociée du matériel SHAPE, c’est-à-dire qu’elle n’est pas un multiple de 2,667 ms.
- Vous souhaitez exécuter le traitement audio dans des scénarios plus rapides que le temps réel, c’est-à-dire lorsque vous soumettez des graphes pour qu’ils soient consommés dès qu’ils deviennent disponibles.
Débogage des problèmes SHAPE
Lorsque vous développez des graphes de flux, nous vous recommandons de vous inscrire aux messages qui vous aideront à déboguer les problèmes. Plus précisément, utilisez le paramètreNumMessages de la méthode IAcpHal::Connect.
Le système de messagerie fournit des retours détaillés sur divers problèmes, notamment les graphes de flux non valides (comme ACP_FLOWGRAPH_TERMINATED_REASON_INVALID_GRAPH), les commandes bloquées et les dépassements de trame causés par des tentatives d’effectuer plus de traitement que la taille de trame matérielle de 2,667 ms ne le permet.
Cette méthode est utile pour le débogage. Cependant, avant la sortie de votre titre, essayez d’effectuer les opérations suivantes :
- Éliminez tous les messages indiquant des erreurs dans les scénarios d’exécution.
- Vérifiez que le traitement des graphes de flux réussit systématiquement en examinant les messages
ACP_MESSAGE_TYPE_FLOWGRAPH_COMPLETED(voir l’énumération ACP_MESSAGE_TYPE) pour chaque graphe de flux soumis.
Messages manqués
Si vous utilisez les messages ACP pour piloter l’état du moteur et que vous gérez un grand nombre de messages, vous devez examinerACP_MESSAGE::droppedMessageCount pendant le développement. Une valeur non nulle indique que la file d’attente de messages était pleine et que des messages ont dû être abandonnés. Dans ce cas, envisagez de traiter la file d’attente plus rapidement et de l’agrandir.
Dépassements de trame
Pendant le développement, en raison d’un dépassement de budget, de graphes de flux sous-optimaux ou pour d’autres raisons, un graphe de flux peut ne pas être terminé avant la fin d’une trame audio (2,667 ms). Ce graphe de flux incomplet entraîne un messageACP_FLOWGRAPH_TERMINATED_TIME_EXCEEDED pour les graphes de flux persistants. Ceux-ci resteront incomplets. En revanche, un graphe de flux non persistant n’est pas soumis à cette contrainte et s’exécute jusqu’à ce qu’il soit terminé, même sur plusieurs trames.
Commandes bloquées
Les commandes SRC et DMA peuvent être signalées comme bloquées (ACP_MESSAGE_TYPE_SRC_BLOCKED et ACP_MESSAGE_TYPE_DMA_BLOCKED (voir l’énumération ACP_MESSAGE_TYPE)) dans plusieurs scénarios, comme indiqué dans le tableau suivant.
Une fois qu’il est déterminé que des commandes sont bloquées (ce qui peut se produire à la fois avant l’ajout d’éléments à une file d’attente SHAPE pour traitement et pendant l’exécution), les commandes sont évincées du graphe. Cela peut entraîner des pertes audio. Pendant le développement, examinez en premier lieu les commandes bloquées pour améliorer la gestion des graphes de flux. Avant la sortie, votre titre doit également empêcher le blocage des commandes.
Vous pouvez empêcher le blocage des commandes DMA en veillant à ce que votre mémoire tampon audio soit suffisamment grande et que les données soient diffusées à intervalles réguliers par rapport à la taille de la mémoire tampon. Par exemple, si vous diffusez quatre trames matérielles à la fois, assurez-vous qu’un multiple de ces trames (au moins en double mise en mémoire tampon, soit huit) se trouve dans la mémoire tampon afin de permettre au matériel d’écrire en avance sur le pointeur de lecture du titre. Vous pouvez également imposer le vidage de la mémoire tampon avant de soumettre le graphe de flux suivant en consommant les données, en mettant à jour le pointeur de lecture DMA, puis en soumettant le graphe de flux.
Les commandes SRC disposent des trois modes suivants (détaillés dans ShapeSrcContext.h).
-
SHAPE_SRC_COMMAND_TYPE_STARTUtilisez-le pour presque toutes les commandes SRC d’un graphe de flux. Le traitement s’effectue normalement, et d’autres données audio sont attendues après le graphe de flux actuel. -
SHAPE_SRC_COMMAND_TYPE_STOP_IMMEDIATEUtilisez-le pour arrêter immédiatement le traitement des données sources XMA ou PCM. Le SRC produira une mémoire tampon remplie de zéros pour cette trame. -
SHAPE_SRC_COMMAND_TYPE_STOP_ENDUtilisez-le pour indiquer le dernier paquet d’une voix. Si elle n’est pas soumise avecSTOP_ENDouSTOP_IMMEDIATE, la commande SRC ne sera pas terminée. Le graphe de flux actif se bloquera alors. Un graphe de flux persistant se terminera à la fin de la trame audio, et un graphe de flux non persistant ne sera jamais terminé.