
建置 Streaming 範例與內容工具
若要建置範例,請確定您擁有已更新的 Visual Studio 2017 開發環境、已安裝 1911 GDK,並已安裝 17134 或更新版本的 Windows SDK。開啟解決方案時,如果尚未安裝所有必要的 Visual Studio 功能,系統將自動要求安裝。開啟解決方案 (Streaming\Streaming.sln) 並重建解決方案。發行和分析組建比偵錯組建快得多,但偵錯組建可透過偵錯層進行 Direct3D 12 API 驗證。建立並部署紋理內容
建置 ContentTool 的發行組建。使用下列命令列執行它: contenttool.exe 64 8192 c:\temp “c:\temp” 參數可替換為任何其他合適的暫存目錄位置。這些選項將產生 64 組 8192 × 8192 具 mipmap 的並排紋理 (漫反射-法線-鏡面反射),總計約 10 GB 的內容。ContentTool 在建立紋理期間會耗用大量記憶體。建議在至少具有 16 GB 記憶體的系統上執行。 將 ContentTool 產生的紋理內容 (.trimg 和 .trdata 檔案) 複製到 Streaming 範例配置中的 “streamingtextures” 子目錄,然後進行部署。 對於 Streaming 開發測試的通用 Windows 平台 (UWP) 組建,紋理檔案必須部署到套件的暫存目錄位置。部署不含內容的 Streaming 應用程式 UWP 組建,並執行一次。範例啟動後會顯示紋理內容遺失的訊息,並開啟檔案總管視窗至應用程式暫存目錄中的某個位置。將紋理資料檔案複製到該暫存目錄的 “streamingtextures” 子目錄。 成功部署內容後,範例啟動時應會顯示彩色立方體網格,如下圖所示。
控制項與使用方式
此範例是針對 XBOX 控制器所設計。對於範例的桌面組建,建議您將 XBOX 控制器連接到開發電腦。如果無法這樣做,也可以使用下表詳述的鍵盤和滑鼠控制項。偵錯選項與檢視
- 可使用第一個功能表選項循環切換轉譯模式。場景著色器複雜度可從一層 (漫反射-法線-鏡面反射) 提高到三層 (各三組漫反射-法線-鏡面反射)。此外,也可以將 MinMip 對應重疊在場景幾何上。
- 串流統計資料預設為啟用,可在 Streaming Debug Views 功能表中切換。串流統計資料包括處理中圖格數量的即時計數器、所有紋理的總虛擬大小、圖格集區的容量和佔用率、延遲統計資料、瓶頸,以及每個 mip 的常駐/曾存取統計資料。
- 可以檢查個別串流紋理,包括主要 (並排資源) 紋理及其相關聯的 MinMip 和 MinMip 回饋對應。只要在 Streaming Debug Views 功能表中啟用 Debug Texture Mode,然後使用相機控制項將瞄準十字線對準場景物件即可。系統會顯示其紋理,並可在第一層的漫反射、法線或鏡面反射對應之間選擇。
- 可在 Streaming Debug Views 功能表中啟用各種串流子系統的 CPU 計時。
串流引擎概觀
Streaming 範例中的紋理串流引擎是針對串流個別 64 KB 圖格而設計。圖格儲存在記憶體中的單一圖格集區 (一個 ID3D12Heap 物件),預設大小為 512 MB。紋理串流引擎中可以具現化任意數量的並排紋理,唯一的限制是追蹤並排紋理資源及其相關聯 MinMip 和 MinMip 回饋對應之著色器資源檢視與無序存取檢視的描述元堆積最大大小。 下圖代表紋理串流引擎中個別並排紋理的作業週期。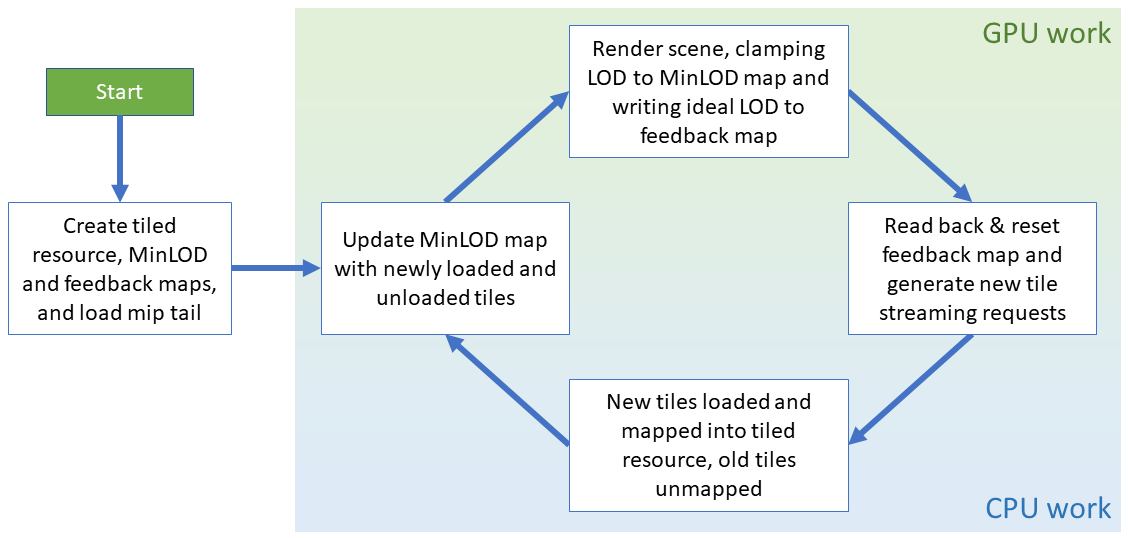
並排紋理建立與場景圖設定
在串流引擎中建立並排紋理時,會建立下列三個資源。- 並排紋理本身,透過
ID3D12Device::CreateReservedResourceAPI 建立。 - 小型 MinMip 對應,使用並排紋理的維度除以該格式中單一 64 KB 圖格的維度來建立。例如,BC1 格式的 8192 × 8192 並排紋理會產生 16 × 32 紋素的 MinMip 對應,因為 BC1 中的 64 KB 圖格維度為 512 × 256。
- 小型 MinMip 回饋對應,維度與 MinMip 對應相同。
ID3D12Device8::CreateSamplerFeedbackUnorderedAccessViewX API 為 MinMip 回饋對應建立無序存取檢視 (UAV) 描述元。
為了提高效率,MinMip 回饋對應不會建立為個別資源。而是建立為較大的 Texture2DArray 不透明資源的子配置配量,該資源是透過 ID3D12Device8::CreatePlacedResource1 API 建立。之所以能採用此策略,是因為許多 MinMip 回饋對應共用相同的維度。將它們建立為較大的紋理陣列,可確保硬體擁有最有效率的記憶體封裝配置,此外也確保 MinMip 回饋對應在記憶體中是連續的,從而能非常有效率地進行大量清除和轉碼。
場景圖保存 GPU 可見的描述元,並以每個物件的順序排列。當場景物件連同其相關聯的材質 (並排紋理的選取組合) 一起具現化時,描述元會從串流引擎的描述元堆積複製到場景圖的 GPU 可見描述元堆積。
在建立並排紋理時,會從硬碟載入封裝 mip 尾端 (所有小於 64 KB 圖格大小的 mip 層級),並對應到並排紋理中,而 MinMip 對應則會以第一個封裝 mip 層級的值清除。
場景轉譯與取樣器回饋
轉譯場景之前,系統中的所有回饋對應都會大量清除為回饋對應中可能的最大值:二進位值 0xFF,或 5.3 不帶正負號定點編碼中的 31.875。 在場景轉譯期間,會取樣 MinMip 對應以產生細節層級 (LOD) 限制值,然後套用該限制值來取樣並排紋理。另外,會針對並排紋理收集取樣器回饋,並寫入 MinMip 回饋對應,而不套用 LOD 限制。取樣器回饋是透過高階著色器語言 (HLSL) 函式FeedbackTexture2D::WriteSamplerFeedback 執行。
取樣器回饋資料具有高度冗餘性。對於相當接近相機的物件,任何特定 64 KB 圖格的螢幕涵蓋範圍保證會相當大。因此,場景著色器預設只執行 1/128 (0.7%) 的取樣器回饋作業。
取樣器回饋資料回讀與分析
CPU 在每個畫面格回讀取樣器回饋資料,以決定接下來需要載入哪些圖格。首先,使用計算著色器將取樣器回饋資料從 GPU 可寫入的回饋陣列紋理資源大量複製到 CPU 可讀取的放置足跡中。接著,CPU 程式碼會逐一查看 MinMip 回饋對應的每個紋素。對於每個紋素,會將 MinMip 回饋值與圖格資料庫比較,以判斷該紋理在該 mip 層級中該位置所需的圖格是否存在。如果圖格不存在,會為該圖格建立圖格追蹤項目,並加入 “Seen Tiles” 佇列。如果圖格已存在,則會標記目前的時間戳記。 處理 MinMip 回饋對應之後,“Seen Tiles” 清單會依 LOD 層級排序,並從最大的 LOD 層級開始,將部分圖格排入佇列以從硬碟載入。載入圖格之前,必須先配置壓縮圖格資料的暫存儲存空間,以及圖格集區中的目的地位置。暫存儲存空間和圖格集區儲存空間的可用性,是決定一次可載入多少圖格的主要限制因素。 圖格排入載入佇列後,會啟動非同步 Win32 檔案 IO 作業以載入圖格。在數個畫面格後完成時,資料會解壓縮至解壓縮暫存位置。在檔案載入和解壓縮的同時,圖格也會排入佇列,以透過ID3D12CommandQueue::UpdateTileMappings API 對應到 GPU 上的並排資源。任何特定圖格的載入和對應都可能需要數個畫面格才能完成。
圖格完成與淘汰至 MinMip 對應更新
在每個畫面格中,串流引擎會監視各種佇列,以了解圖格載入和解壓縮的完成情況,以及圖格對應的完成情況。已完成載入、解壓縮和對應的圖格會放入 “Complete Tiles” 清單中,現在已準備好透過更新 MinMip 對應來公開給場景轉譯。這些更新會排入佇列,並在每個 MinMip 對應的 CPU 暫存複本中執行,然後使用ID3D12GraphicsCommandList::CopyTextureRegion 透過紋理複製傳輸到 GPU 可讀取的 MinMip 對應。
“Complete Tiles” 清單也會在每個畫面格依時間戳記排序。任何時間戳記早於特定閾值 (兩秒) 的圖格都會被視為已淘汰,並標記為取消對應和刪除。取消對應的圖格也會導致 MinMip 對應的更新,這些更新會與新載入圖格的 MinMip 對應更新一起排入佇列並處理。