
Introduction
La XBOX One apporte les capacités avancées d’un GPU Direct3D 11 moderne dans l’univers des consoles. Le GPU de la XBOX One se démarque des générations de consoles précédentes, tant par ses performances brutes que par sa structure. Les développeurs graphiques qui ciblent la XBOX One devront bien comprendre les points forts et les capacités du matériel sous-jacent. Le schéma fonctionnel de la figure 1 présente bon nombre des composants importants du GPU de la XBOX One. Ce schéma ne montre que les éléments clés intéressant les développeurs et ne représente pas fidèlement la taille physique ni la disposition des composants. Ce livre blanc a été mis à jour avec la terminologie et les spécifications matérielles finales. Les cœurs de shader s’appellent désormais unités de calcul. Un vecteur d’exécution de shader de 64 threads est désormais appelé wave. La mémoire partagée locale et la mémoire partagée globale sont désormais appelées respectivement magasin de données local et magasin de données global. La fréquence d’horloge est passée de 800 MHz à 853 MHz. Figure 1. Schéma fonctionnel du GPU de la XBOX One.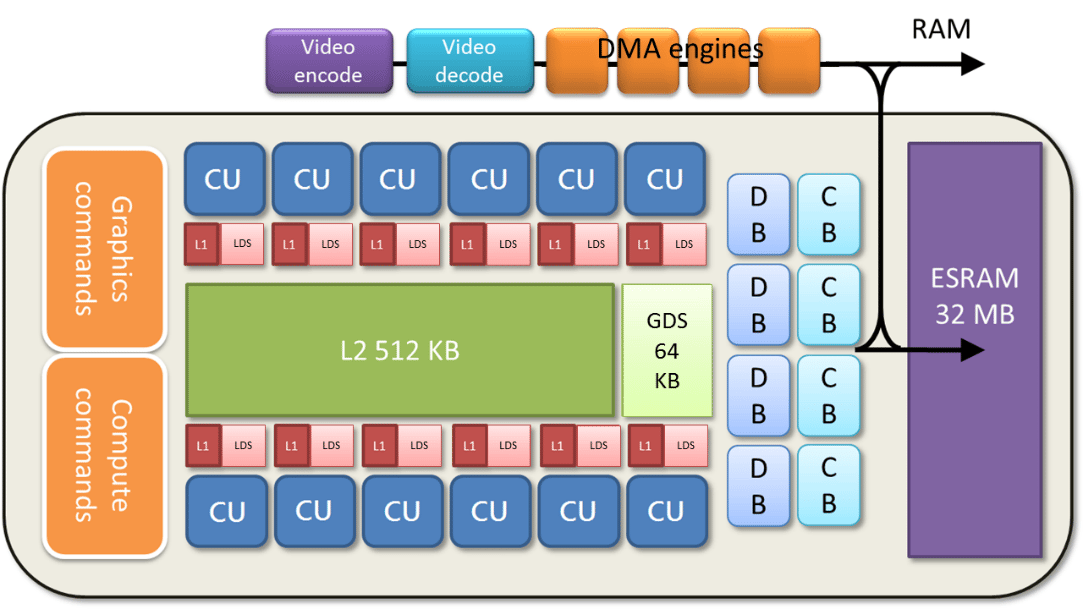
Termes et abréviations
Les termes utilisés dans la figure 1 et ailleurs dans ce document sont définis dans cette section. Certaines abréviations sont standard, tandis que d’autres sont propres à ce document. Des descriptions plus détaillées des termes et abréviations sont fournies dans les sous-sections correspondantes du document.Performances
Le tableau suivant décrit les performances attendues du GPU de la XBOX One. N’oubliez pas que ce tableau est basé uniquement sur les spécifications matérielles, et non sur du matériel réel exécutant du code réel. Pour de nombreuses raisons, les performances maximales théoriques peuvent être difficiles, voire impossibles, à atteindre avec des charges de traitement réelles.Comparaison des GPU de la XBOX 360 et de la XBOX One
De nombreux développeurs XBOX One ont une expérience de la XBOX 360. Pour ces développeurs, il sera important de rompre avec d’anciennes habitudes. Voici quelques différences clés entre les deux GPU. Les sections suivantes de ce document détaillent ces différences.
Les composants et capacités du GPU de la XBOX One sont décrits plus en détail dans les sections suivantes de ce document.
Processeur de commandes
La XBOX One prend en charge plusieurs flux de commandes GPU entrelacés au niveau matériel. Certains flux de commandes contiennent des commandes de rendu, d’autres sont réservés au calcul. Les deux types de flux de commandes progressent dans le GPU en même temps, en partageant les ressources de calcul et de bande passante, ce qui permet de découpler le travail de calcul du travail de rendu. En particulier, les tâches de calcul peuvent passer devant les tâches de rendu en attente, ce qui permet des transferts à faible latence entre le CPU et le GPU.Mémoire
- Adressage virtuel
- ESRAM
- Magasin de données local et magasin de données global
- Caches
- Opérations d’extraction
Adressage virtuel
Sur la XBOX One, tous les accès mémoire du GPU utilisent des adresses virtuelles et passent donc par une table de traduction avant d’être résolus en adresses physiques. Cette couche d’indirection résout au niveau matériel le problème de la fragmentation de la mémoire des ressources : une même ressource peut désormais occuper plusieurs pages non contiguës de mémoire physique sans pénalité. Les adresses virtuelles peuvent cibler des pages de la RAM principale ou de l’ESRAM, ou ne pas être mappées. Les lectures et écritures de shader dans des pages non mappées renvoient des résultats bien définis, y compris des codes d’erreur facultatifs, au lieu de faire planter le GPU. Cette fonctionnalité est importante pour la prise en charge des ressources en mosaïque (tiled resources), qui ne résident que partiellement en mémoire physique.ESRAM
La XBOX One ne dispose pas de mémoire vidéo (VRAM) au sens traditionnel, mais le GPU contient 32 Mo de SRAM intégrée rapide (ESRAM). L’ESRAM de la XBOX One est exempte de nombreuses restrictions qui s’appliquent à l’EDRAM de la XBOX 360. La XBOX One prend en charge les scénarios suivants :- Texturage depuis l’ESRAM
- Rendu vers des surfaces en RAM principale
- Relecture depuis des cibles de rendu sans effectuer de résolution dans certains cas
Magasin de données local et magasin de données global
Chaque unité de calcul du GPU de la XBOX One contient une mémoire tampon de 64 Ko de magasin de données local (LDS). Le LDS fournit un espace de travail aux groupes de threads des compute shaders. Le LDS est également utilisé implicitement à diverses fins. Le compilateur de shaders peut choisir d’y allouer des tableaux temporaires, d’y déverser des données des registres ou d’y mettre en cache des données provenant de la mémoire externe. Le LDS facilite le passage de données d’une étape du pipeline à une autre (par exemple vers les interpolants, les points de contrôle de patch, les facteurs de tessellation ou la sortie de flux). Dans certains cas, cette utilisation implique que les étapes successives du pipeline doivent s’exécuter sur la même CU. Le GPU contient également une mémoire tampon unique de 64 Ko de magasin de données global (GDS). Le GDS contient des données temporaires référencées par un appel de dessin entier. Il est également utilisé implicitement pour appliquer des barrières de synchronisation et pour ordonner correctement les accès aux mémoires tampons d’ajout et de consommation (append et consume) de Direct3D 11. Le GDS peut servir de destination pour l’exportation des shaders ; le pilote peut donc choisir d’y placer de petites cibles de rendu par souci d’efficacité.Caches
La XBOX One dispose d’un système de cache à deux niveaux, illustré à la figure 2. Figure 2. Schéma fonctionnel des principaux caches du GPU ; L2=TCC, L1=TCP.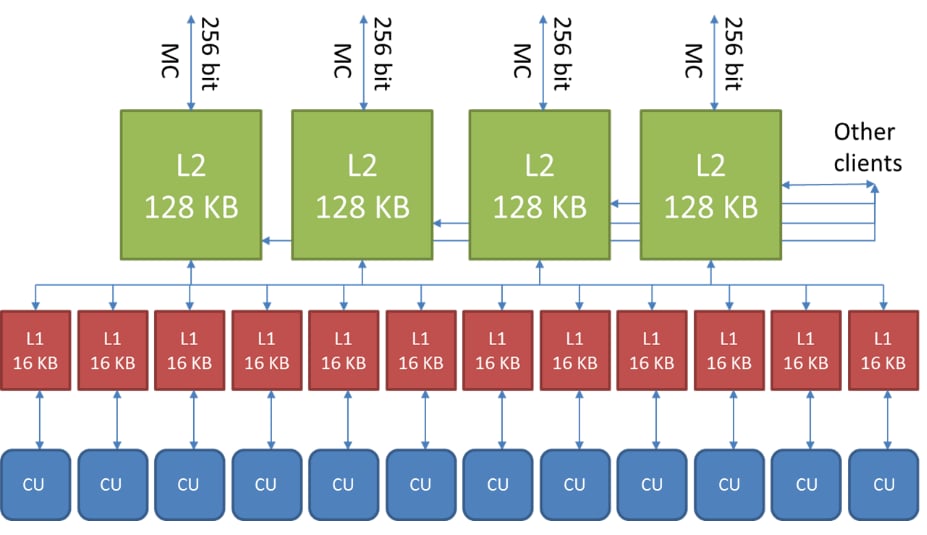
Cache de textures par canal (cache L2)
Le GPU contient quatre caches de textures par canal distincts, associatifs à 8 voies (également appelés caches L2 ou TCC), de 128 Ko chacun, composés de 2 048 lignes de cache de 64 octets. Chaque TCC possède un sous-ensemble donné de l’espace d’adressage. Les motifs de tuilage des textures sont choisis de façon à garantir que les quatre caches sont utilisés de manière égale. Le TCC agit généralement comme un cache à écriture différée (write-back) : lorsque le GPU modifie des données dans une ligne de cache, les modifications ne sont réécrites dans la mémoire principale qu’au moment où la ligne de cache est évincée. Le TCC sert d’intermédiaire pour pratiquement tous les accès mémoire de l’ensemble de la puce et fournit divers types de données, comme le code des shaders, les constantes, les textures et les vertex, provenant de la RAM principale ou de l’ESRAM. Les opérations atomiques des shaders sont implémentées dans le TCC.Cache de textures par pipe (cache L1)
Chaque unité de calcul dispose d’un cache de textures par pipe local, associatif à 64 voies (également appelé cache L1 ou TCP), de 16 Ko, composé de 256 lignes de cache de 64 octets. Le TCP agit généralement comme un cache à écriture immédiate (write-through) : lorsque la CU modifie des données dans le cache, les modifications sont renvoyées au TCC sans attendre l’éviction de la ligne de cache. Le TCP est utilisé exclusivement pour les données lues et écrites par les shaders et est dédié à la fusion des requêtes mémoire pendant la durée de vie d’une wave. Même ce type de mise en cache limité est important, car les accès mémoire ont tendance à être très cohérents spatialement, aussi bien au sein d’un thread qu’entre threads voisins. Le TCP garantit un ordre cohérent par thread ; par exemple, une écriture suivie d’une lecture à la même adresse renvoie la valeur mise à jour. En revanche, le TCP ne garantit pas la cohérence entre threads ou entre waves. Ces exigences doivent être appliquées explicitement, par exemple à l’aide de barrières dans le shader. Les données ne sont pas partagées entre TCP ou entre CU, sauf par réécriture dans le TCC. Contrairement à certains GPU antérieurs (dont celui de la XBOX 360), la XBOX One conserve les données de textures et de mémoires tampons sous leur forme compressée native dans les caches L2 et L1. Les données compressées impliquent un pipeline d’extraction plus long : chaque cache L1 doit désormais intégrer du matériel de décodage qui répète le même calcul chaque fois que les mêmes données sont extraites. En revanche, en conservant les données compressées plus longtemps, le GPU limite l’empreinte en cache et la bande passante intermédiaire. Selon le même principe, les textures sRGB sont conservées dans l’espace gamma dans le cache et ont donc la même empreinte que les textures linéaires. Pour comprendre l’effet de cette stratégie sur l’efficacité du cache, prenons une texture sRGB BC1, sans doute le type de texture le plus courant dans les jeux. BC1 est un format à 4 bits par texel ; sur XBOX One, cette texture occupe 4 bits par texel dans le TCP. Sur XBOX 360, la même texture est décompressée et corrigée en gamma avant d’atteindre le cache et occupe donc 8 octets par texel, soit 16 fois l’empreinte sur XBOX One. C’est pourquoi le TCP de la XBOX One se comporte comme un cache bien plus grand que dans les architectures précédentes. De même que les CU peuvent masquer la latence d’extraction en passant à d’autres waves, les caches de textures L1 de la XBOX One peuvent masquer la latence du cache L2 en continuant à traiter les instructions d’extraction après un échec de cache (miss). En d’autres termes, lorsqu’un échec de cache est suivi d’un ou plusieurs succès (hits), ces derniers peuvent être servis pendant le blocage dû à l’échec.Opérations d’extraction
La XBOX One prend en charge deux types d’opérations d’extraction : les extractions d’images et les extractions de mémoires tampons. Les extractions d’images correspondent à la méthode Sample du langage HLSL (high-level shader language) et nécessitent à la fois un registre de texture et un registre d’échantillonneur. Des fonctionnalités telles que le filtrage, le bouclage (wrapping), le mipmapping, la correction gamma et la compression par blocs nécessitent des extractions d’images. Les extractions de mémoires tampons correspondent à la méthode Load en HLSL et nécessitent uniquement un registre de texture, sans registre d’échantillonneur. Voici des exemples d’extractions de mémoires tampons :- Les extractions de vertex
- Les opérations gather4 de style Direct3D 10 (qui extraient un seul canal non filtré de 4 texels, plutôt que plusieurs canaux filtrés d’un seul texel)
- Les extractions depuis des formats qui ne sont pas filtrables nativement, comme les formats entiers
Unité de calcul (CU)
Chacune des 12 CU de la XBOX One possède son propre cache TCP (L1), son LDS, son séquenceur et quatre unités SIMD. La figure 3 montre la structure interne de l’une des CU. Dans le schéma, O représente un seul thread du shader en cours d’exécution. Figure 3. Vue éclatée d’une unité de calcul.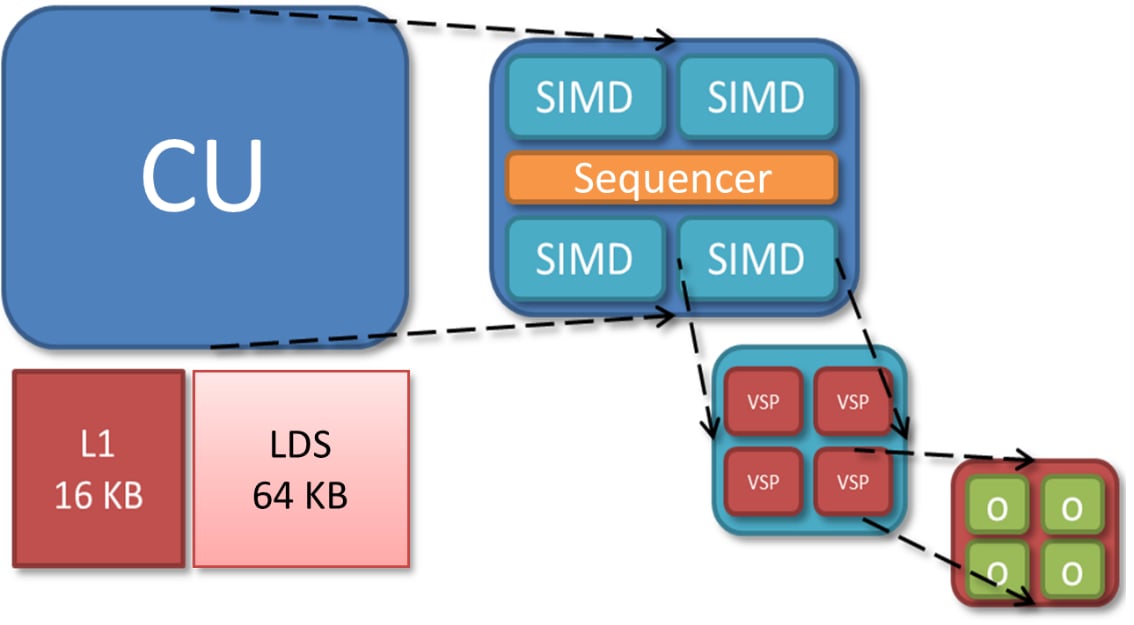
SIMD (single instruction multiple data)
Chacun des quatre SIMD de l’unité de calcul est un processeur de waves, au sens où il opère sur des waves de threads. Un SIMD exécute une instruction vectorielle sur 64 threads simultanément, de façon synchronisée. Par thread, en revanche, les SIMD sont des processeurs scalaires, au sens où ils utilisent des opérandes float plutôt que float4. Comme le jeu d’instructions est scalaire en ce sens, les shaders ne gaspillent plus de puissance de traitement lorsqu’ils opèrent sur moins de quatre composantes à la fois. L’analyse des shaders XBOX 360 suggère que sur les cinq voies disponibles (une opération float4 émise conjointement avec une opération float), seules trois sont utilisées en moyenne. Le jeu d’instructions SIMD est étendu et prend en charge les types de données entiers et à virgule flottante 32 bits et 64 bits. Les opérations sur des types de données plus larges occupent plusieurs pipes du processeur et s’exécutent donc à un débit plus lent ; par exemple, les additions 64 bits s’exécutent à un huitième du débit et les multiplications 64 bits à 1/16 du débit. Les opérations transcendantes, telles que la racine carrée, l’inverse, l’exponentielle, le logarithme, le sinus et le cosinus, ne sont pas pipelinées et s’exécutent au quart du débit. Ces opérations doivent être utilisées avec parcimonie sur XBOX One, car elles sont relativement plus coûteuses par rapport aux opérations arithmétiques que sur XBOX 360.Séquenceur (SQ)
Le séquenceur de la CU est chargé de charger le code des shaders depuis la mémoire et de contrôler l’exécution des quatre SIMD. En plus de gérer les SIMD, le séquenceur exécute lui-même certains types d’instructions. Ces instructions proviennent d’un jeu d’instructions scalaires distinct ; elles effectuent une opération par wave plutôt qu’une opération par thread. Par exemple, une instruction scalaire peut servir à additionner deux constantes de shader. Dans le microcode, les noms des instructions scalaires commencent par s_, tandis que ceux des instructions vectorielles commencent par v_. Le séquenceur suit les dépendances au sein d’une wave et détermine quand l’instruction suivante peut être exécutée en toute sécurité. En outre, le séquenceur gère la logique des branchements dynamiques et les boucles. À chaque cycle d’horloge, le séquenceur considère l’un des quatre SIMD, en les parcourant à tour de rôle (round-robin). La plupart des instructions ont un débit de quatre cycles ; chaque SIMD n’a donc besoin d’attention qu’une fois tous les quatre cycles. Un SIMD peut avoir jusqu’à 10 waves en cours à tout moment. Le séquenceur sélectionne une ou plusieurs de ces 10 waves candidates pour exécuter une instruction. Le séquenceur peut émettre simultanément plusieurs instructions de types différents (par exemple une opération vectorielle, une opération scalaire, une opération de mémoire globale, une opération de mémoire locale et une opération de branchement), mais chaque opération doit porter sur une wave différente.Registres à usage général : VGPR et SGPR
Chaque SIMD contient 256 registres vectoriels à usage général (VGPR) et 512 registres scalaires à usage général (SGPR). Les deux types de GPR stockent des données 32 bits : un SGPR contient une seule valeur 32 bits partagée entre les threads, tandis qu’un VGPR représente un tableau de valeurs 32 bits, une par thread au sein d’une wave. Chaque thread ne voit que sa propre entrée dans un VGPR. Les GPR enregistrent les résultats intermédiaires entre les instructions du shader. À chaque wave nouvellement créée, le GPU attribue une plage de VGPR et une plage de SGPR, autant que le shader en a besoin, dans la limite de 256 VGPR et 104 SGPR. Certains GPR sont consommés implicitement par le système, par exemple pour contenir des constantes littérales, des entrées d’index, des coordonnées barycentriques ou des métadonnées de débogage. Le nombre de GPR disponibles peut être un facteur limitant de la capacité du SIMD à masquer la latence en passant à d’autres waves. Si tous les GPR d’un SIMD sont déjà attribués, aucune nouvelle wave ne peut commencer à s’exécuter. Et si toutes les waves actives sont bloquées, le SIMD reste inactif jusqu’à la fin de l’un des blocages. Comme la plupart des GPU modernes, le GPU de la XBOX One utilise une architecture de shaders unifiée (USA), ce qui signifie que les mêmes CU sont utilisées indifféremment pour toutes les étapes du pipeline de shaders : vertex, hull, domain, geometry, pixel et compute. Sur XBOX One, l’utilisation des GPR est également unifiée ; il n’y a plus d’allocation fixe de GPR au vertex shading ou au pixel shading comme sur XBOX 360.Constantes
Le GPU de la XBOX One ne possède pas de registres dédiés pour contenir les constantes de shader. Lorsqu’un shader référence une mémoire tampon de constantes, le compilateur décide de la manière dont ces accès seront implémentés. Le compilateur peut spécifier que les constantes soient préchargées dans des GPR. Le compilateur peut extraire les constantes depuis la mémoire à l’aide d’instructions scalaires. Le compilateur peut mettre les constantes en cache dans le LDS. Une constante de shader peut être globale (constante pendant tout l’appel de dessin) ou indexée (immuable, mais variant selon le thread). Les constantes indexées doivent être extraites à l’aide d’instructions vectorielles et sont donc plus coûteuses que les constantes globales. Ce coût est quelque peu analogue à la pénalité de « constant waterfalling » de la XBOX 360, bien que le mécanisme soit différent.Branchements
Les instructions de branchement sont exécutées par le séquenceur et ont le même coût idéal que les instructions de calcul. Comme sur les CPU, toutefois, les branchements peuvent entraîner des blocages du pipeline en attendant le résultat de l’instruction qui détermine la direction du branchement. Les branchements non pris introduisent ensuite des bulles dans le pipeline. Les branchements pris nécessitent une lecture dans le cache d’instructions, ce qui entraîne un délai supplémentaire. Tous ces coûts potentiels sont sans objet tant qu’il y a suffisamment de waves actives pour masquer les blocages. Les branchements sont intrinsèquement problématiques sur une architecture SIMD où de nombreux threads s’exécutent de façon synchronisée et où l’accord sur la direction du branchement n’est pas garanti. Le compilateur HLSL peut implémenter la logique de branchement de plusieurs façons :- Prédication Les deux chemins sont exécutés ; les calculs qui ne doivent pas avoir lieu pour un thread particulier sont masqués.
- Saut prédiqué Si tous les threads tranchent le branchement de la même façon, seul le chemin correct est exécuté ; sinon, les deux chemins sont exécutés.
- Saut d’instructions (Skip) Les deux chemins sont suivis, mais les instructions qui ne sont exécutées par aucun thread sont sautées à un débit plus rapide.
Interpolation
Le GPU de la XBOX One ne possède pas d’unités d’interpolation à fonction fixe. À la place, un composant dédié du GPU achemine les données de sortie du vertex shader vers le LDS de la ou des CU qui exécutent finalement le pixel shader. Ce mécanisme d’acheminement permet que les pixels soient ombrés par une CU différente de celle qui a ombré les vertex associés. Avant le démarrage du pixel shader, le GPU remplit automatiquement deux registres avec des métadonnées d’interpolation :- Un SGPR, un champ de bits qui contient :
- Un pointeur vers la zone du LDS où la sortie du vertex shader a été stockée.
- Une description indiquant de quels vertex proviennent les pixels de la wave actuelle.
- Deux VGPR qui contiennent les coordonnées barycentriques de chaque pixel (la troisième coordonnée barycentrique est implicite).
Sortie
La sortie du pixel shading passe par le DB et le CB avant d’être écrite dans les cibles de rendu de profondeur/stencil et de couleur. Logiquement, ces mémoires tampons représentent des tableaux en espace écran, avec une valeur par échantillon. Physiquement, leur implémentation est beaucoup plus complexe et implique un certain nombre d’optimisations matérielles. La profondeur et la couleur sont toutes deux stockées dans des formats compressés. L’objectif de la compression est d’économiser de la bande passante, et non de la mémoire ; en fait, les cibles de rendu compressées nécessitent légèrement plus de mémoire que leurs équivalents non compressés. Les cibles de rendu compressées permettent certains types de rendu accéléré. Une opération d’effacement, par exemple, est beaucoup plus rapide en présence de compression, car le GPU n’a pas besoin d’écrire explicitement la valeur d’effacement dans chaque échantillon. De même, pour des triangles relativement grands, le rendu avec anticrénelage multi-échantillon (MSAA) vers une mémoire tampon de couleur compressée peut s’exécuter presque au même débit qu’un rendu sans MSAA. Pour des raisons de performances, il est important de conserver autant que possible les données de profondeur et de couleur compressées. Voici quelques exemples d’opérations susceptibles de détruire la compression :- Le rendu de géométrie fortement tessellée
- L’utilisation intensive de l’alpha-to-mask (parfois appelé alpha-to-coverage)
- L’écriture de la profondeur ou du stencil depuis un pixel shader
- L’exécution du pixel shader par échantillon (à l’aide de la sémantique SV_SampleIndex)
- L’utilisation sur place de la mémoire tampon de profondeur ou de couleur comme texture, puis la reprise de son utilisation comme cible de rendu
Remplissage
Le GPU contient quatre instances physiques du CB et du DB. Chacune peut traiter un quad par cycle d’horloge, pour un débit total de 16 pixels par cycle d’horloge, soit 12,8 Gpixels/s. Le CB est optimisé pour les types à 64 bits par pixel ; il n’y a donc aucun avantage de performances local à utiliser des formats de couleur plus petits, bien qu’il puisse encore y avoir une économie de bande passante substantielle. Comme la fusion alpha nécessite à la fois une lecture et une écriture, elle consomme potentiellement deux fois plus de bande passante que le rendu opaque et, pour certains formats de couleur, elle s’exécute aussi à demi-débit en termes de calcul. De même, comme le test de profondeur implique une lecture dans la mémoire tampon de profondeur et que la mise à jour de la profondeur implique une écriture dans celle-ci, l’activation de l’un ou l’autre de ces états peut réduire les performances globales.Profondeur et stencil
Le bloc de profondeur intervient vers la fin du pipeline de rendu logique, après le pixel shader. Cependant, dans l’implémentation du GPU, le DB et le CB peuvent interagir avec le rendu avant et après le pixel shading, et le pipeline prend en charge plusieurs types de chemins de décision anticipée optimisés. La XBOX One implémente à la fois le Z hiérarchique (Hi-Z) et le Z anticipé (early Z), et de même pour le stencil. Grâce à une logique soignée dans le pilote et le matériel, certaines opérations de profondeur et de couleur peuvent être déplacées avant le pixel shader et, dans certains cas, une partie ou la totalité du coût du shading et de la rastérisation peut être évitée. La profondeur et le stencil sont stockés et gérés séparément par le matériel, même si syntaxiquement ils sont traités comme une unité. Une lecture de profondeur/stencil correspond en réalité à deux opérations distinctes, de même qu’une écriture de profondeur/stencil. Le pilote implémente le format mixte DXGI_FORMAT_D24_UNORM_S8_UINT à l’aide de deux allocations distinctes : une surface de profondeur 32 bits (avec 8 bits de remplissage par échantillon) et une surface de stencil 8 bits.Anticrénelage (AA)
Le GPU de la XBOX One prend en charge les niveaux MSAA 2×, 4× et 8×. Il implémente également un type modifié de MSAA appelé AA compressé. L’AA compressé dissocie deux notions d’échantillon :- Échantillon de couverture L’une des différentes positions en espace écran générées par la rastérisation d’un pixel.
- Échantillon de surface L’une des différentes entrées représentant un même pixel dans une surface de couleur ou de profondeur/stencil.
Composants à fonction fixe
Le GPU contient quatre composants à fonction fixe appelés moteurs DMA, qui effectuent divers types d’accès direct à la mémoire (DMA) rapides :- Moteur DMA 1 Copie simple, swizzle/unswizzle (usage exclusif du titre)
- Moteur DMA 2 Copie simple, swizzle/unswizzle (usage exclusif du titre)
- Moteur DMA 3 Copie simple, swizzle/unswizzle, encodage/décodage sans perte Lempel-Ziv (LZ) (usage exclusif du titre)
- Moteur DMA 4 Copie simple, swizzle/unswizzle, décodage JPEG (usage partagé entre le titre et le système)
Affichage
Le GPU de la XBOX One prend en charge la norme HDMI 1.4a et peut émettre un signal de sortie final allant jusqu’à de la 3D stéréoscopique 1080p à 60 Hz. Comme sur XBOX 360, le GPU utilise un scaler à fonction fixe de haute qualité pour rééchantillonner la mémoire tampon de premier plan (front buffer) du titre à la résolution de sortie spécifiée par l’utilisateur. Le GPU accepte trois plans d’affichage indépendants, éventuellement de résolutions différentes, et les fusionne en une sortie finale à l’aide du scaler et des canaux alpha sources. Un plan d’affichage est contrôlé par le système, et deux sont à la disposition du titre. Un scénario courant consistera à utiliser ces deux plans d’affichage pour rendre le monde du jeu et l’interface utilisateur à des résolutions différentes.Débogage et profilage
Le GPU de la XBOX One contient un certain nombre de fonctionnalités inédites pour le débogage et l’analyse des performances à un niveau de détail fin. Un travail logiciel important sera nécessaire pour exposer ces fonctionnalités. Attendez-vous à en savoir plus sur ce travail à mesure que la technologie gagnera en maturité.Résumé
Un processeur est plus que la somme de ses parties. Comprendre pleinement les implications de l’architecture du GPU de la XBOX One demandera du temps, de l’expérimentation et de l’analyse. Quelques recommandations peuvent néanmoins être formulées :- Réfléchissez à des façons d’utiliser le GPU pour des tâches de calcul à faible latence et hautement parallèles, pas nécessairement liées au rendu.
- Maintenez un pipeline entièrement correct en gamma à toutes les étapes, maintenant que les conversions sRGB n’ont qu’un coût faible, voire nul.
- La taille de l’ESRAM ne représente plus une limite stricte, et la bande passante n’est plus une équation simple. Pesez soigneusement les coûts et les avantages des différents formats HDR, des cibles de rendu multiples et du MSAA.
- Efforcez-vous d’éviter les opérations transcendantes dans les shaders.
- Préférez la méthode HLSL Load à la méthode HLSL Sample lorsque les fonctionnalités de l’échantillonneur ne sont pas nécessaires.
- Organisez le rendu de façon à préserver la compression de la profondeur et de la couleur.
- Désactivez les états de profondeur, de stencil et d’alpha inutiles pendant un rendu limité par le remplissage. N’allouez pas de stencil si vous ne l’utilisez pas.
- Réévaluez l’utilisation des techniques d’élimination telles que les pré-passes Z, maintenant que le GPU prend en charge le test de profondeur anticipé.