
Glossaire
Les abréviations et acronymes suivants sont utilisés dans cette rubrique.Instructions de tampon et instructions d’image
Les instructions de tampon sont générées pour les opérations de lecture, d’écriture ou atomiques sur des tampons de sommets, des tampons bruts ou des tampons structurés. Aucun filtrage de données ni aucun échantillonneur n’est pris en charge. Les données transitent par les caches L1 et L2, tant pour les lectures que pour les écritures. Il existe deux types d’instructions de tampon : tbuffer_* Instruction de tampon typé. Le format des données est spécifié dans l’instruction et les opérations atomiques ne sont pas prises en charge. buffer_* Instruction de tampon non typé. Le format des données est spécifié dans le descripteur de l’objet tampon. Une conversion de format facultative peut être spécifiée dans les instructions. Les opérations atomiques sont prises en charge. Les instructions d’image sont générées pour les opérations de lecture, d’écriture ou atomiques sur des textures et des surfaces typées. Le filtrage est pris en charge pour la lecture des données. Les données transitent par les caches L1 et L2, tant pour les lectures que pour les écritures. Toutes les instructions d’image disposent d’un champ de masque de données qui spécifie les canaux qu’elles reçoivent. Il existe deux types d’instructions d’image : sample_* Lire et filtrer des données à partir d’une texture. Ces opérations nécessitent un échantillonneur. image_* Lire, écrire ou effectuer une opération atomique sur une texture. Aucun filtrage n’est pris en charge. Il existe d’autres types d’instructions de mémoire vectorielle, mais ils sont relativement rares et ne sont pas abordés dans cette rubrique.Aide-mémoire : tableau récapitulatif des performances
Il s’agit de valeurs de performances maximales.
Ces valeurs sont rarement atteignables en pratique, mais il est utile de les garder en tête pour une analyse rapide d’un shader. Voici quelques règles empiriques rapides qui peuvent être déduites du tableau des performances.
- Tout fetch de texture coûte au moins 16 cycles. Rentabilisez-le en lisant autant de données que possible. Gather4 est un outil précieux lorsque vous travaillez avec des textures à canal unique.
- Il est parfois moins coûteux de lire une valeur U32 depuis un tampon à l’aide d’une lecture à canal unique et de la décompresser sur l’ALU que de lire 2 à 4 valeurs d’octets distinctes à l’aide d’une lecture multicanal.
Masquage de la latence
En raison de la latence élevée des instructions de mémoire vectorielle, le GPU utilise deux mécanismes de masquage de la latence. Les instructions de mémoire vectorielle sont conçues pour ne pas bloquer l’exécution du wavefront au moment où elles sont émises. Chaque instruction de mémoire vectorielle émise incrémente un compteur VM, et chaque instruction de mémoire vectorielle retournée décrémente ce compteur. Le compilateur de shaders implémente une synchronisation manuelle en insérant des instructions s_waitcnt avant le point où les résultats sont nécessaires ; sinon, les résultats sont indéfinis. Les instructions de mémoire vectorielle retournent toujours dans l’ordre. Le tableau suivant en présente un exemple.
Si une vague est en mode d’attente, elle ne peut pas poursuivre son exécution tant que le compteur VM est supérieur à la valeur spécifiée dans le paramètre de s_waitcnt. Dans ce cas, la latence est masquée par l’exécution d’autres vagues présentes sur le même SIMD. Plus il y a de vagues disponibles, meilleur est le masquage de la latence. Le nombre de vagues par SIMD est appelé occupation (occupancy), et les développeurs doivent s’efforcer de le maximiser. L’occupation mesurée est visible dans les sections ALU et Performance de la rubrique Dr. PIX, ainsi qu’à l’aide des compteurs de colonnes.
Le même mécanisme s’applique aux instructions LDS, SMEM et EXP/GDS. Toutefois, elles utilisent des compteurs différents.
Vue d’ensemble matérielle d’une unité de texture
Voici une vue d’ensemble schématique de l’unité de texture au sein d’une unité de calcul. Le cache L2 et la mémoire ne sont pas représentés. Figure 1. Vue d’ensemble de haut niveau du TA/TCP/TD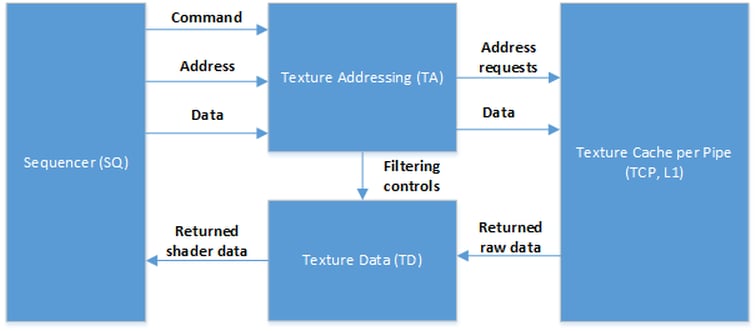
Bien qu’il puisse être utile d’employer le terme « unité de texture », cette unité n’existe pas, car le traitement des instructions mémoire est réparti entre au moins trois blocs différents. De plus, ces blocs sont utilisés dans le GPU XBOX One pour lire et écrire les données des tampons de sommets et des UAV. Par conséquent, parler d’« unité de texture » peut prêter à confusion.
Le cycle de vie d’une instruction de mémoire vectorielle
Le coût de chaque instruction VMEM comprend le temps d’émission (SQ->TA), le temps d’émission de la requête mémoire (TA->TCP), le temps de lecture mémoire (TCP->TD) et le temps de retour des données (TD->SQ). Il est possible d’être limité par l’une de ces quatre étapes, bien que les jeux soient le plus souvent limités par l’accès mémoire.Étape 1 : Émission de l’instruction
Chacune des 12 CU prend en charge jusqu’à 40 vagues. Elles sont réparties en quatre groupes de 10 vagues maximum (un groupe par SIMD) et, à chaque cycle, un SIMD est choisi pour le traitement. Les quatre cycles nécessaires à une CU pour parcourir les quatre SIMD constituent une phase ou un cycle d’attente. À chaque cycle d’horloge, les 10 vagues sont en concurrence pour émettre une instruction de chaque type : VALU, SALU, VMEM, LDS, EXP/GDS et Branch. Pour plus d’informations, consultez le livre blanc Xbox One GPU Shader Cores, disponible en téléchargement sur le site XBOX Game Developer (XGD). Les instructions VMEM utilisent un bus TA unique, partagé par les quatre SIMD. Même si chaque SIMD peut choisir d’émettre une instruction VMEM à chaque cycle d’horloge, le rythme le plus rapide possible est d’une instruction tous les quatre cycles. Pour émettre une instruction VMEM, les opérandes situés dans les SGPR et les VGPR doivent être transférés au TA. Tant que tous les opérandes de l’instruction n’ont pas été transférés au TA, le wavefront émetteur ne peut pas passer à l’instruction suivante, et aucune autre vague de la CU ne peut utiliser le bus TA. L’émission d’instruction VMEM la plus courte prend quatre cycles, d’où la limite du taux d’émission. Les instructions VMEM, comme certains autres types d’instructions, sérialisent essentiellement les wavefronts sur l’ensemble des quatre SIMD. Selon la quantité de données à envoyer, l’émission d’une instruction VMEM prend un nombre variable de cycles d’horloge. C’est logique, car il peut y avoir jusqu’à 64 coordonnées UV, décalages, gradients et autres données différents par instruction. L’émission ne peut donc pas être instantanée. Les opérandes de l’instruction VMEM sont répartis en trois flux et envoyés sur trois bus parallèles : Command, Address et Data. La vitesse d’émission de l’instruction est déterminée par le temps le plus long parmi ces trois bus. Le tableau suivant fournit quelques exemples du temps nécessaire pour émettre une instruction VMEM pour un wavefront, en fonction du nombre et de la taille des opérandes.Dans l’onglet ALU de Dr.PIX, vous pouvez voir comment ces bus sont utilisés à l’exécution en consultant les statistiques « Time required to issue work on TA ADDR bus » et « Stalled due to full command FIFO »
Sur les charges de travail importantes, il n’est possible d’être limité par l’émission des instructions VMEM elle-même que si le temps d’émission dépasse 16 cycles d’horloge. Sinon, c’est généralement le TA qui constitue le goulot d’étranglement. Par exemple, SampleGrad() avec une texture 2D coûtera 24 cycles à émettre et sera environ deux fois plus coûteux qu’un Sample() classique (12 cycles d’horloge) si toutes les lectures atteignent le cache L1.
Dans le cas de SampleGrad(), nous pouvons voir dans Dr.PIX les signes révélateurs d’une limitation par l’émission.
Étape 2 : Calcul des adresses et demande des données
Le TA poursuit l’exécution de l’instruction VMEM en demandant les données au TCP et en informant le TD des données de retour à attendre et de la manière de les filtrer. Le TA peut demander jusqu’à 128 bits de données à partir de quatre emplacements par cycle. La vitesse de lecture maximale du TCP correspond à cette valeur. Cela permet un débit bilinéaire maximal de 2×2 pixels filtrés par cycle pour 32 bpp ou moins, ou un débit non filtré de 4 pixels par cycle jusqu’à 128 bpp. Figure 2. Présentation du processus de fetch de texture à filtrage bilinéaire. Ce processus est répété pour tous les quads du wavefront.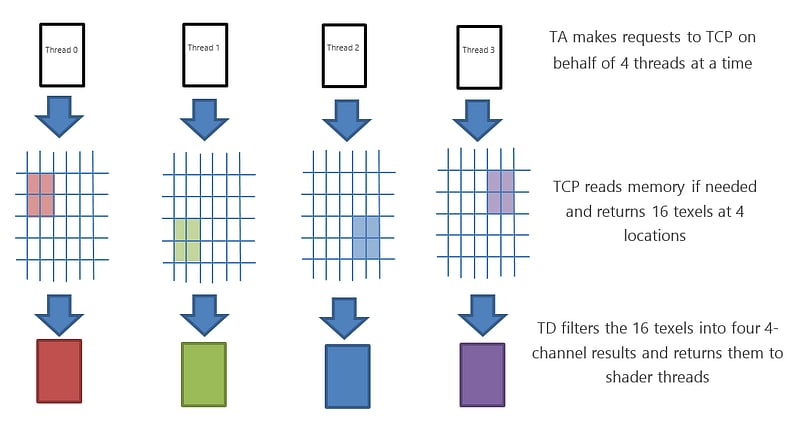
Voici quelques coûts supplémentaires à payer pour les fonctionnalités suivantes (par quad 2×2).
- La couleur de bordure ajoute un ou deux cycles.
- Les gradients personnalisés ajoutent jusqu’à trois cycles.
- Les coins de cubemap peuvent ajouter jusqu’à cinq cycles.
- Les cas d’enroulement (wrap) sur des dimensions non puissances de 2 peuvent ajouter jusqu’à trois cycles.
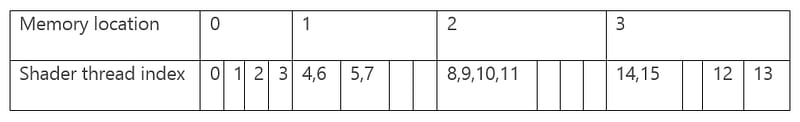
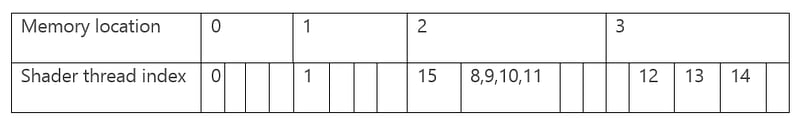
Étape 3 : Le TCP charge les données et les transmet au TD
Le TCP est le cache « L1 ». Le TCP est propre à chaque CU ; il a une taille de 16 Ko et comporte quatre RAM entrelacées, chacune entièrement associative avec 64 étiquettes et une stratégie LRU. Le TCP stocke des octets de mémoire bruts. Il gère la lecture et l’écriture des données d’image et de tampon, la combinaison des écritures pour les requêtes d’écriture et atomiques, la combinaison des lectures pour les requêtes de lecture, le tiling mémoire et la décompression des formats par blocs à la lecture, ainsi que les textures partiellement résidentes. Le rôle du TCP est de masquer la latence du TCC, et non d’y stocker des données pendant longtemps. Au débit maximal, le TA peut demander quatre adresses uniques par cycle, et le TCP peut retourner au TD jusqu’à 128 bits de données de chaque adresse par cycle. Il est garanti que le TCP peut envoyer au TD n’importe quel texel d’image 2×2 en 1 cycle. Les performances réelles dépendent de la taille de la requête et de la dispersion en mémoire. Pour chaque échec d’accès au cache L1, une requête est transmise au cache L2, ce qui affecte considérablement les performances. Un échec d’accès au cache L1 peut coûter plus de 50 cycles d’horloge, et un échec d’accès au cache L2 coûtera plus de 200 cycles d’horloge vers la DRAM et plus de 75 cycles vers l’ESRAM.Ces valeurs sont mesurées, mais optimistes. Pour voir les latences réelles, utilisez l’onglet ALU de Dr. PIX ou les différents compteurs de colonnes disponibles.
Concernant les lectures et écritures de tampon ci-dessus : les chargements et stockages à 4 canaux ont le même débit que les chargements et stockages fusionnés à 1 canal. En effet, 1 DWORD par thread de shader en 4 cycles représente la même quantité de données par cycle que 4 DWORD par thread de shader en 16 cycles.
Étape 4 : Le TD retourne les données au SP
Une fois que le TCP dispose des données, celles-ci sont transmises au bloc TD afin d’être retournées au shader. Le TD effectue le filtrage et la conversion de format, y compris la suppression du gamma (de-gamma). Le filtrage est ignoré pour les formats entiers (par exemple, R32_UINT) et les fetchs de tampon. Dans la plupart des cas, le TD peut filtrer quatre pixels à quatre canaux par cycle et retourner jusqu’à 16 DWORD par cycle au shader. En général, l’un ou l’autre de ces aspects constitue un goulot d’étranglement dans ce bloc, et il est possible de déterminer lequel en fonction du type de fetch ou du format. Plutôt que de présenter un grand tableau de formats et de vitesses, un programmeur graphique expérimenté n’a besoin de retenir que les points suivants :- Le TD dispose de quatre filtres à virgule fixe de 12 bits, qu’il peut chaîner pour prendre en charge la mantisse de 23 bits du FP32 ou la valeur 16 bits d’un U16.
- Le TD dispose de trois canaux de 9 bits qui traitent l’exposant à virgule flottante.
- Le filtrage trilinéaire/anisotrope réduit le débit, car les échantillons doivent être mélangés.
- Les formats à virgule fixe de 8, 10 ou 11 bits par canal passent à plein débit, en utilisant une voie de filtre de 12 bits par canal.
- Les formats à virgule fixe de 16 bits doivent utiliser deux voies de 12 bits par canal ; ainsi, s’il y a quatre canaux de 16 bits, le filtrage s’effectue à mi-débit. S’il y a deux canaux de 16 bits, il s’effectue à plein débit.
- Le format FP32 à canal unique est à pleine vitesse. FP32x2 est à mi-vitesse et FP32x4 à quart de vitesse. Ce ralentissement s’explique par le fait qu’un canal FP32 occupe deux voies de 12 bits.
- Le FP16 à canal unique est à pleine vitesse, tout comme FP16x2, mais FP16x4 est à mi-vitesse, car seuls trois canaux à virgule flottante peuvent être filtrés simultanément.
- R11G11B10_FLOAT est à pleine vitesse, car la mantisse est inférieure à 12 bits et trois canaux à virgule flottante doivent être filtrés.
Si vous utilisez .x ou .xyz en HLSL sur une texture FP16x4, le débit reste de moitié, car le GPU filtre tous les canaux de la texture source avant de déterminer quels canaux retourner au shader.
Opérations atomiques
Les opérations atomiques sont des opérations mémoire qui effectuent une lecture-modification-écriture sur la destination en une seule transaction ininterrompue. Le GPU XBOX One dispose de trois types distincts d’opérations atomiques : les opérations atomiques LDS, les opérations atomiques GDS et les opérations atomiques mémoire. Seules les opérations atomiques mémoire sont abordées dans cette rubrique. Un shader peut demander une valeur de retour à une instruction atomique ; on parle alors d’opérations atomiques avec retour, ou simplement d’opérations atomiques à retour. Les instructions qui ne demandent pas de valeur de retour sont appelées opérations atomiques sans retour. La prise en charge matérielle des opérations atomiques est un sur-ensemble des opérations atomiques HLSL. Le type de données des opérations atomiques est constitué d’entiers 32 et 64 bits, signés ou non signés. Les opérations atomiques CMPSWAP, MIN et MAX sont également prises en charge sur les valeurs à virgule flottante 32 et 64 bits. Les opérations atomiques 64 bits ne sont prises en charge qu’avec les instructions de tampon ; sinon, la prise en charge des opérations atomiques sur image et sur tampon est symétrique. Chaque instruction atomique peut être avec retour, signalée par l’indicateur GLC=1 dans l’assembleur de shader, ou sans retour. HLSL DX11 n’expose qu’un sous-ensemble des opérations atomiques disponibles dans le matériel ; il manque notamment la prise en charge des opérations atomiques sur entiers 64 bits pour les tampons. L’absence de prise en charge des opérations atomiques MIN et MAX pour les valeurs à virgule flottante dans HLSL peut être contournée pour les valeurs à virgule flottante positives en utilisant les opérations atomiques MIN/MAX classiques sur entiers signés avec des valeurs asint(fp32). En effet, les valeurs à virgule flottante IEE754 de même signe sont ordonnées. L’opération atomique CMPSWAP devrait également fonctionner sur des valeurs asint(fp32). Le TCP (cache L1) a connaissance des opérations atomiques, mais n’effectue pas lui-même les opérations atomiques réelles. Il les combine d’abord en écriture, puis les transmet au TCC (cache L2) pour exécution. Le TCC (cache L2) est propre à chaque GPU ; il s’agit d’un cache à réécriture (writeback) de 512 Ko, associatif à 16 voies, avec 12 blocs de 8 Ko par banque et quatre banques. Voici les performances maximales du TCC :- 4 lectures par cycle
- 3 écritures par cycle
- 3 opérations atomiques sans retour par cycle
- 1 opération atomique avec retour par cycle
Annexe A : Vitesses de fetch de texture
Ces valeurs théoriques correspondent raisonnablement aux valeurs mesurées pour différents fetchs de texture.Annexe B : Vue d’ensemble d’un shader utilisant une instruction d’image
L’exemple suivant montre une instruction de mémoire vectorielle dans un binaire de shader :v[2:3] (les v[4:5] sont inutilisés mais requis ici), l’objet descripteur de texture dans s[0:3] et un objet descripteur d’échantillonneur dans s[4:11].