
管線化
若要實作正確且最有效率的同步處理,務必了解 XBOX Series X|S GPU 的硬體區塊,從它接收到起始動作的命令,到完成執行該動作為止。命令處理器 (CP) 是 GPU 中從記憶體接收命令 (簡單來說,就是我們推送到 D3D12CommandLists 的命令) 的區塊,命令以封包形式傳遞 (可在 PIX 命令反組譯檢視中檢視)。CP 是一個由許多部分組成的複雜區塊,但我們可以將其簡化為三個部分:- 命令處理器擷取器 (CPF),負責從記憶體擷取封包,並將其傳送至 CPG 或 CPC 進一步處理。
- 命令處理器圖形 (CPG),負責管理和處理圖形管道的命令。
- 計算命令處理器 (CPC),與 CPG 平行執行,負責管理和處理計算管道的命令 (由 Async Compute 使用)。
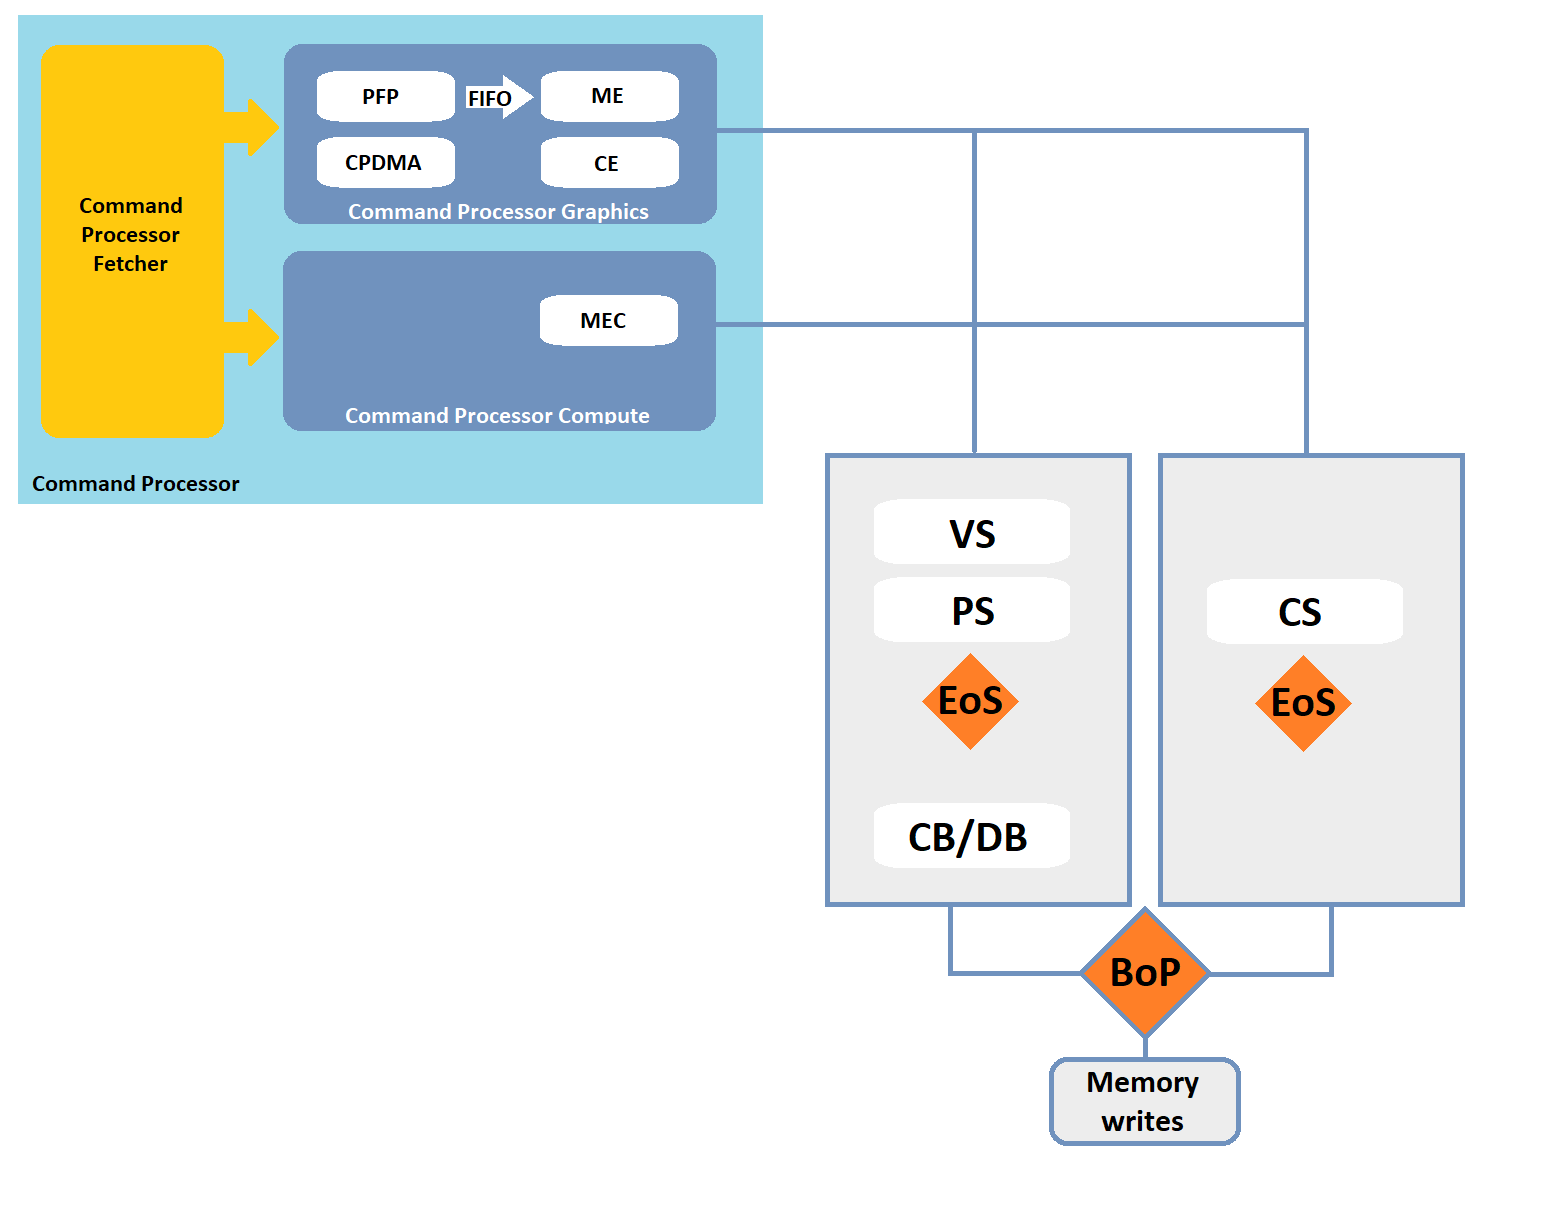
- PFP 負責擷取索引緩衝區資料、處理間接引數、述詞資訊,以及與 ME 同步。
- ME 可以觸發排清、起始繪製/分派,並具有 CPDMA 位置來起始複製。
- 常數引擎 (CE) 是 CPG 內部的一個區塊,具有用於儲存每個繪製命令所需常數的 RAM。它會將這些常數複製到 L2,然後在資料就緒時向 ME 發出訊號 (讓 ME 可以暫停繪製命令,直到常數就位)。ME 也可以在繪製完成時向 CE 發出訊號,讓 CE 可以重複使用其資源。
- CP 直接記憶體存取 (CPDMA) 負責執行複製 (從記憶體/暫存器複製或複製到記憶體/暫存器),並可由 PFP、ME 或 MEC 觸發。它可以從任何虛擬記憶體複製,或複製到任何虛擬記憶體。
- 著色器結束事件 (EoS) 會在分派/繪製的所有 wave 完成後執行,但不會等待算繪後端完成 (在固定管線的情況下)。
- 管道底部 (BoP) 是指所有著色器和算繪後端工作都已完成時,但不保證記憶體寫入已完成。
- 對於計算而言,EoS 和 BoP 是相同的,因為沒有算繪後端工作。
- 柵欄 (Fence)
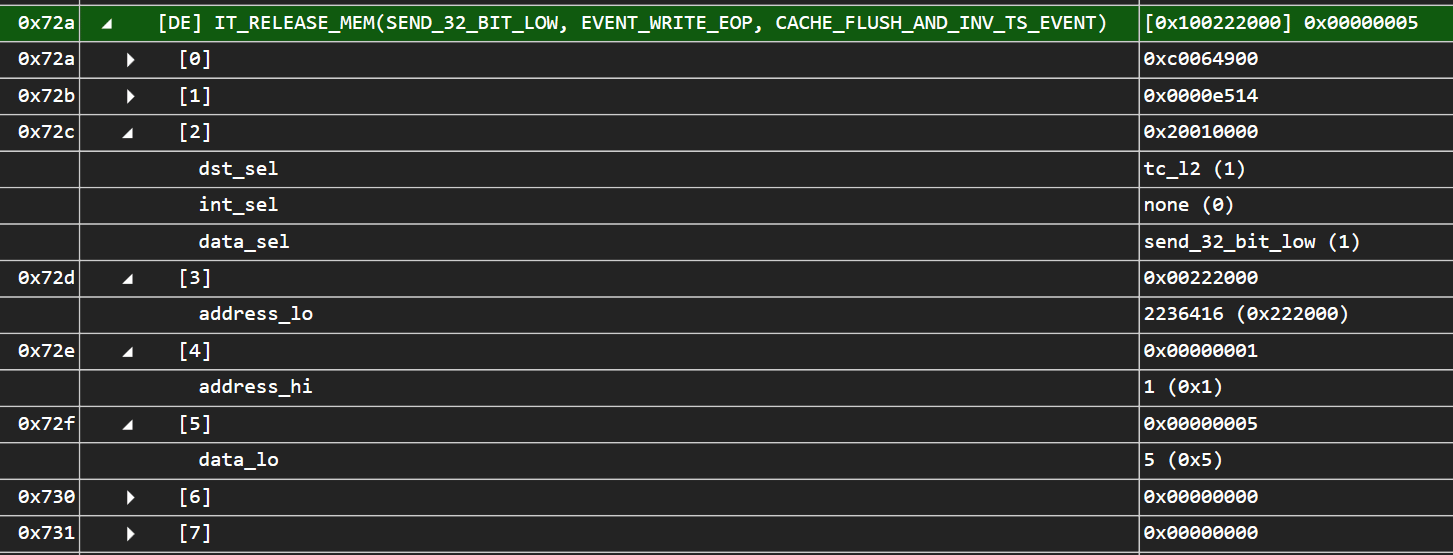
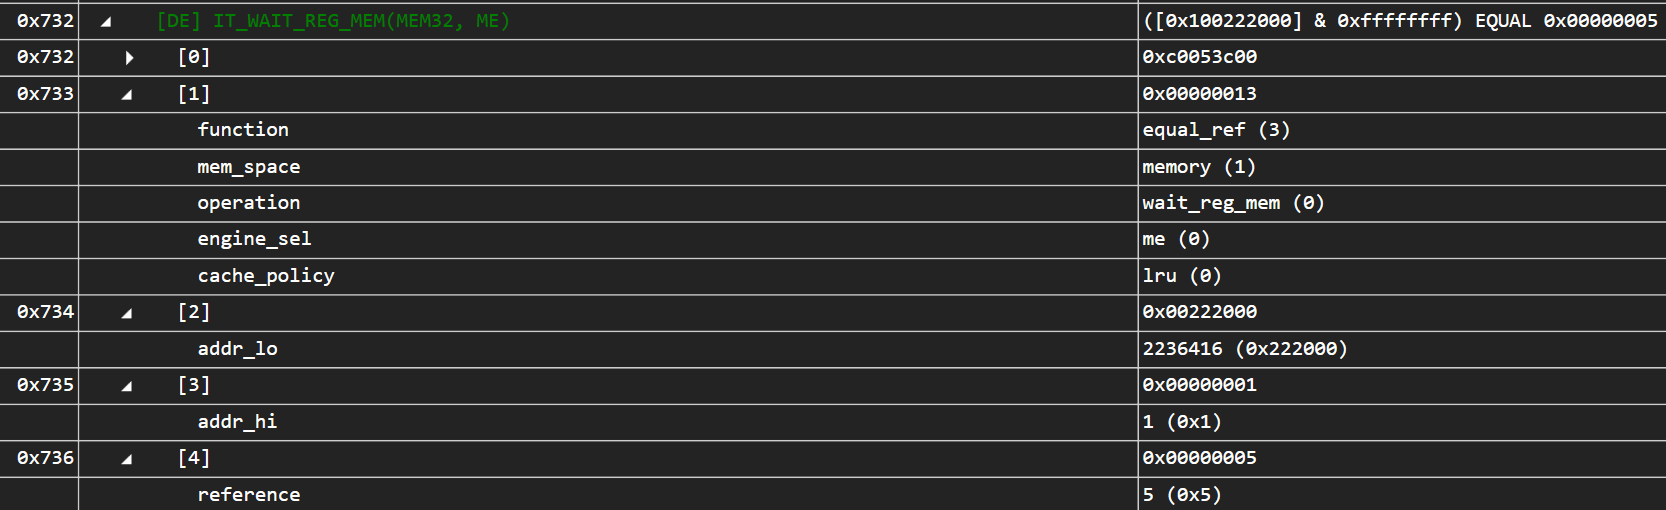
- 由 (至少) 兩個封包組成的同步處理基本類型。第一個封包會在記憶體位置寫入參考值。此封包是一個事件,可設定為以 EoS 事件或 BoP 事件執行。第二個封包是等待,會封鎖引擎 (PFP 或 ME),不允許後續封包通過,同時持續輪詢該記憶體位置,直到輪詢的值滿足比較函式為止。此時,被封鎖的引擎會解除封鎖,工作得以繼續。
- 部分排清
- 部分排清會讓 CP 等待,直到與頂點、像素或計算著色器 (視封包而定) 相關的所有工作都完成為止。ME 會封鎖所有後續封包,直到收到 SPI 的訊號為止。
- 對於柵欄,我們會建立一個在計算工作之後寫入記憶體的 EoS 柵欄 (因此第一個柵欄封包會位於分派之後)。並讓第二個柵欄封包在 ME 引擎上封鎖,直到記憶體中的值更新為止 (我們無法選擇性地封鎖 ME 下游的階段,因此在此情況下,要封鎖的引擎只能選擇 ME 或 PFP)。
- 這也可以透過 CS 部分排清來處理,它會在 ME 上封鎖,直到收到所有計算著色器工作已完成的訊號,才會解除封鎖引擎。部分排清只需要一個封包,而柵欄需要兩個 (因此就記憶體作業而言較便宜)。但柵欄在引擎被封鎖期間需要等待哪些工作方面提供了更大的彈性 (因為記憶體寫入可以發生在特定分派之後,而不是所有計算工作之後)。
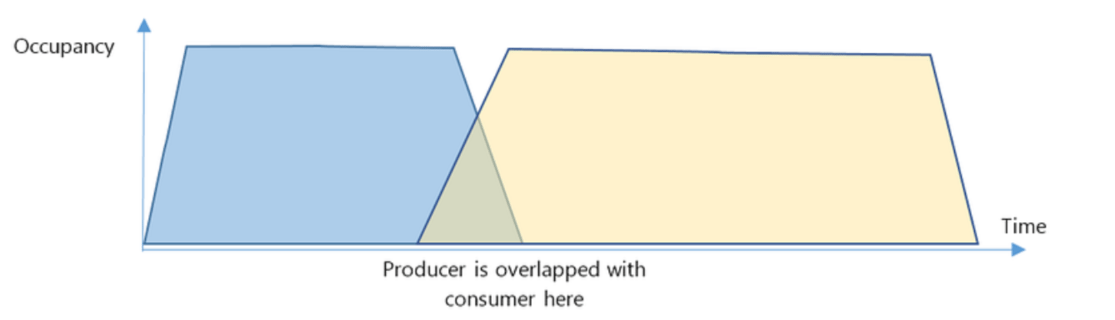
XBOX Series X|S 上可用的硬體層級同步處理機制:
了解我們使用柵欄或部分排清 (或 Barrier 等同步處理 API) 時驅動程式所產生的封包很有用,因為每當我們檢視同步處理事件時,這些封包都會顯示在 PIX 擷取中 (每個封包位元遮罩的更多詳細資料可在命令反組譯索引標籤中查看)。- ACQUIRE_MEM:驅動程式使用此封包來確保表面不再被使用 (使用中的繪製命令),且與其相關的所有快取都會在後續作業之前排清。驅動程式會將其用於需要同時排空 CB 和 DB (所有 CB/DB 工作完成),並使下列一或多個快取 ($K、$I、L0、L1、L2、LM、CB 快取、DB 快取) 失效,和/或對 L2 進行回寫的作業 (請點選此連結以查看快取定義)。其運作方式是先等待相關的記憶體位址不再被進行中的工作參照,然後再排清與其相關的快取。它可以在 PFP 或 ME 上封鎖 (此封包在管道頂端執行)。
- RELEASE_MEM:允許在管線上插入事件 (管道結束或著色器結束)。例如,可用來更新柵欄值,或執行記憶體作業 (快取失效/排清)。
- WAIT_REG_MEM:此封包用於等待暫存器或記憶體空間中的某個位置滿足比較函式。可用來評估柵欄。此封包可定義比較函式 (例如 equal ref 會檢查記憶體中的值是否與參考值相符),而參考值是我們要比較的值。它也定義哪個引擎要等待 (PFP、ME 或 CE)、定義要比較哪些位元的遮罩,以及輪詢間隔 (引擎檢查記憶體/暫存器空間的頻率,以時脈週期為單位)。
- EVENT_WRITE:允許將事件插入管線。VS、PS 和 CS 部分排清都屬於 EVENT_WRITE 類型。
- PFP_SYNC_ME:強制 PFP 與 ME 區塊同步。PFP 會將封包轉送至 ME,並暫停傳入的封包,直到被 ME 解除為止 (ME 已完成工作,且 ME 與 PFP 之間的 FIFO 佇列為空)。
- DMA_DATA:允許 PFP 或 ME 指示 CP DMA 從暫存器或記憶體複製,或複製到暫存器或記憶體 (在一個不可部分完成的封包中)。要求複製的引擎 (PFP 或 ME) 可以選擇性地等待結果。可指定複製為同步或非同步。
快取一致性
上述內容只說明了一部分,因為我們仍需確保記憶體存取正確執行。由於 GPU 的工作負載高度平行,其記憶體階層結構比 CPU 複雜得多。它的許多快取並不一致,因此在同步處理方面需要做更多工作。 討論快取時的重要概念:- 回寫 (WB):將某個範圍 (或全部) 的快取行寫回主記憶體 (或階層中較上層的快取) 的作業。
- 失效:當快取失效時,其某個範圍 (或全部) 的快取行會標記為無效,未來的讀取會轉送至階層中的下一個快取,以擷取最新的值。
- 直寫:寫入會在快取中進行,同時也轉送至下一層。
- 已變更位元 (Dirty bit):如果快取行標記為已變更,表示快取已被修改,而主記憶體 (及其他快取) 擁有的是過時的副本。將需要排清 (WB) (並在其他快取上將此資料標記為無效,讓它們可以擷取最新的值)。
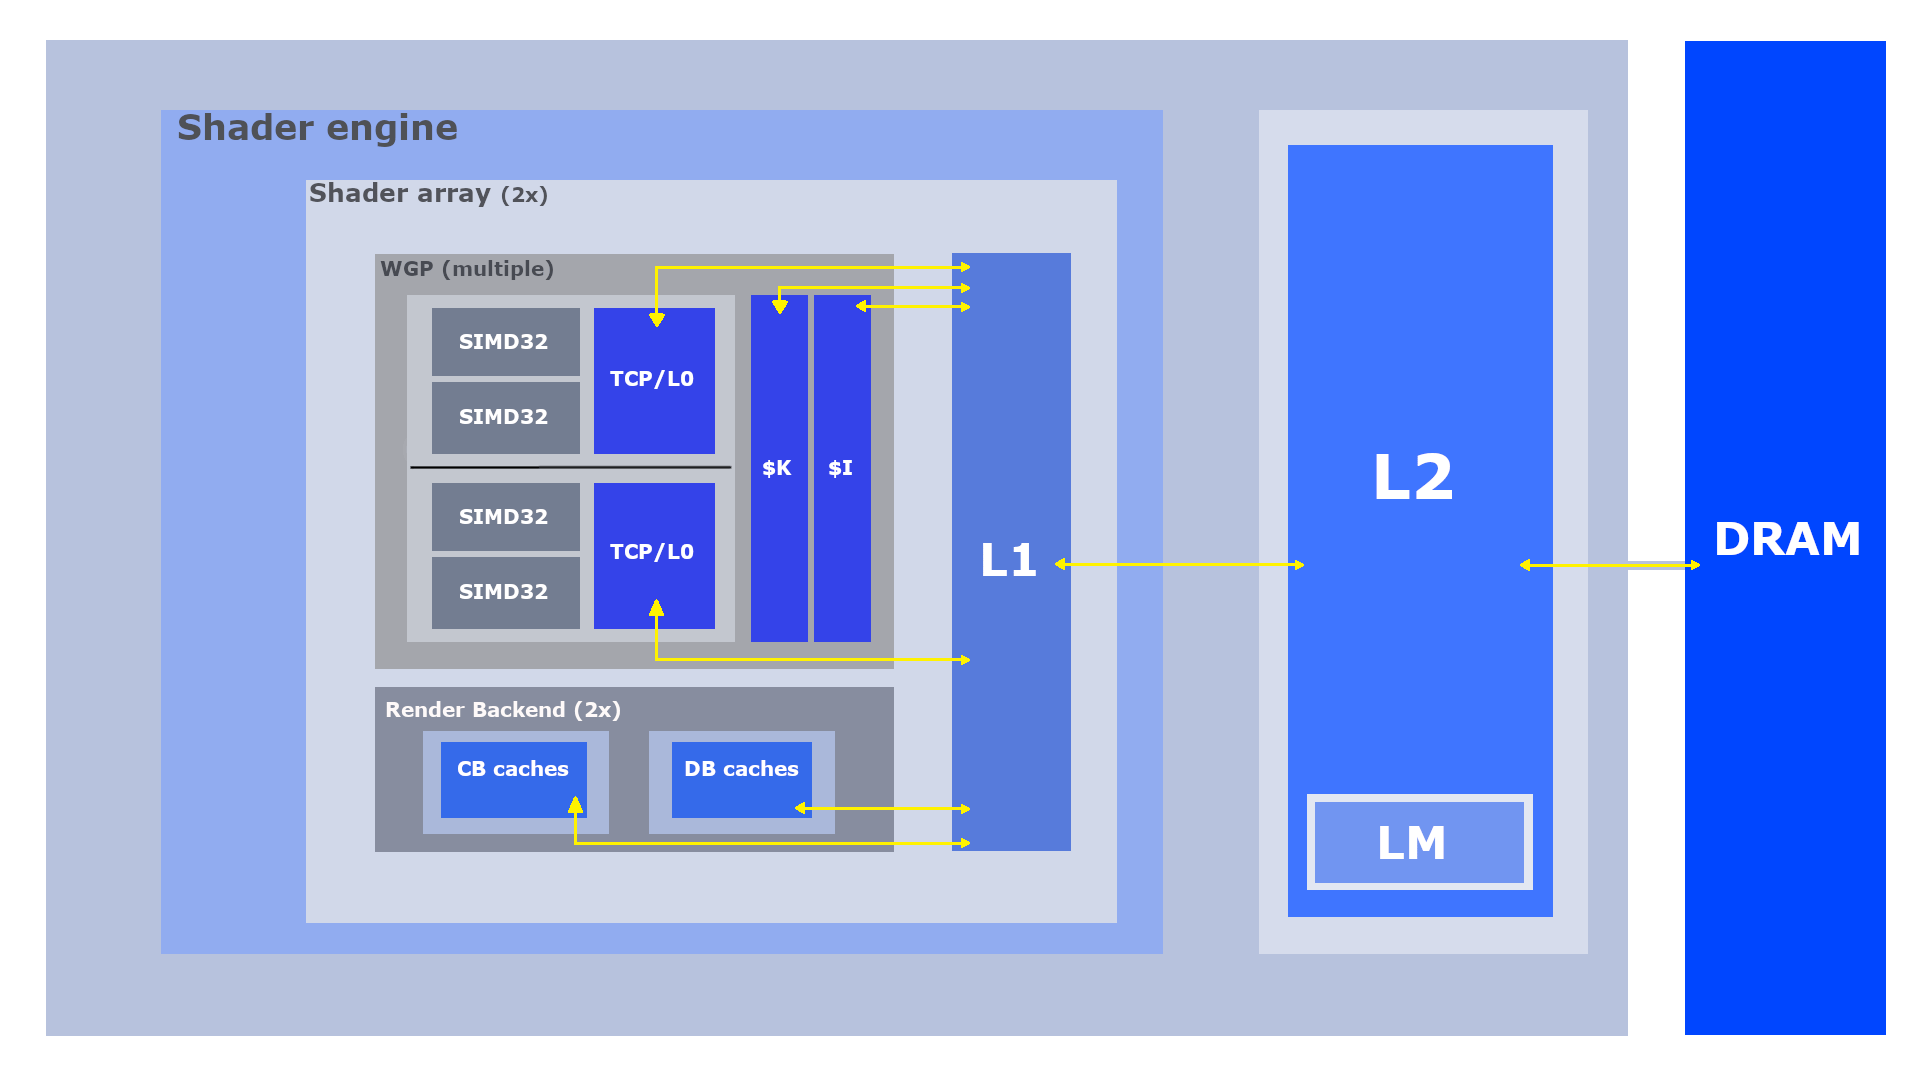
XBOX Series X|S 上的相關快取如下
此外,不同的快取在何時回寫/失效方面有不同的策略:
回到從 CS 寫入轉換為 PS 讀取的範例,我們現在可以檢視快取。UAV 寫入使用 L0-L1-L2 和 LM 快取。SRV 也使用相同的快取。由於我們是從寫入狀態轉換為讀取狀態,L0 和 L1 會失效。LM 也會失效,因為像素著色器可能會從中讀取。(LM 失效只會在資源具有中繼資料時發生)。