
Vue d’ensemble du matériel
La console XBOX One contient 8 Go de mémoire DDR3 unifiée, dont 5 Go sont accessibles aux titres du système d’exploitation exclusif. Cette mémoire est répartie en quatre canaux qui se connectent à quatre contrôleurs DRAM (DCT) dans le Northbridge unifié (UNB). Chaque canal fournit 17 gigaoctets par seconde (Go/s) de bande passante maximale partagée entre lectures et écritures, soit un total de 68 Go/s de bande passante maximale entre la mémoire principale et l’UNB. Les deux modules CPU se connectent aux DCT via le contrôleur mémoire (MCT). Le MCT fournit également l’accès mémoire à d’autres composants du système, tels que le Southbridge et le processeur audio SHAPE. Figure 1. Interaction entre le GPU de la XBOX One et le matériel mémoire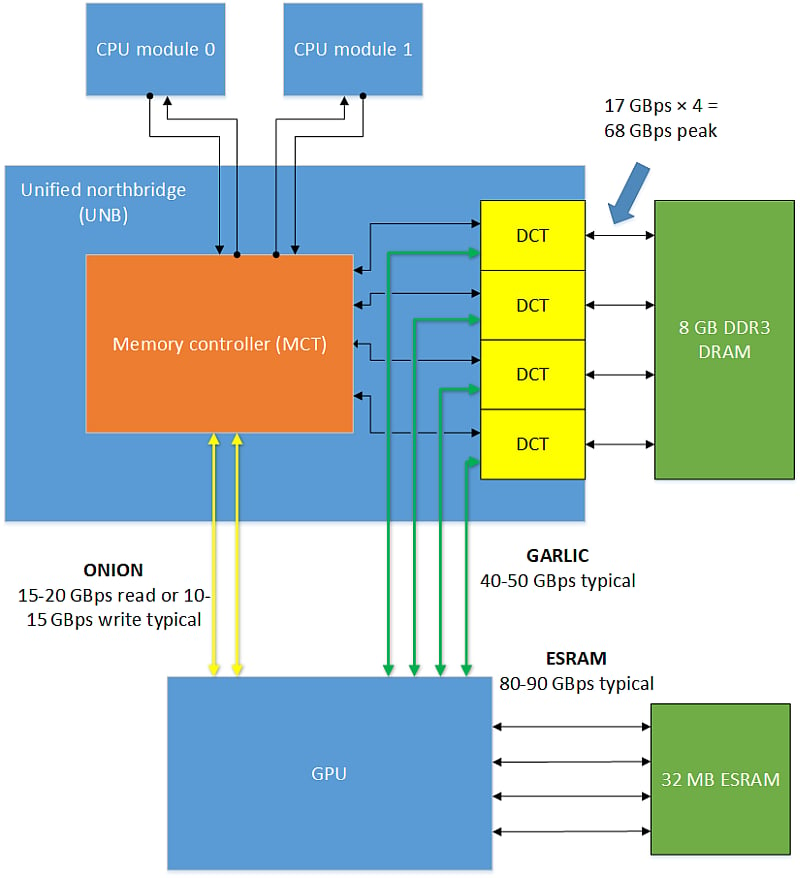
- Le bus graphics accelerated reduced latency integrated channel (GARLIC) est un bus à quatre canaux capable d’une bande passante maximale de 68 Go/s (limitée par la bande passante de la DRAM). Chacun des quatre canaux GARLIC est connecté directement à l’un des quatre contrôleurs DRAM.
- Le bus on-chip Northbridge to I/O noncoherent (ONION) est un bus à deux canaux capable d’une bande passante maximale de 24 Go/s en lecture ou de 15 Go/s en écriture, limitée par des composants du Northbridge. Les deux canaux ONION se connectent au MCT, qui confère au bus ONION certaines capacités supplémentaires dont GARLIC ne dispose pas. Certains types de trafic doivent utiliser le bus ONION.
ESRAM
La XBOX One contient également 32 Mo d’ESRAM haute vitesse connectée au GPU via un bus dédié. Le bus ESRAM se compose de quatre canaux fonctionnant à 853 MHz. Dans des circonstances ordinaires, chaque canal peut transférer 32 o par cycle d’horloge (en lecture ou en écriture), ce qui donne une bande passante théorique de : 4 canaux × 32 o par cycle × 853 MHz = 109,2 Go/s (avec 1 Go = 109 o) Dans certaines circonstances, le GPU peut émettre des requêtes de lecture en rafale vers l’ESRAM. Pendant qu’une lecture en rafale est traitée, le GPU peut continuer à émettre des opérations d’écriture, ce qui permet en pratique aux lectures et aux écritures de se dérouler en parallèle. Cela peut porter la bande passante atteignable au-delà du maximum de 109,2 Go/s. La bande passante soutenue maximale observée par l’ATG lors d’expériences est d’environ 133 Go/s, avec 80-90 Go/s typiquement dans des scénarios de rendu standard.Caches de textures du GPU
Le GPU contient des caches de textures L1 et L2 qui servent à atténuer la latence élevée des opérations mémoire. Le terme cache de textures est quelque peu trompeur : les caches de textures sont utilisés pour tous les accès mémoire qui ne sont pas gérés par les blocs de couleur et de profondeur (CB/DB), notamment les extractions de textures, les lectures de mémoires tampons et les lectures et écritures de vues d’accès non ordonné (UAV). Figure 2. Hiérarchie des caches de textures de la XBOX One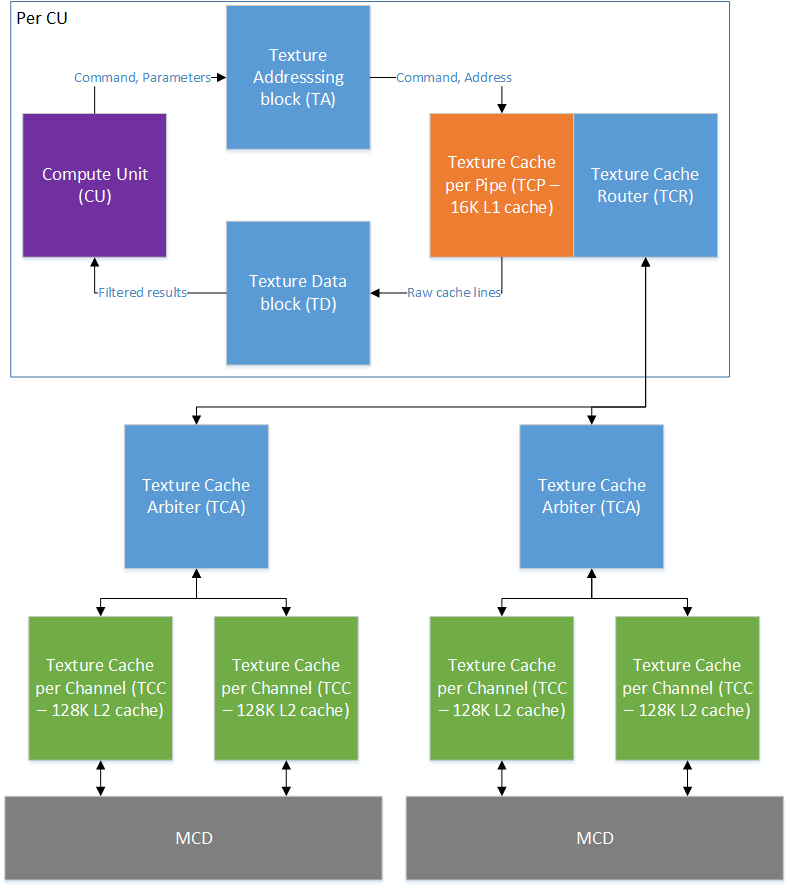
Accès fusionnés
Pour un SIMD donné, le TA/TCP peut traiter quatre extractions par cycle, de 128 bits (16 octets) au maximum chacune, soit un total de 512 bits (64 octets) extraits par cycle. Cela signifie qu’une instruction de lecture mémoire nécessite normalement 16 cycles d’horloge (64 threads ÷ 4 threads par cycle) pour être émise sur un wavefront entier. Si une instruction de lecture demande moins de 128 bits à la mémoire, une partie du bus de retour de données de 512 bits reste inutilisée. Par exemple, si chaque thread d’un wavefront demande une seule valeur à virgule flottante (32 bits) à une ressource de texture ou de mémoire tampon, seuls 128 bits au total (4 requêtes × 32 bits) sont extraits à chaque cycle. Cela ne représente qu’un quart du débit maximal possible. Lors de la lecture de valeurs à une seule composante depuis une texture en HLSL, les méthodes Gather peuvent être utilisées pour extraire quatre valeurs à la fois, ce qui améliore l’utilisation du bus de retour de données. Cependant, Gather n’est pas pris en charge pour les ressources de mémoire tampon. En revanche, lors de la lecture depuis une ressource de mémoire tampon, si des threads adjacents accèdent à des emplacements mémoire adjacents, le TA peut, dans certaines circonstances, fusionner les requêtes. Une situation courante où les lectures peuvent être fusionnées est celle où les 16 threads d’un quart de wavefront accèdent à une plage contiguë, alignée sur une ligne de cache, d’éléments 32 bits d’un UAV ou d’une mémoire tampon structurée. Cela permet d’émettre les 16 extractions en un seul cycle, fusionnées en quatre lectures contiguës de 128 bits. En général, pour obtenir la fusion, préférez les dispositions de mémoire tampon de type structure de tableaux (SoA) aux dispositions de type tableau de structures (AoS).Exemple
Dans l’exemple suivant, un simple appel de distribution de compute shader est analysé à l’aide des compteurs de performances de PIX afin de détecter un goulot d’étranglement lié au sous-système de cache.
Cet appel de distribution passe environ 45 % de son temps à attendre pour émettre des instructions de mémoire vectorielle, et l’unité de texture est occupée près de 100 % du temps.
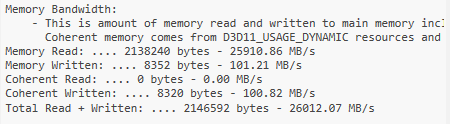
Le compteur GBRM_PERF_SEL_GUI_ACTIVE indique le nombre de cycles pendant lesquels le GPU était actif, tandis que TA_PERF_SEL_TA_BUSY indique le nombre de cycles pendant lesquels le TA était occupé. TCP_PERF_SEL_TCP_TA_ADDR_STALL_CYCLES indique le nombre de cycles pendant lesquels le TA a été bloqué par le TCP. Dans ce cas, le TA a été bloqué pendant presque toute la durée de la distribution.
TCP_PERF_SEL_TCR_TCP_STALL_CYCLES indique le nombre de cycles pendant lesquels le TCP a été bloqué par le TCR. Si la distribution était limitée par le cache L2 ou par le bus mémoire, ce nombre devrait être élevé par rapport à TCP_PERF_SEL_TCP_TA_ADDR_STALL_CYCLES. Comme ce nombre est faible, le blocage se produit très probablement à l’intérieur du TCP.
En examinant de plus près les autres compteurs TCP, on constate que les valeurs de TCP_PERF_SEL_READCONFLICT_STALL_CYCLES et de TCP_PERF_SEL_READ_TAGCONFICT_STALL_CYCLES sont assez élevées. Les descriptions de ces compteurs montrent clairement que les opérations de lecture sont bloquées en raison de la contention pour des ressources limitées à l’intérieur du TCP.
Enfin, la comparaison de TA_PERF_SEL_BUFFER_COALESCED avec TA_PERF_SEL_BUFFER_TOTAL_CYCLES montre qu’aucune opération de lecture n’est fusionnée.
Voici le code du shader de l’appel de distribution précédent :
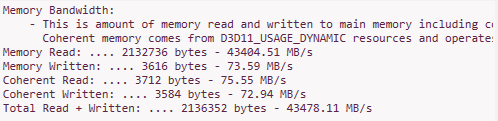
Le compteur TA_PERF_SEL_BUFFER_COALESCED_READ_CYCLES indique que les lectures sont fusionnées.
Le temps GPU total diminue considérablement, tout comme l’utilisation de l’unité de texture.
Les blocages précédemment rencontrés à l’intérieur du TCP disparaissent ; le TCP devient limité par le TCC et/ou le bus mémoire.
Cohérence mémoire et indicateurs d’accès
Le CPU et le GPU contiennent tous deux des caches à écriture différée (write-back) conçus pour réduire l’impact des accès à la mémoire principale sur les performances. Lorsque des données sont partagées entre le CPU et le GPU, veillez à ce qu’aucun des deux ne lise des données obsolètes depuis le cache. Le trafic mémoire généré par le GPU peut être non cohérent ou cohérent E/S, selon les indicateurs du descripteur de page de la mémoire consultée. Le trafic non cohérent se comporte essentiellement comme si le CPU n’existait pas. Il peut généralement utiliser le bus GARLIC, plus rapide, avec les résultats suivants : Lectures GPU Si un emplacement mémoire donné est présent dans l’un des caches du GPU, une lecture GPU de cet emplacement renvoie la valeur mise en cache. Le GPU extrait les lignes de cache directement depuis la DRAM. Le GPU n’examine pas les caches du CPU. Écritures GPU Lorsqu’une ligne de cache modifiée est évincée du cache L2 du GPU, elle est écrite directement dans la DRAM. Les caches du CPU peuvent contenir des valeurs obsolètes. Le trafic cohérent E/S espionne (snoop) les caches du CPU via le MCT du Northbridge. Le trafic cohérent E/S peut constituer un goulot d’étranglement des performances, car il doit utiliser le bus ONION, plus lent, avec les résultats suivants : Lectures GPU Lors de l’extraction d’une ligne de cache depuis la mémoire principale, le GPU sonde d’abord les caches du CPU. Si l’emplacement mémoire donné n’est pas présent dans les caches du CPU, le GPU extrait la valeur depuis la DRAM. Écritures GPU Lorsqu’une ligne de cache modifiée est évincée du cache L2 du GPU, le GPU sonde les caches du CPU et invalide toutes les entrées qui font référence à l’emplacement modifié. Le GPU écrit ensuite la ligne de cache modifiée dans la DRAM. La cohérence E/S vous permet d’éviter des vidages coûteux du cache du CPU après l’écriture dans une ressource sur le CPU. La cohérence E/S est donc utile pour les petites ressources fréquemment mises à jour, comme les mémoires tampons de constantes. Cependant, la cohérence E/S ne fonctionne que dans un sens : le GPU espionne les caches du CPU, mais pas l’inverse. Cela signifie que les caches du GPU doivent toujours être vidés si la ressource est modifiée par le CPU ou par le GPU. Lorsque vous allouez de la mémoire principale via D3DAllocateGraphicsMemory, vous pouvez choisir l’un des trois types de mémoire suivants : Mise en cache non cohérente (Cached Noncoherent)- D3D11_GRAPHICS_MEMORY_ACCESS_CPU_CACHE_NONCOHERENT
- La mémoire est mise en cache à la fois par le CPU et par le GPU.
- L’accès mémoire du GPU est non cohérent et peut généralement utiliser le bus GARLIC.
- Si la mémoire est écrite par le CPU, les plages appropriées des caches du CPU et du GPU doivent être vidées avant la lecture sur le GPU.
- La mémoire mise en cache non cohérente n’est pas recommandée pour les scénarios impliquant des écritures GPU et des lectures CPU, car ils sont dangereux et difficiles à réaliser correctement.
- D3D11_GRAPHICS_MEMORY_ACCESS_CPU_CACHE_COHERENT
- La mémoire est mise en cache à la fois par le CPU et par le GPU.
- L’accès mémoire du GPU est cohérent E/S et utilise toujours le bus ONION.
- Si la mémoire est écrite par le GPU, la plage appropriée des caches du GPU doit être vidée avant la lecture sur le CPU.
- Si la mémoire est écrite par le CPU, la plage appropriée des caches du GPU doit être vidée avant la lecture sur le GPU.
- D3D11_GRAPHICS_MEMORY_ACCESS_CPU_WRITECOMBINE_NONCOHERENT
- Les pages mémoire sont mises en cache par le GPU, mais pas par le CPU.
- Les écritures CPU sont combinées (write combined).
- L’accès mémoire du GPU est non cohérent et peut généralement utiliser le bus GARLIC.
Ressources à utilisation par défaut (DEFAULT)
Les fonctions de définition par placement, telles que CSSetPlacementConstantBuffer, permettent de mettre à jour rapidement et en toute sécurité une ressource DEFAULT tout en la liant simultanément au pipeline de rendu. Nous recommandons vivement aux titres d’utiliser les fonctions de définition par placement pour les mises à jour de ressources chaque fois que possible. Toutefois, pour faciliter le portage des moteurs Direct3D 11 existants, il est également possible de mettre à jour les ressources DEFAULT à l’aide de Map et Unmap. Lorsque vous mappez une ressource à utilisation DEFAULT, vous devez passer l’indicateur D3D11_MAP_FLAG_ALLOW_USAGE_DEFAULT :- MAP_READ
- MAP_WRITE
- MAP_READWRITE
- MAP_WRITE_NO_OVERWRITE
Chiffrement de la mémoire et écritures partielles
La mémoire des titres sur XBOX One peut éventuellement être chiffrée dans la DRAM. Les DCT effectuent le chiffrement et le déchiffrement avec une granularité de 16 octets (128 bits). Pour cette raison, les requêtes de lecture et d’écriture adressées aux DCT pour de la mémoire chiffrée doivent être un multiple de 16 octets. Les écritures partielles (c’est-à-dire les écritures de moins de 16 octets) nécessitent une opération de lecture-modification-écriture : le bloc de 16 octets qui contient la cible doit être extrait du DCT approprié, modifié, puis renvoyé au DCT pour être écrit dans la DRAM. Les opérations de lecture-modification-écriture consomment davantage de bande passante DRAM que les opérations de lecture ou d’écriture standard. En outre, le GPU n’est pas en mesure d’effectuer des opérations de lecture-modification-écriture via le bus GARLIC ; les écritures partielles dans la mémoire chiffrée sont donc contraintes d’utiliser le bus ONION, plus lent. Bien que le chiffrement soit effectué sur des blocs de 16 octets, l’interface mémoire entre le GPU et les bus ONION et GARLIC a une largeur de 32 octets. Par conséquent, lorsqu’une modification partielle porte sur le premier ou le second mot d’un bloc de 32 octets, la transaction entière de 32 octets est acheminée via ONION. Les écritures partielles peuvent avoir de nombreuses causes, notamment (liste non exhaustive) :- Les écritures masquées dans des ressources, par exemple en effectuant un dessin avec le membre RenderTargetWriteMask de la structure D3D11_RENDER_TARGET_BLEND_DESC défini sur une valeur autre que D3D11_COLOR_WRITE_ENABLE_ALL.
- Les petites écritures dispersées dans un UAV dans un compute shader.
- La rastérisation de primitives ayant une faible efficacité de quad, notamment les points, les lignes et les petits triangles.
- Le déversement en mémoire de structures de données internes du GPU.