
Si vous n’êtes pas encore familiarisé avec la structure des caches du GPU XBOX One, nous vous recommandons de lire d’abord la documentation sur le cache GPU sur XGD.
Introduction
Le GPU XBOX One nécessite une synchronisation explicite lorsque des données sont produites par un type de cache ou de DMA, puis consommées par un autre cache ou DMA. Avec l’introduction des contextes à sémantique rapide et des contextes de calcul asynchrone dans DirectX 11.X, les développeurs de titres sont désormais responsables de la gestion des risques liés aux ressources. Il est donc particulièrement important de comprendre les différents mécanismes de synchronisation sur le GPU. DirectX 12 supprime également le suivi des risques de l’API. L’abstraction de DirectX 12 se situe à un niveau plus élevé que celle de DirectX 11.X, mais il est également important de comprendre les mécanismes de synchronisation GPU de bas niveau sous DirectX 12.Synchronisation du GPU
Le GPU XBOX One dispose de huit contextes graphiques, dont sept sont disponibles pour les jeux. En termes simples, on dit qu’une séquence d’appels de dessin partageant le même état de rendu partage le même contexte. Les dispatchs ne nécessitent pas de contextes graphiques et peuvent s’exécuter en parallèle du travail graphique. En général, deux concepts interviennent dans la synchronisation du GPU : le pipelining et les caches. À un niveau très basique, un GPU peut être considéré comme un pipeline dans lequel les appels de dessin et les dispatchs de compute shader entrent par le processeur de commandes et se retirent une fois entièrement exécutés. Même si les dessins et les dispatchs peuvent s’exécuter simultanément sur le GPU, ils ne se dépassent pas les uns les autres et se retirent toujours dans l’ordre. Il est particulièrement important de connaître deux aspects du pipelining :- Comment garantir que deux appels de dessin ou dispatchs ne s’exécutent pas simultanément. Cela est nécessaire pour garantir que l’appel de dessin qui produit les données n’exécute pas de vagues en même temps que celui qui consomme les données.
- Où insérer les différents événements programmables, c’est-à-dire en haut du pipeline ou en bas.
Aperçu des étapes du pipeline
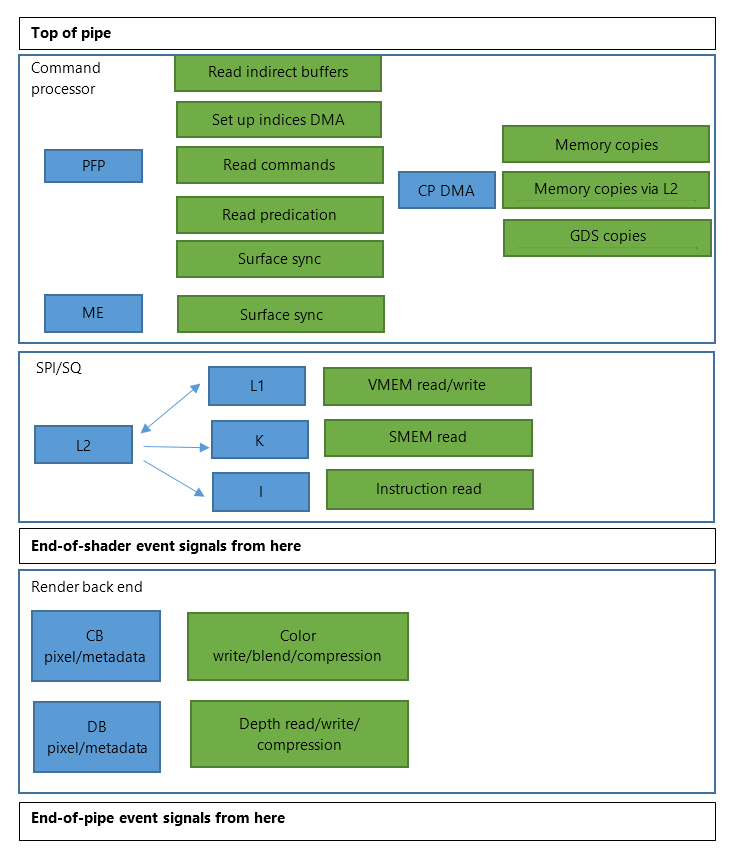
Voici un aperçu du pipeline du point de vue de la synchronisation : Tout en haut du pipeline se trouve le processeur de prélecture (PFP), qui est la partie du processeur de commandes qui lit la mémoire pour le micro-moteur (ME). Le PFP lance également l’accès direct à la mémoire (DMA) pour le bloc de géométrie et de tessellation des sommets (VGT), en particulier pour les tampons d’index et les tampons de dessin indirect. Le PFP est responsable des tâches suivantes :- Lecture des données du tampon de commandes.
- Déclenchement des transferts DMA du tampon d’index pour le VGT.
- Lecture des paramètres du tampon indirect.
- Lecture des informations de prédication.
- Communication et synchronisation avec le ME.
- Un paquet de dessin ou un paquet de commande de dispatch entre dans le processeur de commandes par le processeur de prélecture.
- Le paquet est exécuté par le micro-moteur.
- Les étapes de shader du paquet sont exécutées par l’entrée du processeur de shaders (SPI) et le séquenceur (SQ).
- Le back-end de rendu à fonction fixe (comprenant le bloc d’exportation des shaders [SX], le bloc de profondeur [DB] et le bloc de couleur [CB]) termine le travail non lié aux shaders.
Événements de fin de pipe et de fin de shader
Divers événements peuvent être insérés dans le pipeline entre les dispatchs et les dessins. Ils transitent tous dans le pipeline dans l’ordre, avec les dispatchs et les dessins. Deux types d’événements présentent un intérêt particulier : la fin de pipe (EOP) et la fin de shader (EOS). Figure 1. Pipeline de synchronisation avec des flèches indiquant à quel moment les événements EOS et EOP sont signalés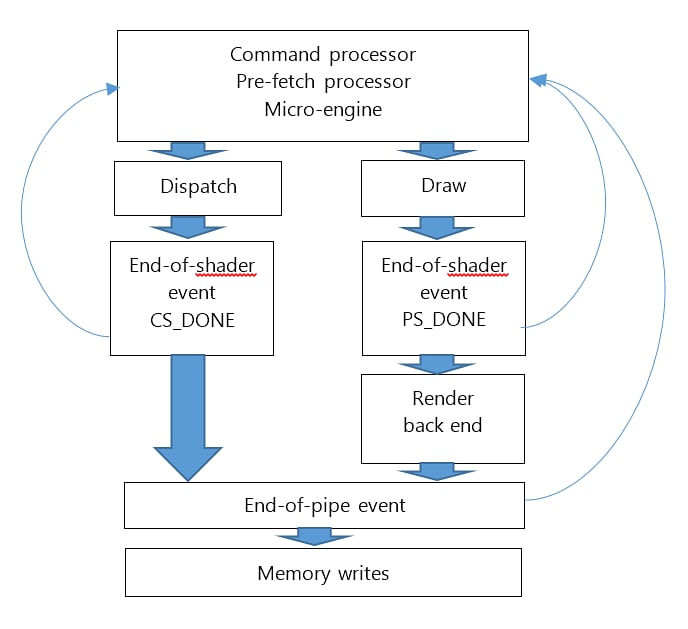
Barrière de pipeline
Une barrière de pipeline de dessin et de dispatch est parfois nécessaire pour garantir que deux appels de dessin ou dispatchs ne s’exécutent pas en parallèle. Par exemple, lorsque vous devez invalider un cache entre deux appels de dessin afin que l’appel de dessin suivant voie des données à jour en mémoire, et que les deux appels de dessin s’exécutent en même temps, aucun vidage de cache ne fonctionnera ; les données risquent d’être consommées avant d’être produites. C’est dans ce cas que vous devez vous assurer que l’appel de dessin ou le dispatch précédent est terminé avant que le suivant ne commence. Figure 2. Si les wavefronts ou le travail back-end du producteur chevauchent les wavefronts du consommateur, une barrière est nécessaire pour garantir qu’ils se synchronisent correctement.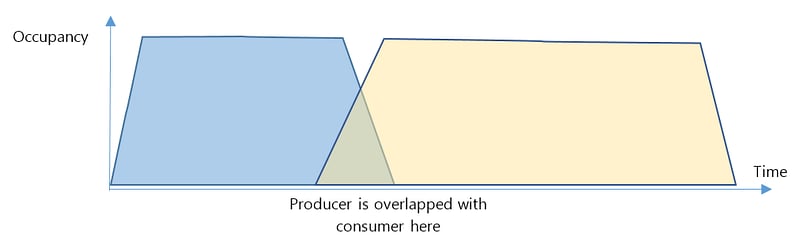
Vidage partiel
Un vidage partiel est une barrière qui peut être insérée entre deux appels de dessin ou dispatchs pour garantir qu’un appel de dessin précédent se termine avant que le suivant ne commence. À la réception d’une commande de vidage partiel, le processeur de commandes bloque l’exécution des paquets jusqu’à ce qu’il reçoive un signal indiquant qu’une étape de vertex shader (VS), de pixel shader (PS) ou de compute shader (CS) s’est entièrement vidée. Un seul événement de vidage partiel peut être actif à la fois dans le processeur de commandes. Notez que les barrières de vidage partiel sont levées à l’événement de fin de shader, et non lorsque l’écriture de la mémoire est terminée. Un vidage partiel peut être émis dans DirectX 11.x à l’aide de la méthode GpuSendPipelinedEvent avec l’un des indicateurs PARTIAL_FLUSH.Fences EOS et EOP
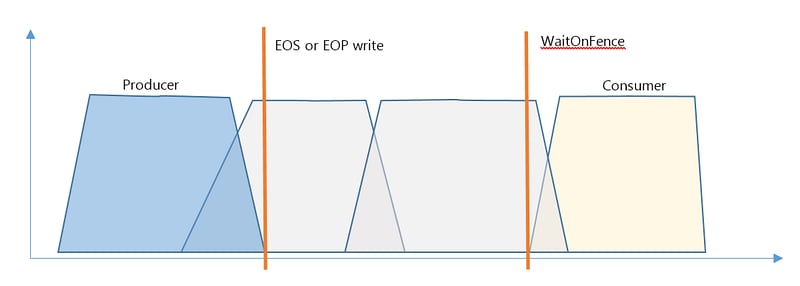
Une fence est une primitive de synchronisation bien connue qui peut également servir de barrière. Au moins deux paquets interviennent dans une telle barrière. Le premier amène le GPU à écrire une valeur à un emplacement mémoire. Le second bloque le processeur de commandes jusqu’à ce que la valeur en mémoire satisfasse une condition spécifiée dans le second paquet. Une fence peut servir de barrière parce que la valeur est généralement écrite à la position EOP ou EOS du pipeline, et que l’attente a lieu en haut du pipe. En pratique, cela signifie que si un appel de dessin « avant la fence » est toujours en cours et que la commande « attendre la fence » a été exécutée, tout le traitement du tampon de commandes est bloqué jusqu’à ce qu’il atteigne l’étape EOP ou EOS. L’inconvénient de l’utilisation de fences comme barrières de pipeline est le coût d’au moins deux transactions mémoire, soit au moins 800 cycles ou 1 µs. Une méthode InsertWaitUntilIdle effectue une écriture EOP suivie d’une attente immédiate. C’est la barrière de pipeline la plus lourde. Cette barrière est la plus courte lorsque le GPU est déjà complètement inactif. La méthode WriteValueEndOfPipe écrit des valeurs EOP ou EOS à un emplacement mémoire, et la méthode InsertWaitOnMemory insère une attente sur l’emplacement mémoire jusqu’à ce qu’il soit égal à la valeur donnée dans le paquet. Notez que le GPU prend en charge plusieurs fonctions de comparaison, telles que inférieur à ou supérieur à, qui sont exposées dans l’API DirectX 11.x. Le GPU prend également en charge les attentes de fence dans le PFP et le ME, qui sont aussi exposées dans DirectX 11.x. Il est également possible d’éviter la synchronisation en comptant le nombre de changements de contexte (context rolls) entre le producteur et le consommateur. Si huit changements de contexte ont eu lieu entre le producteur et le consommateur, il est garanti que le producteur s’est retiré du GPU.Différences entre les barrières PARTIAL_FLUSH, fence EOS et fence EOP
Si le producteur est immédiatement suivi du consommateur, un vidage partiel et une barrière de fence EOP sont pratiquement équivalents. Si le producteur et le consommateur sont tous deux des dessins ou tous deux des dispatchs, la barrière de fence EOS fonctionnera de la même manière. Dans ce cas, les trois barrières seraient équivalentes, sauf que chaque fence doit effectuer deux allers-retours en mémoire. Par conséquent, lorsqu’un producteur est suivi d’un consommateur, il est judicieux d’utiliser une barrière de vidage partiel. Toutefois, s’il existe d’autres appels de dessin et dispatchs entre le producteur et le consommateur, l’utilisation d’un vidage partiel pourrait entraîner un blocage inutile du pipeline. Rappelez-vous qu’un vidage partiel vide toujours le pipeline à partir de l’étape de shader spécifiée avant que le paquet de commande suivant soit exécuté, comme l’illustre la figure 3. Le blocage du pipeline entre la fin du second appel de dessin non producteur et le début de l’appel de dessin consommateur peut être inutile. Figure 3. Même si le producteur a terminé au moment où le consommateur commence et que les deux appels de dessin intermédiaires sont indépendants, le vidage partiel introduit un blocage. Dans ce cas, le blocage est inutile ; le producteur ne chevaucherait jamais le consommateur.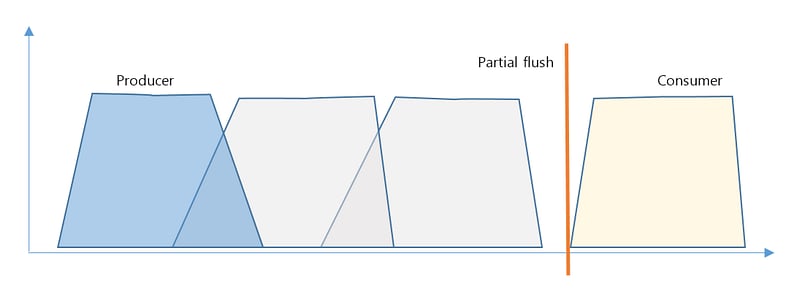
Présentation des caches
Le GPU XBOX One comporte de nombreux caches. S’assurer que les barrières de pipeline sont correctement placées constitue la première étape de la synchronisation. La seconde étape consiste à vider et à invalider les caches correspondants afin que les données écrites par le producteur soient visibles par le consommateur. Les caches du GPU XBOX One prennent généralement en charge une réécriture et invalidation (writeback-and-invalidate) en une seule opération et, à l’exception du bloc de profondeur, il est impossible de spécifier la plage mémoire de cette opération. Le processeur de commandes peut signaler les vidages de cache en haut ou en bas du pipe. Toutes les lignes de cache font 64 octets.Opérations de cache prises en charge
Le tableau suivant répertorie les différents caches du GPU XBOX One, ainsi que leurs noms matériels et les opérations prises en charge. Une explication de ces caches suit le tableau.- Les caches L2 et L1 prennent en charge le vidage et l’invalidation en une seule opération. Les caches L1 et L2 prennent également en charge une opération de réécriture sans invalidation, mais uniquement pour les lignes de cache spécialement marquées comme « volatiles ». Les lignes de cache volatiles doivent être marquées spécifiquement au moyen d’un descripteur de ressource et, en octobre 2014, elles ne sont pas prises en charge par le pilote graphique XBOX One. Les caches L1 et L2 ne respectent pas les plages de vidage.
- Les caches CB et DB prennent tous deux en charge le vidage et l’invalidation en une seule opération. Le CB ne respecte pas les plages de vidage.
- Seul le DB prend en charge une opération de vidage et d’invalidation par plage sur ses caches. Les autres blocs invalident toujours l’intégralité du cache. Cela signifie que le coût d’un vidage de cache peut être important.
Ressources D3D et caches
Les différents types de ressources D3D utilisent différents caches GPU.- Toutes les lectures et écritures de tampons non constants, de textures et d’UAV sont effectuées via les caches L1 et L2, respectivement le TCP et le TCC. En d’autres termes, toutes les instructions VMEM passent par les caches L1 et L2, qui sont des caches en lecture et en écriture.
- Les lectures de tampons scalaires sont effectuées via le K est un cache en lecture seule qui lit via le L2. Toutes les instructions SMEM lisent via le K$ et le cache L2.
- Les instructions de shader sont lues via le I est un cache en lecture seule.
- L’accès à la mémoire du tampon de couleur s’effectue via un ensemble de caches CB (bloc de couleur). Cela inclut la lecture des données pour le blending ; le blending lui-même a lieu dans l’unité CB. Les caches CB incluent les pixels réels et les métadonnées de surface, telles que CMask et FMask.
- L’accès à la mémoire du tampon de profondeur s’effectue via les caches du bloc de profondeur (DB). Cela inclut les données en lecture et en écriture pour les tests de profondeur, la compression et les mises à jour Hi-Z. Les caches DB incluent les pixels de profondeur réels, les métadonnées de la surface de profondeur telles que la compression (PMask et plans) et les informations Hi-Z (HTile).
Vidages en haut de pipe et en fin de pipe
Il existe une différence entre une opération d’invalidation de cache en haut de pipe et en fin de pipe (pipelinée). Une opération d’invalidation de cache en haut de pipe envoie le signal d’invalidation au cache cible immédiatement après que le processeur de commandes a lu le paquet de vidage correspondant, quel que soit le travail en cours d’exécution sur le GPU à ce moment-là. C’est pourquoi les vidages de cache en haut de pipe sont généralement effectués après un blocage de barrière de pipeline : le producteur a terminé son travail et le consommateur n’a pas encore commencé le sien. Une opération de cache pipelinée est exécutée à la fin de pipe de l’appel de dessin précédent. Certains vidages ne peuvent être émis que sous forme d’événements de fin de pipe, par exemple les vidages des caches de métadonnées CB et DB. Tout vidage de cache se déclenche immédiatement, mais prend un certain temps pour se terminer. Certains appels de dessin et dispatchs en cours peuvent se retrouver avec des caches froids en cours d’exécution. C’est une autre raison pour laquelle les vidages de cache peuvent être coûteux. Un vidage de cache en fin de pipe peut être émis à l’aide de l’API GpuSendPipelinedEvent dans DirectX 11.x, et le vidage de cache en haut de pipe peut être émis par des paquets FlushGpuCacheRange. Des API équivalentes existent pour les contextes de calcul asynchrone : FlushGpuCachesBottomOfPipe et FlushGpuCachesTopOfPipe.Stratégies du cache L1
Toutes les opérations VMEM passent par la hiérarchie de caches L1-L2. Alors que le cache L2 est partagé entre toutes les unités de calcul et qu’aucune synchronisation n’est généralement nécessaire pour garantir la cohérence des instructions VMEM, le L1 est instancié par unité de calcul. Il est donc important de comprendre les stratégies du cache L1. Le cache L1 prend en charge les quatre stratégies suivantes : HIT_LRU Cette stratégie autorise les accès réussis (hits) sur les données du wavefront précédent et conserve les données de la vague actuelle dans le cache pour les vagues suivantes. HIT_EVICT Cette stratégie autorise les accès réussis sur les données du wavefront précédent, et les données de la vague actuelle sont invalidées dans le cache lorsque la vague est terminée. MISS_LRU Cette stratégie n’autorise pas les accès réussis sur les données du wavefront précédent et conserve les données de la vague actuelle dans le cache pour les vagues suivantes. MISS_EVICT Cette stratégie n’autorise pas les accès réussis sur les données du wavefront précédent, et les données de la vague actuelle sont invalidées dans le cache lorsque la vague est terminée. Les lectures prennent en charge l’une ou l’autre des quatre stratégies, les écritures prennent en charge les variantes MISS*, et les opérations atomiques ne prennent en charge que la stratégie MISS_EVICT. Actuellement, le pilote est programmé pour utiliser HIT_LRU pour les lectures et MISS_LRU pour les écritures. Étant donné que ces deux stratégies permettent à une lecture d’atteindre l’écriture d’une vague précédente, le vidage du cache L1 peut être nécessaire dans certains cas.Synchronisation de surface
Une synchronisation de surface (surface sync) est une commande en haut de pipe que le pilote utilise pour déclencher divers vidages et invalidations de cache. Elle garantit également que les confirmations d’écriture des écritures mémoire ont été reçues. C’est ce que l’on appelle une opération de cohérence. Les opérations de cohérence peuvent être effectuées sur les blocs de couleur et les blocs de profondeur, ainsi que sur quatre emplacements mémoire arbitraires, utilisés pour la synchronisation du stream-out (SO). Une opération d’invalidation de cache et une opération de cohérence peuvent être spécifiées dans le même paquet. Une opération de cohérence fonctionne en vérifiant d’abord si une surface définie par les paramètres de pointeur de base et de taille est actuellement utilisée par des contextes graphiques actifs, puis en bloquant le CP jusqu’à ce que ces contextes graphiques soient terminés et que les confirmations d’écriture des surfaces soient reçues. Une opération de synchronisation de surface implique un changement de contexte, sauf si elle est émise entre la définition d’un registre de contexte et un dessin. Notez qu’un événement pipeliné est associé à un contexte actuel ; ainsi, une séquence Draw/ContextRoll/InsertPipelinedEvent/InsertSurfaceSync-attendant-l’événement-pipeliné ne fonctionnera pas, car le contexte nouvellement changé ne comporte aucun dessin. Pourquoi une opération de cohérence peut-elle être nécessaire ? Le déclenchement d’une invalidation de cache ne rend pas cette mémoire immédiatement disponible et visible pour les autres blocs du GPU. Il faut parfois des milliers de cycles pour terminer l’opération de vidage du cache. En plus de rendre les vidages de cache très coûteux, cela signifie également qu’un mécanisme est nécessaire pour garantir que le vidage est terminé avant de démarrer un appel de dessin qui consomme ces données. Une opération de synchronisation de surface peut être utilisée comme barrière entre un producteur et un consommateur si le producteur écrit via le CB ou le DB. Pour configurer une telle barrière, activez simultanément les opérations de vidage et de cohérence sur le paquet de synchronisation de surface. Vous pouvez le faire comme indiqué dans l’exemple suivant.Synthèse
Compte tenu de cette discussion sur les différentes options de synchronisation et de cohérence du GPU, comment déterminer quelles opérations fourniront le scénario de synchronisation optimal pour votre titre ? La matrice des combinaisons possibles est très vaste, ce qui rend peu pratique une approche par formule. Considérez plutôt le fonctionnement de la synchronisation d’un point de vue pratique. Ainsi, toute opération peut être déduite à partir des principes fondamentaux. Idéalement, la synchronisation doit être aussi légère que possible. Il est toujours possible d’insérer la barrière GPU la plus lourde et de vider tous les caches au niveau du PFP, ce qui arrête complètement le GPU et invalide tout ce qu’il contient. Cette approche est utile pour déboguer les problèmes de synchronisation, mais elle est trop brutale pour être utilisée en production. Voici un algorithme possible pour choisir la synchronisation appropriée :- Identifiez les blocs qui seront responsables de la production et de la consommation des données. Producteurs typiques :
- CB : surfaces de couleur, pixels et métadonnées.
- DB : surfaces de profondeur, pixels et métadonnées.
- TCP/TCC : UAV en écriture directe, CopyMemoryToMemory.
- SO : stream-out (une synchronisation complète est nécessaire).
- CP : WriteValueEndOfPipe, WriteTimestampToMemory.
- CP DMA (peut utiliser le TCC) : WriteGDS, certaines CopyResources.
- CPU : écritures sur le CPU.
[!NOTE] Pour plus d’informations sur l’amélioration des performances du rendu CPU, reportez-vous au livre blanc intitulé « Command Lists, Draw Bundles, and Deferred Contexts », disponible en téléchargement sur la page Livres blancs de XGD. Consommateurs typiques : 1. TCP/TCC : toutes les textures, tous les tampons de sommets et toutes les lectures d’UAV.
- K$/TCC : tous les tampons constants.
- CB : blending des couleurs.
- DB : test de profondeur.
- CP/PFP : tampons de prédication, indices de sommets et tampons indirects.
- CPDMA (peut éventuellement lire via le TCC) : ReadGDS depuis la mémoire, certaines CopyResources.
- Insérez un vidage de cache pipeliné (en fin de pipe) pour le producteur.
- GpuSendPipelinedEvent pour CB, DB et SO.
- WriteValueEndOfPipe avec les indicateurs L1/L2 pour le TCP/TCC.
- Utilisez la barrière de pipeline appropriée entre le producteur et le consommateur.
- Vidage partiel
- Fence EOS
- Fence EOP
- Synchronisation de surface
- Après l’opération d’attente de la barrière, insérez une invalidation de cache en haut de pipe pour le consommateur. Cela se fait invariablement via une opération GpuCacheFlushRange, qui invoque une synchronisation de surface.
Exemples
Les exemples suivants illustrent l’application pratique des opérations de synchronisation abordées dans cette rubrique. Synchronisation lorsqu’un tampon constant est mis à jour par le CPU- Si le CPU utilise de la mémoire à écriture combinée et que l’adresse du tampon dynamique n’a pas été vue dans cette image, ne faites rien. Si les pointeurs ne sont pas alignés sur 64 octets et que l’allocation est séquentielle, videz le cache K.
- Émettez un vidage GPU en haut de pipe des caches K et L2. Comme les vidages ne respectent pas la plage, n’émettez un vidage qu’une seule fois par lancement.
- Émettez un appel de dessin producteur qui effectue le rendu dans l’objet X en tant que cible de rendu via CB0.
- Émettez un vidage et une invalidation pipelinés des pixels du tampon de couleur. Méthode 1. À utiliser lorsqu’il existe davantage de dessins ou de dispatchs indépendants entre les producteurs et les consommateurs, afin de tenter d’éliminer une bulle.
- Émettez une écriture mémoire EOS PS_DONE.
- Avant que le consommateur ne démarre, insérez une attente sur la mémoire.
- Insérez un PS_PARTIAL_FLUSH.
- Insérez un vidage du cache L2 en haut de pipe.
- Émettez un dessin consommateur.
- Émettez un dispatch producteur qui écrit dans l’UAV X.
- Émettez un vidage pipeliné des caches L1/L2.
- Émettez une écriture de fence EOP F (nécessite une synchronisation entre un CS et un PS).
- Avant que le consommateur ne démarre, insérez une attente sur la fence F. (Vous pouvez également utiliser un CS_PARTIAL_FLUSH à la place des étapes 3 et 4.)
- Émettez un vidage et une invalidation pipelinés des caches CB et CB_META.
- Émettez un dessin.
- Émettez un dispatch producteur qui écrit dans l’UAV X.
- Émettez un vidage pipeliné des caches L1/L2.
- Émettez une écriture de fence EOP F (nécessite une synchronisation entre un CS et un PS). Méthode 1 Avant que le consommateur ne démarre, insérez une attente sur la mémoire F sur le PFP. La synchronisation doit avoir lieu au niveau du PFP, car c’est lui qui lit les tampons indirects. Méthode 2 Utilisez une attente sur la mémoire sur le ME, suivie de PFP_SYNC_TO_ME.
- Émettez un dessin indirect.