
Pipelining
Pour implémenter la synchronisation correcte et la plus efficace, il est important de comprendre les blocs matériels du GPU XBOX Series X|S, depuis le moment où il reçoit une commande pour lancer une action jusqu’au moment où il termine l’exécution de cette action. Le processeur de commandes (CP, Command Processor) est le bloc du GPU qui reçoit les commandes depuis la mémoire (en termes simples, les commandes que nous envoyons dans les D3D12CommandLists) sous forme de paquets (qui peuvent être visualisés dans la vue de désassemblage des commandes de PIX). Le CP est un bloc complexe comportant de nombreux éléments, mais nous pouvons le simplifier en le divisant en trois :- Command Processor Fetcher (CPF), qui récupère les paquets en mémoire et les envoie au CPG ou au CPC pour un traitement ultérieur.
- Command Processor Graphics (CPG), qui gère et traite les commandes du pipe graphique.
- Command Processor for Compute (CPC), qui s’exécute en parallèle du CPG et gère et traite les commandes du pipe de calcul (utilisé par Async Compute).
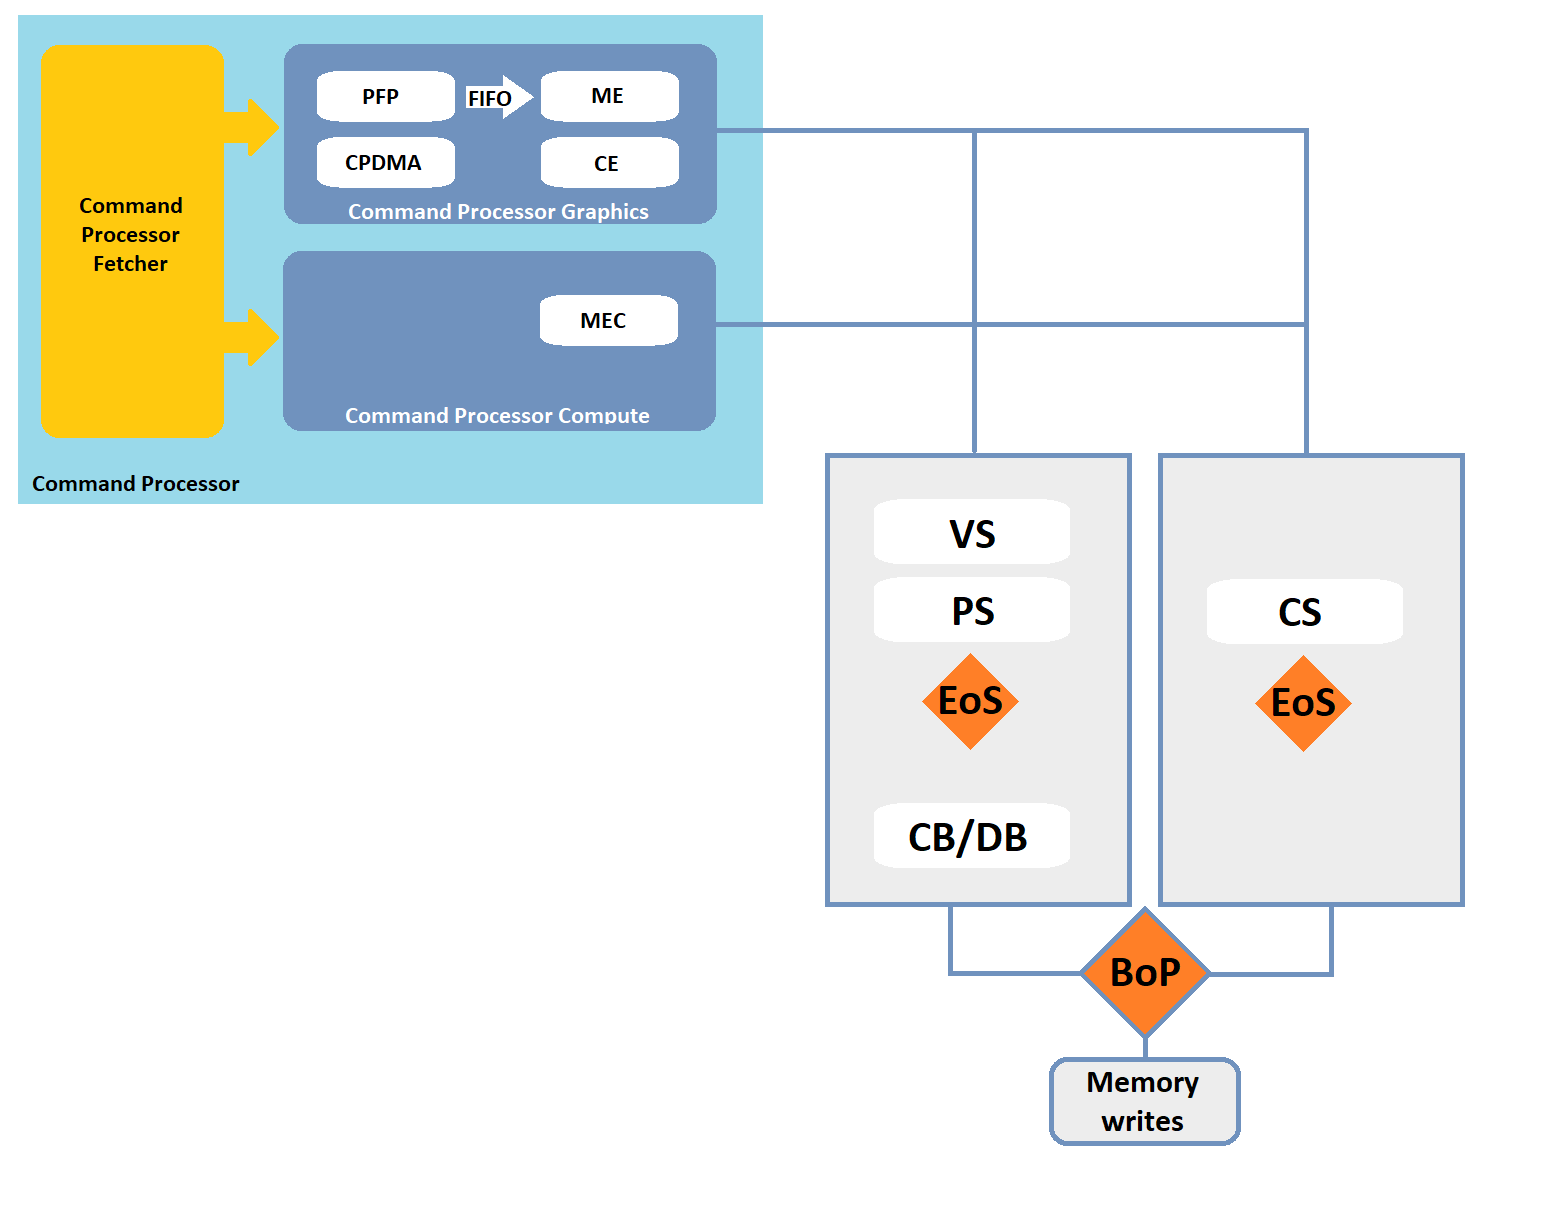
- Le PFP récupère les données des tampons d’index, gère les arguments indirects et les informations de prédication, et se synchronise avec le ME.
- Le ME peut déclencher des vidages, lancer des dessins/dispatches et dispose d’emplacements CPDMA pour lancer des copies.
- Le Constant Engine (CE) est un bloc à l’intérieur du CPG qui dispose d’une RAM utilisée pour stocker les constantes nécessaires à chaque commande de dessin. Il copie ces constantes dans le L2, puis signale au ME que les données sont prêtes (afin que le ME puisse bloquer les commandes de dessin jusqu’à ce que les constantes soient en place). Le ME peut également signaler au CE que les dessins sont terminés afin qu’il puisse réutiliser ses ressources.
- CP Direct Memory Access (CPDMA) se charge d’effectuer les copies (depuis et vers la mémoire/les registres) et peut être déclenché par le PFP, le ME ou le MEC. Il peut copier depuis et vers n’importe quelle mémoire virtuelle.
- Les événements End of Shader (EoS) s’exécutent une fois que toutes les waves du dispatch/dessin sont terminées, mais n’attendent pas que le render backend ait terminé (dans le scénario du pipeline fixe).
- Bottom of Pipe (BoP) correspond au moment où tout le travail des nuanceurs et du render backend est terminé, mais n’offre aucune garantie concernant les écritures en mémoire.
- pour le calcul, EoS et BoP sont identiques puisqu’il n’y a pas de travail du render backend.
- Fences
- Primitives de synchronisation constituées d’(au moins) deux paquets. Le premier écrit une valeur de référence à un emplacement mémoire. Ce paquet est un événement qui peut être configuré pour s’exécuter comme un événement EoS ou comme un événement BoP. Le second paquet est une attente qui bloque un moteur (PFP ou ME), empêchant les paquets suivants de passer, tout en interrogeant en continu l’emplacement mémoire jusqu’à ce que la valeur lue satisfasse une fonction de comparaison. À ce moment-là, le moteur bloqué est libéré et le travail peut se poursuivre.
- Vidage partiel
- Les vidages partiels font attendre le CP jusqu’à ce que tout le travail lié aux nuanceurs de sommets, de pixels ou de calcul (selon le paquet) soit terminé. Le ME bloque tous les paquets suivants jusqu’à ce qu’il reçoive un signal de la SPI.
- Pour la fence, nous créerions une fence EoS qui écrit en mémoire après le travail de calcul (le premier paquet de fence serait donc placé après le dispatch). Et nous ferions en sorte que le second paquet de fence bloque le moteur ME jusqu’à ce que la valeur en mémoire soit mise à jour (nous ne pouvons pas bloquer sélectivement les étapes en aval du ME ; dans ce scénario, le moteur à bloquer sera donc soit le ME, soit le PFP).
- Cela peut également être géré avec un vidage partiel CS, qui bloque le ME jusqu’à ce qu’il reçoive le signal indiquant que tout le travail des nuanceurs de calcul est terminé avant de débloquer le moteur. Le vidage partiel ne nécessite qu’un seul paquet, contre deux pour la fence (il est donc moins coûteux en termes d’opérations mémoire). Mais la fence offre plus de flexibilité quant au travail qu’il faut attendre pendant que le moteur est bloqué (puisque l’écriture en mémoire peut avoir lieu après un dispatch particulier, au lieu de tout le travail de calcul).
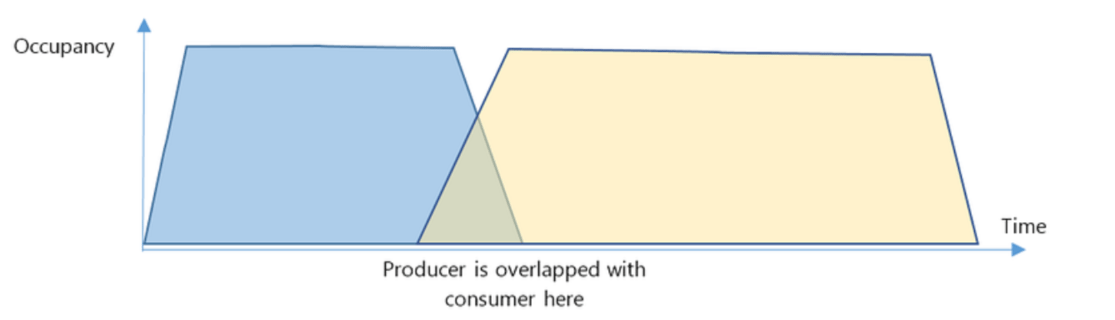
Mécanismes de synchronisation au niveau matériel disponibles sur XBOX Series X|S :
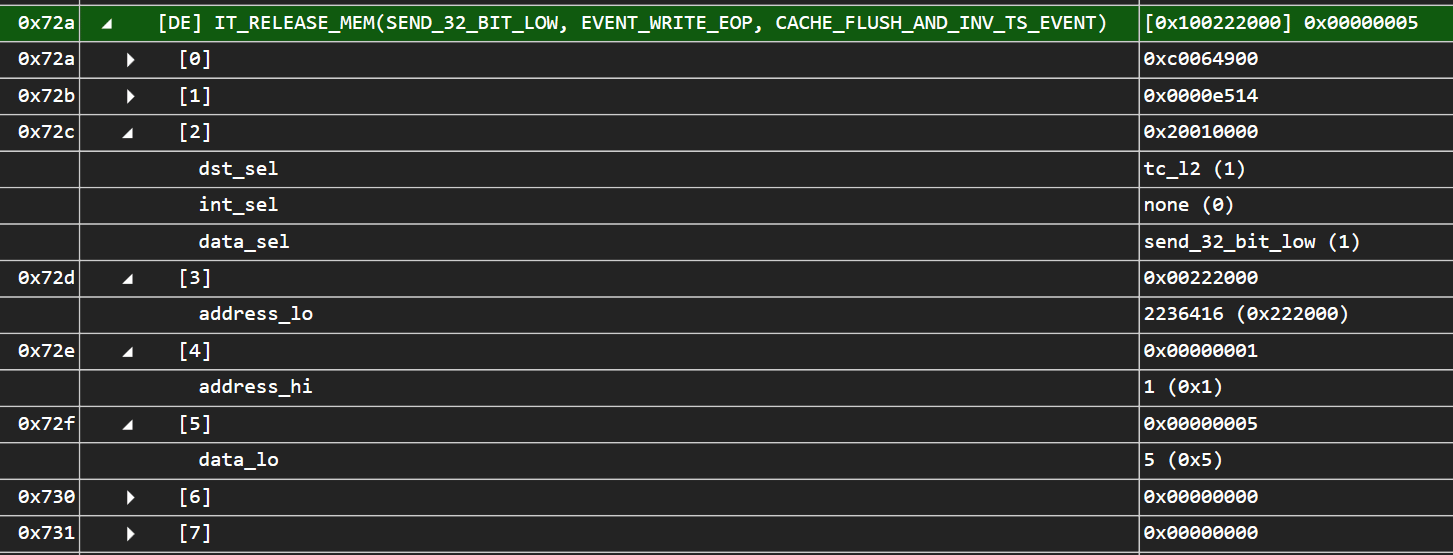
Il est utile de connaître les paquets produits par le pilote lorsque nous utilisons des fences ou des vidages partiels (ou une API de synchronisation comme les barrières), car ils apparaissent dans les captures PIX chaque fois que nous examinons un événement de synchronisation (et des détails supplémentaires sur le masque de bits de chaque paquet peuvent être consultés dans l’onglet de désassemblage des commandes).- ACQUIRE_MEM : ce paquet est utilisé par le pilote pour s’assurer qu’une surface n’est plus utilisée (commandes de dessin actives) et que tous les caches qui lui sont associés sont vidés avant les opérations suivantes. Il est utilisé par le pilote pour les opérations qui nécessitent à la fois le drainage CB et DB (tout le travail CB/DB terminé) ainsi que l’invalidation d’un ou plusieurs des caches suivants ($K, $I, L0, L1, L2, LM, caches CB, caches DB), et/ou la réécriture (writeback) pour L2 (suivez ce lien pour les définitions des caches). Son fonctionnement est le suivant : il attend d’abord que l’adresse mémoire en question ne soit plus référencée par du travail en cours, puis procède au vidage des caches qui lui sont associés. Il peut bloquer le PFP ou le ME (ce paquet s’exécute en haut du pipe).
- RELEASE_MEM : permet d’insérer un événement (End of Pipe ou End of Shader) dans le pipeline. Par exemple, il peut être utilisé pour mettre à jour la valeur d’une fence ou effectuer des opérations mémoire (invalidation/vidage de caches).
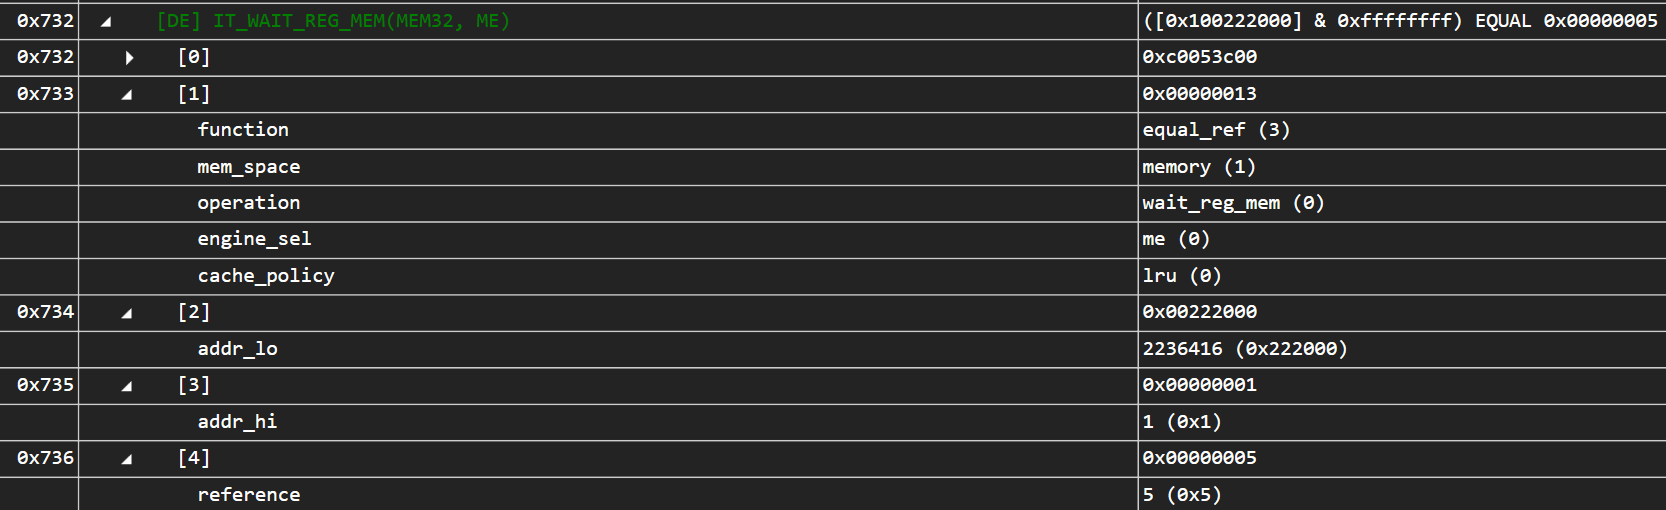
- WAIT_REG_MEM : ce paquet est utilisé pour attendre qu’un emplacement dans l’espace registre ou mémoire satisfasse une fonction de comparaison. Il peut être utilisé pour évaluer des fences. Le paquet permet de définir la fonction de comparaison (par exemple, equal ref vérifie si la valeur en mémoire correspond à la valeur de référence), et la référence est la valeur à laquelle nous voulons comparer. Il définit également le moteur qui attendra (PFP, ME ou CE), un masque définissant les bits à comparer, et l’intervalle d’interrogation (la fréquence à laquelle le moteur vérifie l’espace mémoire/registre, en cycles d’horloge).
- EVENT_WRITE : permet d’insérer des événements dans le pipeline. Les vidages partiels VS, PS et CS sont de type EVENT_WRITE.
- PFP_SYNC_ME : force le PFP à se synchroniser avec le bloc ME. Le PFP transmet le paquet au ME et bloque ensuite les paquets entrants jusqu’à ce qu’il soit libéré par le ME (le ME a terminé le travail et la file FIFO entre le ME et le PFP est vide).
- DMA_DATA : permet au PFP ou au ME de demander au CP DMA de copier vers/depuis des registres ou la mémoire (en un seul paquet atomique). Le moteur qui demande la copie (PFP ou ME) peut éventuellement attendre les résultats. Permet de spécifier si la copie est synchrone ou asynchrone.
Cohérence des caches
Ce qui précède ne raconte qu’une partie de l’histoire, car nous devons encore nous assurer que les accès mémoire sont effectués correctement. Le GPU possède une structure de hiérarchie mémoire bien plus complexe qu’un CPU, étant donné sa charge de travail hautement parallèle. Ses nombreux caches ne sont pas cohérents, et il faut donc en faire davantage en matière de synchronisation. Concepts importants concernant les caches :- Writeback (WB) : opération au cours de laquelle une plage (ou la totalité) des lignes de cache est réécrite dans la mémoire principale (ou dans un cache de niveau supérieur dans la hiérarchie).
- Invalidation : lorsqu’un cache est invalidé, une plage (ou la totalité) de ses lignes de cache est marquée comme non valide, et les lectures ultérieures sont transférées au cache suivant dans la hiérarchie pour récupérer une valeur à jour.
- Write-through : les écritures ont lieu dans le cache et sont également transférées au niveau suivant.
- Dirty bit : si une ligne de cache est marquée comme « dirty », cela signifie que le cache a été modifié et que la mémoire principale (et les autres caches) disposent d’une copie obsolète. Un vidage (WB) sera nécessaire (ainsi que le marquage de ces données comme non valides dans les autres caches afin qu’ils puissent récupérer la valeur à jour).
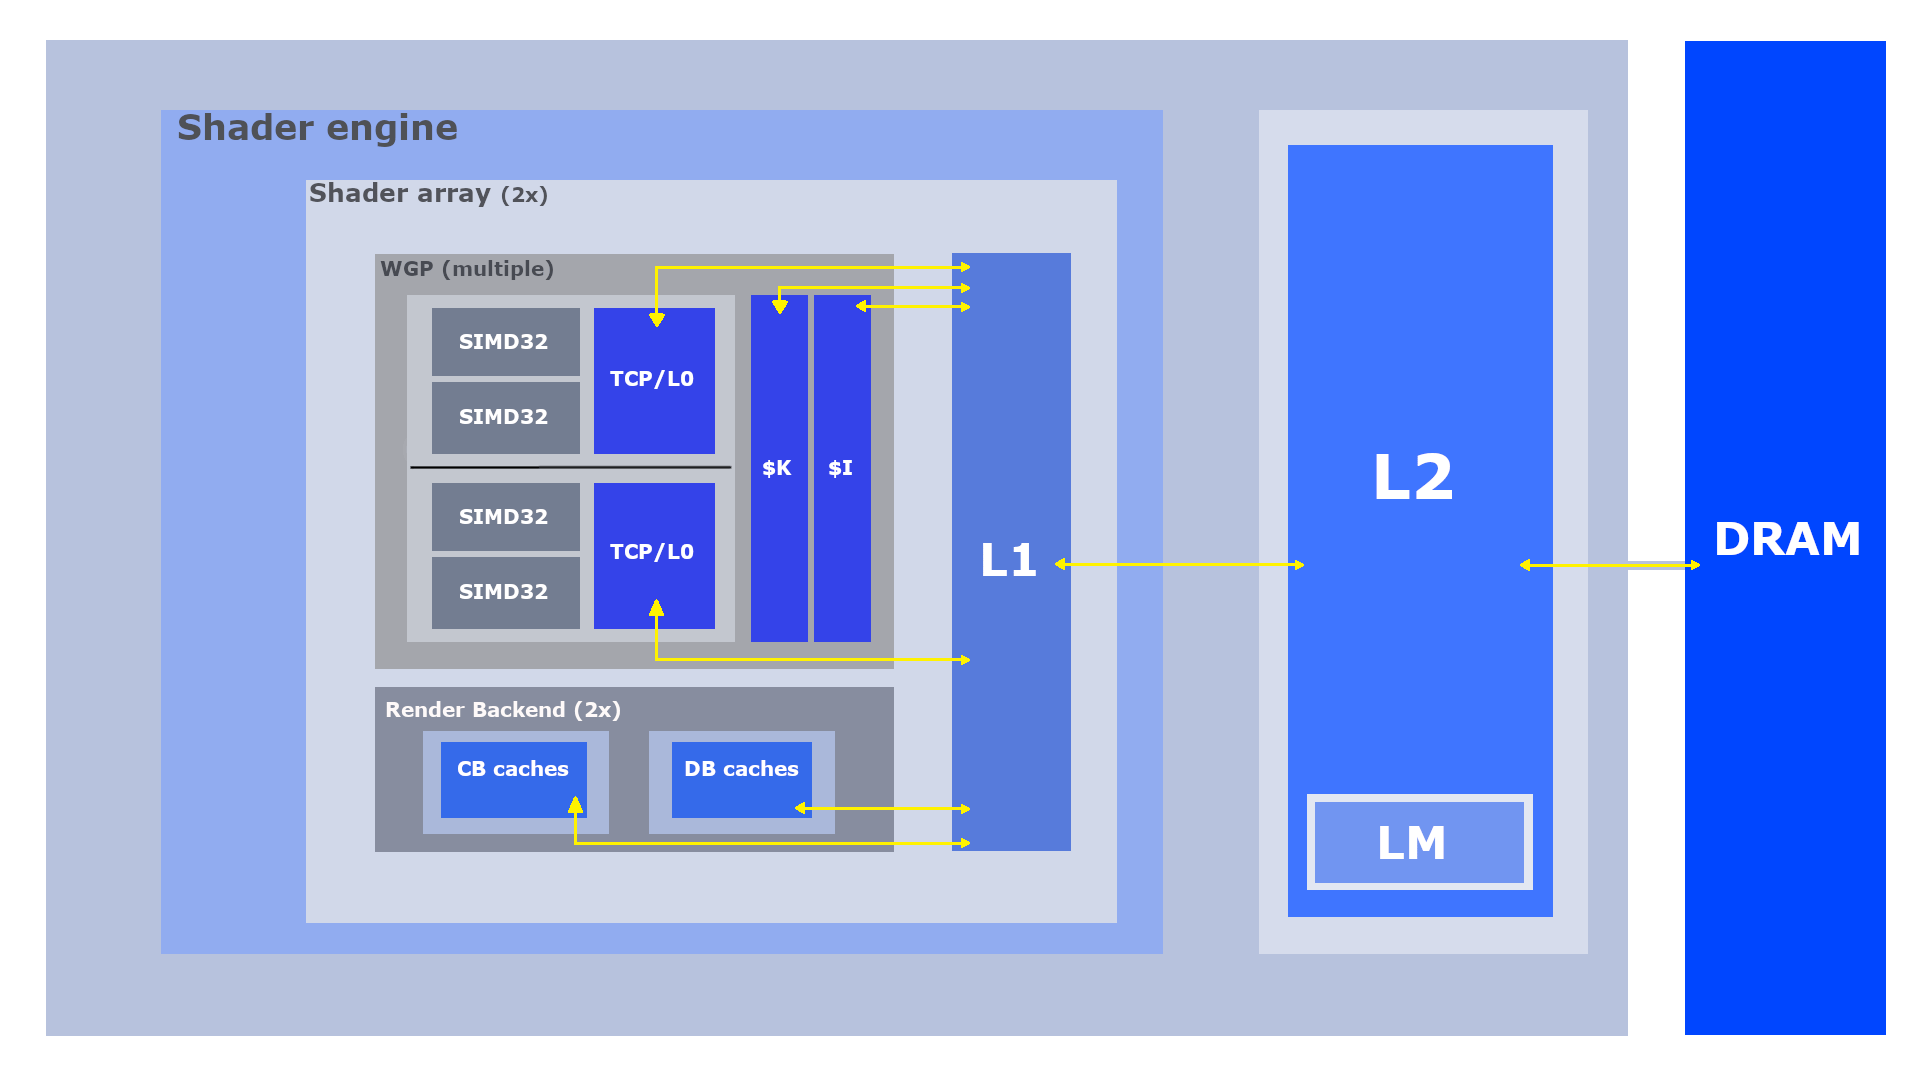
Les caches pertinents sur XBOX Series X|S sont
De plus, les différents caches appliquent des stratégies différentes quant au moment de la réécriture/de l’invalidation :
Pour revenir à l’exemple de la transition d’une écriture CS vers une lecture PS, nous pouvons maintenant examiner les caches. Les écritures UAV utilisent les caches L0-L1-L2 et LM. Les SRV utilisent également les mêmes caches. Comme nous passons d’un état d’écriture à un état de lecture, L0 et L1 seront invalidés. LM sera également invalidé puisque le nuanceur de pixels pourrait potentiellement le lire. (L’invalidation de LM aura lieu uniquement si la ressource possède des métadonnées).