
Data Connections permet l’ingestion continue, en quasi temps réel, des données PlayStream et de télémétrie dans votre ressource de stockage autorisée de votre abonnement Azure. Cette fonctionnalité fonctionne avec Azure Blob Storage, Azure Data Explorer (ADX), les bases de données KQL de Microsoft Fabric et Amazon Web Services S3. Elle vous donne le contrôle de vos données dans votre compte de stockage, avec une latence d’ingestion des données inférieure à cinq minutes. L’architecture est conçue pour le traitement par lots et prend en charge les fichiers Parquet dans Blob Storage, offrant un débit plus élevé, un coût de stockage plus faible et une plus grande flexibilité. En cas d’échec de la distribution des données, un mécanisme intégré de nouvelle tentative automatique aide à garantir que les données sont livrées avec succès. Vous pouvez commencer à utiliser Data Connections pour l’ingestion d’événements au moyen du portail Game Manager de PlayFab ou d’API évolutives.
Bien que vous puissiez utiliser ADX, Blob ou Fabric KQL, ces options ont des cas d’utilisation potentiels différents. Vous pourriez préférer Blob si vous utilisez Synapse pour la modélisation ML et le traitement par lots, tandis qu’ADX prend en charge l’analytique ponctuelle, les requêtes et le débogage en temps réel des services en production.
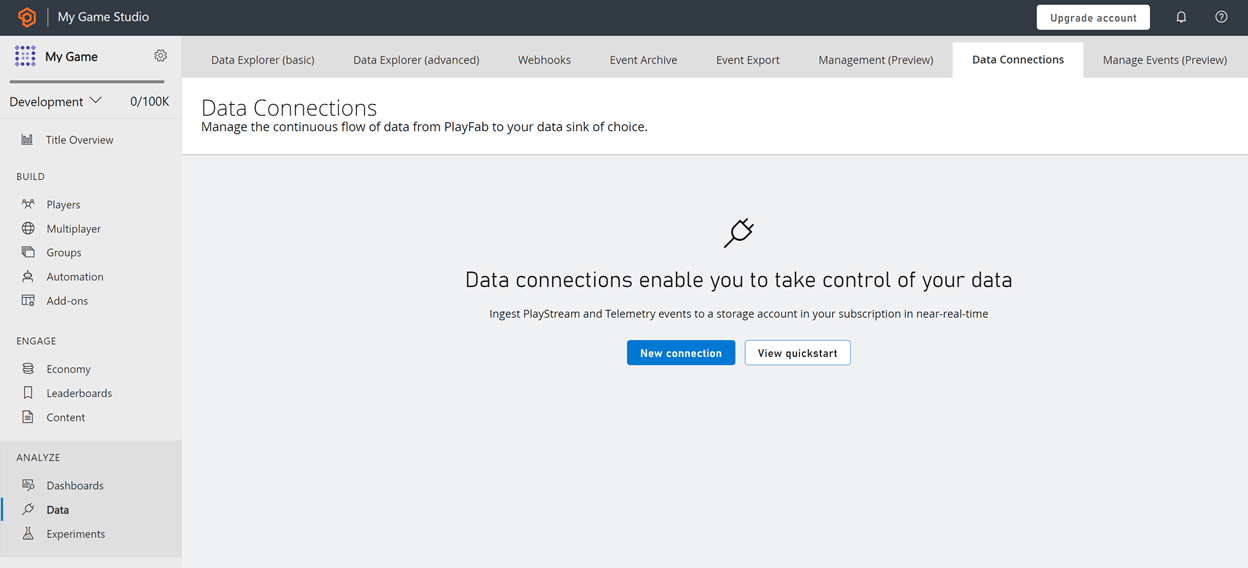
Capture d'écran de la vue d'ensemble de Data Connections

Pourquoi en avez-vous besoin?

Data Connections remplace les fonctionnalités Event Export et Export to S3 actuellement prises en charge par PlayFab. Elle permet une exportation plus rapide dans les formats pris en charge pour le traitement hors ligne. Vous fournissez le compte de stockage dans lequel les données sont ingérées et livrées. Cela signifie que vous contrôlez le chiffrement au repos, la gestion du cycle de vie et l’accès réseau. La facturation est simplifiée, car les coûts de stockage sont inclus de façon centralisée dans la facturation globale de votre compte Azure.

Connexion de données Azure Blob

Les données sont facilement accessibles au format blob Parquet. Parquet est un format de fichier de données orienté colonnes conçu pour un stockage et une récupération efficaces des données. Il offre des schémas efficaces de compression et d’encodage des données, avec des performances améliorées pour traiter des données complexes en masse, ce qui se traduit par une faible latence, un débit plus élevé et un faible coût de stockage des données. Il est conçu pour être un format d’échange commun pour les charges de travail par lots et interactives. Cela fait de Blob Storage un bon choix pour le traitement hors ligne ainsi que pour l’analytique et la création de rapports à coût optimisé (y compris les requêtes ponctuelles sur les fichiers stockés).

Connexion de données Azure Data Explorer

Data Connections vous permet d’exporter vers Azure Data Explorer pour l’ingestion et la distribution de vos données en quasi temps réel. Azure Data Explorer peut interroger des millions d’enregistrements en quelques secondes, ce qui vous permet d’obtenir des informations précieuses et de prendre des décisions éclairées rapidement et efficacement. Pour optimiser davantage les coûts et le contrôle des données, vous pouvez utiliser Data Connections avec l’échantillonnage d’événements. L’échantillonnage vous permet de configurer le pourcentage de données d’événements que vous souhaitez recevoir.

Connexion de données à une base de données KQL Microsoft Fabric

Utilisez les Data Connections de PlayFab pour envoyer des événements de jeu vers des bases de données Real-Time Analytics (RTA), afin de générer des informations en quasi temps réel dans Power BI ou d’exécuter des requêtes KQL dans votre espace de travail Microsoft Fabric.

Connexion de données Amazon AWS S3 (PRÉVERSION)

La connexion de données AWS S3 offre un moyen sécurisé et évolutif de diffuser vos données de télémétrie et d’événements PlayFab directement dans votre propre compartiment Amazon S3. Conçue pour la fiabilité et les charges de travail à débit élevé, elle utilise un pipeline robuste pour valider, transporter et déposer les données de jeu dans un format ouvert, prêt pour l’analytique. En utilisant votre propre stockage AWS et vos propres rôles IAM, vous conservez le contrôle de la gouvernance des données, du chiffrement, des politiques d’accès, de la gestion du cycle de vie et de la visibilité des coûts. Cela permet également des flux de travail en aval comme la création de rapports BI, l’apprentissage automatique et le traitement de données à grande échelle dans votre environnement AWS.
Last modified on October 6, 2026