Introduction
Le Scalable Hardware Audio Processing Engine (SHAPE) fournit une accélération matérielle pour plusieurs des blocs de construction les plus courants de la lecture et de la manipulation audio. Un titre contrôle entièrement la configuration et l’ordonnancement des blocs de traitement SHAPE, qui sont gérés par l’Audio Control Processor (ACP). L’ACP est un composant matériel. Le titre crée des chemins définis pour enchaîner un ou plusieurs composants SHAPE, de l’entrée à la sortie. Ces chemins sont appelés graphes de flux (flowgraphs). Une fois créé, chaque graphe de flux est soumis sous forme d’une série de commandes que l’ACP doit traiter. Cette rubrique présente les pratiques exemplaires pour créer et soumettre des graphes de flux qui mettent en œuvre avec succès les scénarios d’exécution que vous rencontrerez le plus souvent, ainsi que les configurations à éviter pour maximiser les performances. Cette rubrique couvre les éléments suivants :- Composants et capacités de SHAPE
- Scénarios non performants et cas pathologiques
- Planification et révision des graphes de flux SHAPE
- Graphes de flux persistants ou non persistants
- Débogage des problèmes SHAPE
Composants et capacités de SHAPE
Les files d’attente de commandes sont automatiquement gérées et remplies par l’ACP lorsque des graphes de flux sont soumis au matériel. Le tableau suivant présente une liste consolidée des composants et de leurs capacités d’instanciation.
Le tableau suivant présente une liste consolidée des composants et de leurs règles d’acheminement des mémoires tampons de mixage.
| Composant SHAPE| Mémoires tampons de mixage en entrée par instance| Mémoires tampons de mixage en sortie par instance|
| --- | --- | --- | --- | --- | --- | --- | --- | --- |
| XMA| Sans objet. Lit à partir de la mémoire.| Sans objet. Décode vers la mémoire, habituellement consommé par SRC.|
| SRC| 0; lit à partir de la mémoire.| 1 pour mono, 2 pour stéréo.|
| FLT/VOL| 1.| 1.|
| EQ/CMP| 1 (ou 2, pour les configurations de chaîne latérale).| 1.|
| MB| Sans objet. Les mémoires tampons de mixage ne peuvent pas lire directement à partir d’autres mémoires tampons de mixage.| Sans objet. Les mémoires tampons de mixage ne peuvent pas écrire directement dans d’autres mémoires tampons de mixage.|
| DMA| 1; jusqu’à 32 trames audio par transfert.| 1; jusqu’à 32 trames audio par transfert.|
Pour plus de détails sur les blocs de construction de SHAPE, consultez la présentation Xfest connexe The Sound of XBOX One (Conference Material > Xfest 2012) et le livre blanc The Sound of the Future (Developer Education Materials > All NDA Whitepapers).
Remarque sur les scénarios d’utilisation des graphes de flux
De nombreux titres pourraient ne jamais mettre en œuvre directement des graphes de flux. XAudio2 met en œuvre implicitement les composants SHAPE, et les intergiciels audio peuvent masquer les graphes de flux matériels aux développeurs de titres. Cependant, la construction de graphes de flux vous permet de tirer directement parti des capacités d’accélération audio de la console XBOX One, en particulier si vous développez et mettez en œuvre votre propre solution de rendu audio ou si vous avez une configuration personnalisée qui n’est pas prise en charge par XAudio2 ou par un intergiciel. Pour tous les titres que vous développez, il vous sera utile de comprendre les capacités de SHAPE, qui sont abordées plus loin dans cette rubrique, et de planifier à l’avance les topologies potentielles des graphes de flux.Scénarios non performants et cas pathologiques
Les sections suivantes décrivent des scénarios courants qui peuvent entraîner des problèmes de performances. Elles fournissent également des recommandations pour éviter ces problèmes.Graphes de flux mal formés
Vous pourriez créer des graphes de flux qui construisent des flux de signal impossibles ou des données qui ne parviennent jamais à la sortie. Voici quelques-unes des erreurs les plus courantes lors de la création de graphes de flux.- Références à des objets SHAPE qui ne sont pas créés ou alloués
- Commandes ou paramètres non valides
- Exactitude du comptage des références d’entrée/sortie des mémoires tampons de mixage
- Réallocation d’un ID virtuel de mémoire tampon de mixage existant
- Omission de mémoires tampons de mixage de connexion entre les composants SHAPE
- Utilisation de plus d’une seule mémoire tampon de mixage comme sortie d’un composant SHAPE, à l’exception du bloc SRC, qui peut acheminer vers deux mémoires tampons de mixage lors du rendu de contenu stéréo
- Références circulaires dans les mémoires tampons de mixage Une mémoire tampon de mixage ne devient disponible que lorsque toutes ses entrées sont présentées et que ses sorties sont consommées. Si une référence circulaire se trouve dans une mémoire tampon de mixage, celle-ci a en fait une infinité d’entrées, ne devient jamais disponible et bloque le graphe.
- Mémoires tampons de mixage orphelines Une mémoire tampon de mixage sans sorties devient disponible immédiatement lorsque sa dernière entrée est traitée. Une mémoire tampon de mixage destinée au rendu vers un appareil audio (par exemple, des haut-parleurs ou un casque d’écoute) doit se terminer par un bloc de sortie DMA. Cela présentera la mémoire tampon de mixage à la mémoire principale pour le mixage final.
Ordonnancement des commandes
L’ACP remplit automatiquement les files d’attente de commandes de chaque composant SHAPE. Lors du remplissage des files d’attente, l’ACP ignore les commandes suivantes d’un composant donné jusqu’à ce que les entrées de ce composant soient libres. En général, le fait d’ignorer des commandes représente une pénalité de performances négligeable. Toutefois, selon l’ordonnancement des commandes, les titres pourraient créer un ordonnancement sous-optimal des composants SHAPE. Cela amènerait une ou plusieurs des files d’attente non pleines à attendre d’autres files d’attente. Cette attente réduit le nombre d’instances disponibles par trame. La figure 1 montre comment l’ordonnancement des commandes peut affecter les performances. À titre de pratique exemplaire, émettez les commandes FLT/VOL de haut en bas, comme le montre le graphe de flux, plutôt que de gauche à droite, ce qui permet de terminer davantage de voix. Cette méthode permet à un EQ/CMP, illustré au bas du graphe de flux, d’être traité en parallèle. Figure 1. Graphe de flux qui montre comment émettre les commandes FLT/VOL de haut en bas, plutôt que de gauche à droite, pour permettre à un EQ/CMP d’être traité en parallèle et améliorer les performances.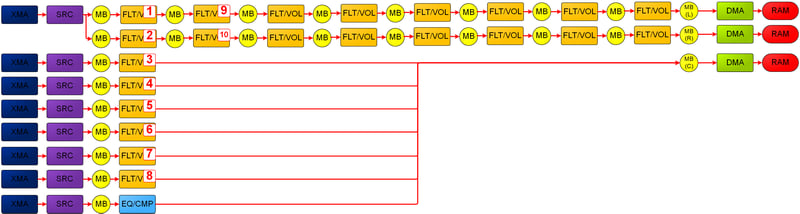
Allocation des instances de mémoires tampons de mixage
Les mémoires tampons de mixage sont verrouillées pendant qu’on y écrit. Aucune sortie ne peut y être lue tant que toutes les entrées n’ont pas contribué au mixage. Du point de vue de la mise en œuvre, les mémoires tampons de mixage utilisent les champsnumIn et numOut pour gérer cela. Par conséquent, il est possible de construire des scénarios qui nécessitent plus de 128 mémoires tampons de mixage physiques en même temps.
SHAPE virtualise les mémoires tampons de mixage de sorte que, même avec une polyphonie élevée, ce scénario ne cause habituellement pas de problème. Cependant, vous pouvez construire des graphes de flux qui exigent l’accès simultané à un grand nombre de mémoires tampons de mixage. En particulier, les mémoires tampons de mixage qui effectuent un sous-mixage ou un matriçage parmi plusieurs voix sont verrouillées jusqu’à ce que la dernière voix y soit mixée et jusqu’à ce que la dernière sortie des mémoires tampons de mixage soit consommée par un bloc SHAPE subséquent.
Dans un scénario habituel (une seule voix de matriçage 7.1 dans laquelle toutes les voix SHAPE sont mixées), 8 des 128 voix sont verrouillées tout au long de la trame. Des mémoires tampons de mixage supplémentaires pourraient être verrouillées pendant une partie importante de la trame (réduisant la capacité des mémoires tampons de mixage virtuelles) s’il y a un sous-mixage multicanal étendu avec des chaînes de dépendances de graphes de flux. Par ailleurs, des voix de matriçage supplémentaires sont créées si, par exemple, vous deviez créer à la fois un mixage pour les haut-parleurs principaux et un mixage 7.1 pour casque d’écoute par joueur dans un titre à quatre joueurs, ce qui pourrait consommer 40 mémoires tampons de mixage simultanées.
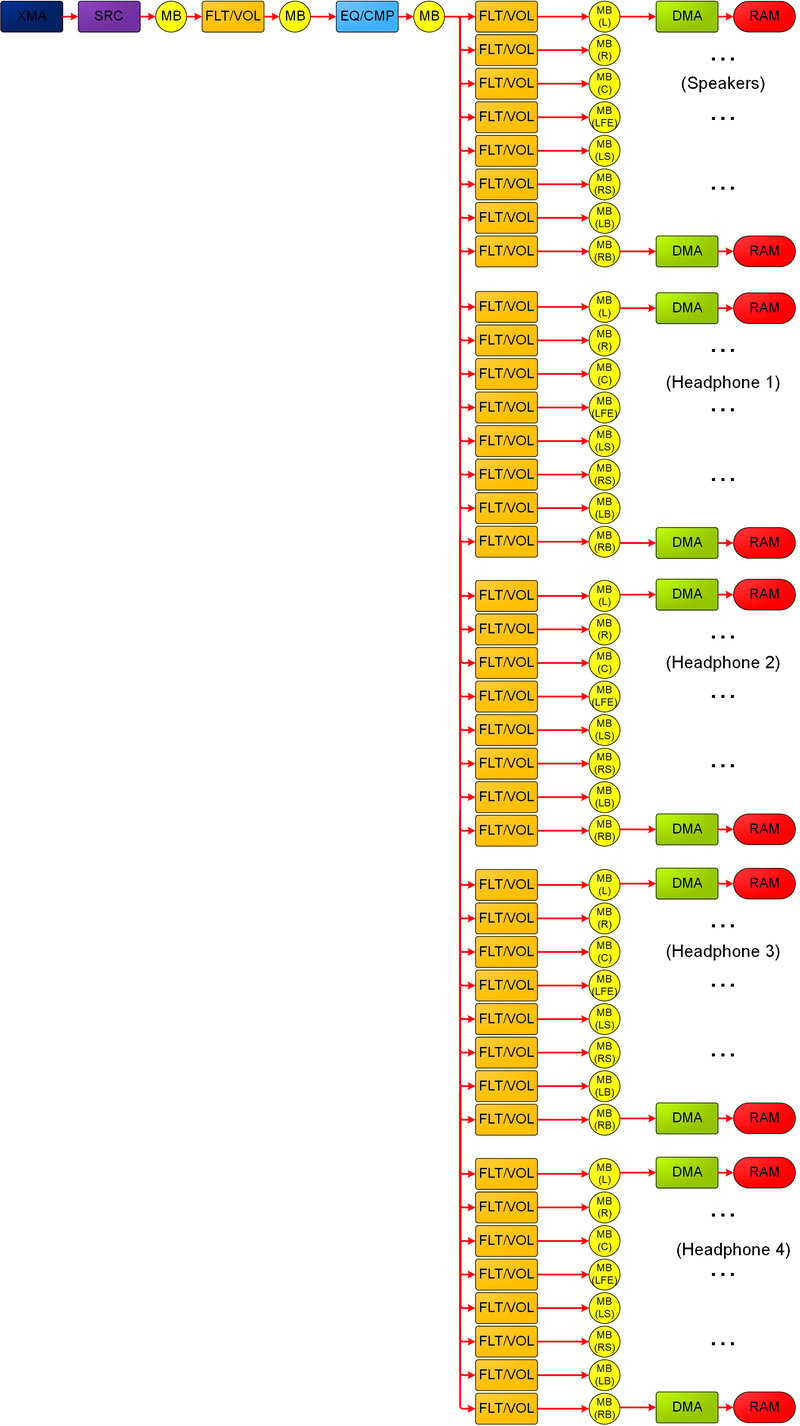
En général, un cas qui nécessite plus de 128 mémoires tampons de mixage physiques simultanées est pathologique. Cependant, les mémoires tampons de mixage verrouillées inutilement pendant toute la trame réduisent la capacité de votre titre à atteindre le débit potentiel. La figure 2 représente un sous-mixage inutile qui pourrait réduire le nombre de mémoires tampons de mixage disponibles à un moment donné.
Selon l’ordonnancement des commandes (figure 2), les 5 mémoires tampons de mixage de matriçage 7.1 distinctes pourraient être verrouillées pendant presque toute la trame, ce qui représente 40 des 128 mémoires tampons de mixage physiques. Bien que ce chemin n’exige que 2 autres mémoires tampons de mixage en cours d’utilisation à la fois (c’est-à-dire l’entrée et la sortie appariées d’un FLT/VOL ou d’un EQ/CMP), envisagez de traiter d’abord toutes les mémoires tampons de mixage destinées aux haut-parleurs. Vous pourrez ensuite libérer ces mémoires tampons de mixage et traiter les casques d’écoute 1, 2 et suivants.
Figure 2. Graphe de flux qui montre un sous-mixage inutile et le verrouillage d’instances de mémoires tampons de mixage allouées en raison d’un mauvais ordonnancement des commandes.
Sélection et équilibrage des composants SHAPE (FLT/VOL ou EQ/CMP)
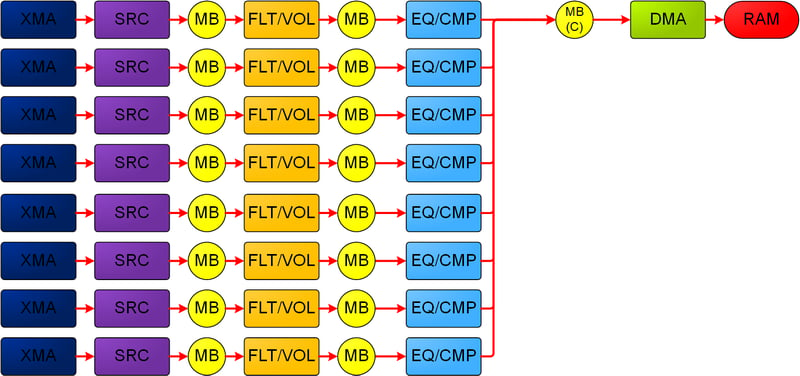
Si vous utilisez les mêmes composants SHAPE à répétition en séquence, vous pouvez réduire la capacité d’atteindre le débit maximal. En revanche, en alternant différents composants, vous vous assurez que chaque bloc SHAPE effectue un traitement parallèle utile. La figure 3 montre un exemple courant : les FLT/VOL ne peuvent pas tous être traités en parallèle. Les performances pourraient en souffrir. Figure 3. Graphe de flux qui montre une tentative de traitement de tous les FLT/VOL en parallèle.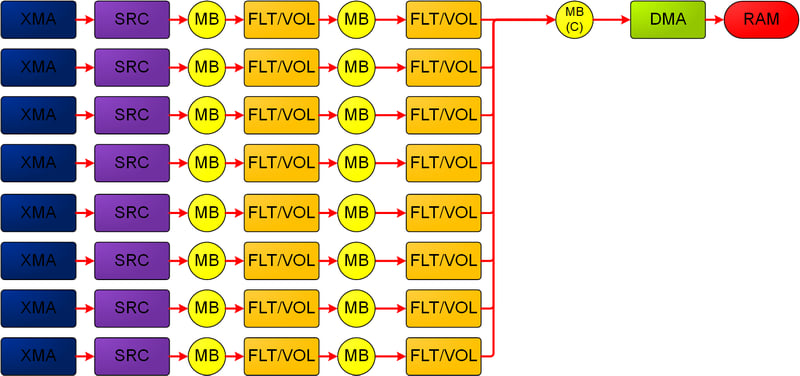
Allers-retours DMA trop nombreux, trop fréquents ou de faible valeur
Le DMA est limité par la bande passante de lecture/écriture disponible sur le bus de SHAPE. Si vous consommez toute la bande passante disponible (bien que ce scénario soit habituellement pathologique), les blocs DMA se bloqueront et réduiront le débit. Comme mentionné précédemment, tout le traitement qui survient après un bloc d’entrée DMA devra attendre que le DMA soit terminé. Par conséquent, vous pouvez créer des graphes de flux dont une grande partie est bloquée et attend qu’un DMA soit terminé avant que le graphe de flux puisse commencer le traitement. Vous devriez également évaluer les allers-retours DMA en fonction de la valeur qu’ils apportent au flux audio. L’ajout minime de latence (que vous pouvez contrôler en fonction du nombre de trames accédées par DMA, en multiples de la taille de 2,667 ms de la trame audio) pourrait ne pas être une préoccupation pour la plupart des scénarios de lecture audio. En effet, les blocs à droite d’un DMA traiteront des données audio provenant des trames précédentes. En particulier, renvoyer un DMA dans SHAPE uniquement pour effectuer un mixage final pourrait être inutile si vous prévoyez également renvoyer ce mixage final par DMA vers la mémoire pour le présenter à un point de terminaison audio. La figure 5 montre un exemple de valeur potentiellement faible, où une voix envoyée par DMA vers la mémoire pour un traitement par le CPU/GPU est ramenée dans SHAPE, uniquement pour être panoramisée en 7.1 dans le mixage de matriçage. La voix est ensuite renvoyée par DMA vers la mémoire. La figure 5 suppose qu’aucun filtrage n’est appliqué aux voix dans les blocs FLT/VOL et que d’autres voix sont acheminées vers les mémoires tampons de mixage de matriçage 7.1. Figure 5. Graphe de flux qui montre un acheminement potentiellement de faible valeur, comportant des composants FLT/VOL inutiles et des allers-retours DMA inutiles.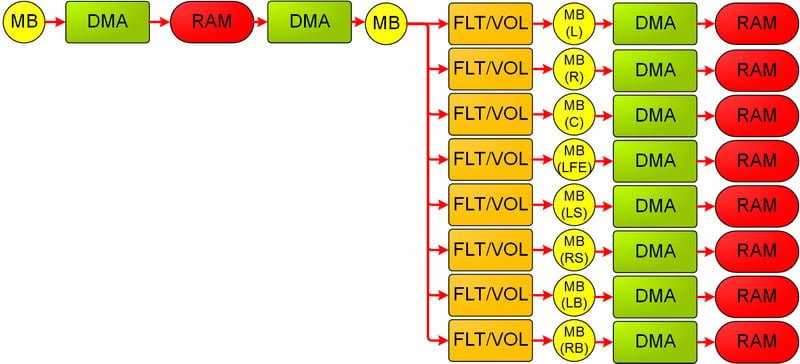
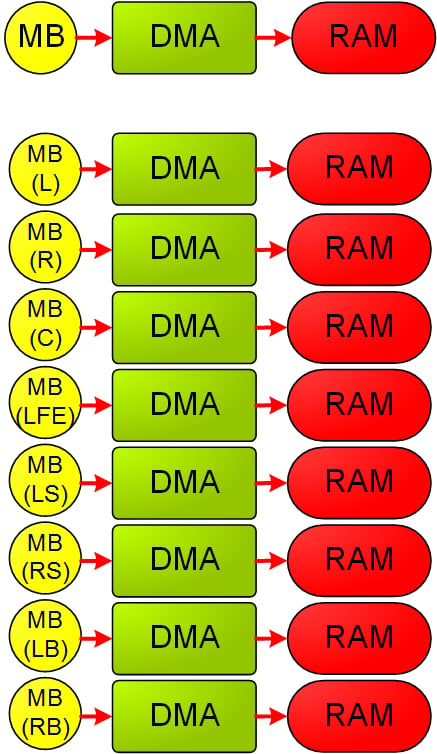
- Avez l’intention d’effectuer une quantité importante de traitement SHAPE supplémentaire pour une voix donnée.
- Voulez tirer parti de la mesure matérielle des niveaux et de la détection d’écrêtage offertes par les mémoires tampons de mixage.
Planification et révision des graphes de flux SHAPE
À titre d’exercice, avant la mise en œuvre, créez une représentation visuelle d’un graphe de flux de l’utilisation des voix que vous prévoyez dans une trame, avec les voix catégorisées et quantifiées, par exemple, en fonction du nombre d’effets sonores et de flux musicaux simultanés. Saisir ces informations visuellement peut vous aider à comprendre comment éviter certains des pièges de performances abordés précédemment. Voici quelques-unes des principales mesures que vous pouvez tirer d’un tel graphe de flux.-
Le nombre maximal de chaque composant SHAPE, simultanément et dans l’ensemble de la trame :
- Vérifiez que ce graphe de flux se situe suffisamment sous les pics théoriques.
- Notez la sous-utilisation et la surutilisation des composants. Rééquilibrez les composants au besoin.
- Envisagez de restructurer l’utilisation des mémoires tampons de mixage si un trop grand nombre d’entre elles doivent rester verrouillées pendant la majeure partie du graphe de flux.
-
Planification de la mise en œuvre du positionnement 3D au moyen de SHAPE :
- Toutes les voix seront-elles panoramisées en 7.1, ou les voix seront-elles panoramisées entre les 2 ou n haut-parleurs les plus proches?
- Tout le panoramique 7.1 doit-il être effectué dans SHAPE, ou les voix qui ont déjà été envoyées par DMA au CPU sont-elles mieux panoramisées sur le CPU lui-même?
- Le nombre de transitions DMA vers la mémoire et à partir de celle-ci, et si ces transitions sont asymétriques. Par exemple, certaines voix sont écrites vers SHAPE et à partir de SHAPE plus de fois que d’autres, ce qui signifie qu’elles auront probablement une latence supplémentaire.
Graphes de flux persistants ou non persistants
Vous pouvez soumettre des graphes de flux à traiter comme persistants ou non persistants. Les graphes de flux persistants effectuent leur traitement, puis restent résidents pour répéter leur traitement à la trame suivante, une fois que les pointeurs de lecture et d’écriture ont avancé et que les autres informations de contexte ont été mises à jour. Utilisez des graphes de flux persistants pour l’un ou l’autre des scénarios suivants.- Graphes de flux très complexes : les graphes de flux qui nécessitent une quantité importante de traitement CPU pour être réassemblés à chaque trame
- Graphes de flux très statiques : les graphes de flux qui conservent le même nombre et la même configuration de voix pendant une période prolongée
- Les topologies de voix changent souvent.
- La cadence de traitement du moteur logiciel audio de votre titre est dissociée du matériel SHAPE, c’est-à-dire qu’elle n’est pas un multiple de 2,667 ms.
- Vous voulez exécuter le traitement audio dans des scénarios plus rapides que le temps réel, c’est-à-dire lorsque vous soumettez des graphes destinés à être consommés dès qu’ils deviennent disponibles.
Débogage des problèmes SHAPE
Lorsque vous développez des graphes de flux, nous vous recommandons de vous inscrire aux messages qui vous aideraient à déboguer les problèmes. Plus précisément, utilisez le paramètreNumMessages de la méthode IAcpHal::Connect.
Le système de messagerie fournit une rétroaction riche sur divers problèmes, notamment les graphes de flux non valides (comme ACP_FLOWGRAPH_TERMINATED_REASON_INVALID_GRAPH), les commandes bloquées et les dépassements de trame causés par des tentatives d’effectuer plus de traitement que ne le permet la taille de 2,667 ms de la trame matérielle.
Cette méthode est utile pour le débogage. Toutefois, avant la sortie de votre titre, essayez de faire ce qui suit :
- Éliminez tous les messages indiquant des erreurs des scénarios d’exécution.
- Vérifiez que le traitement des graphes de flux réussit de façon constante en examinant les messages
ACP_MESSAGE_TYPE_FLOWGRAPH_COMPLETED(voir l’énumération ACP_MESSAGE_TYPE) pour chaque graphe de flux soumis.
Messages manqués
Si vous utilisez les messages ACP pour piloter l’état du moteur et que vous traitez un grand nombre de messages, vous devriez examinerACP_MESSAGE::droppedMessageCount pendant le développement. Une valeur non nulle indique que la file d’attente des messages était pleine et que des messages ont dû être abandonnés. Si cette valeur se produit, envisagez de traiter la file d’attente plus rapidement et de l’agrandir.
Dépassements de trame
Pendant le développement, en raison d’un dépassement du budget, de graphes de flux sous-optimaux et d’autres raisons, un graphe de flux pourrait ne pas être terminé avant la fin d’une trame audio (2,667 ms). Ce graphe de flux incomplet entraînera un messageACP_FLOWGRAPH_TERMINATED_TIME_EXCEEDED pour les graphes de flux persistants. Ceux-ci seront incomplets. En revanche, un graphe de flux non persistant n’est pas soumis à cette contrainte et s’exécutera jusqu’à ce qu’il soit terminé, même sur plusieurs trames.
Commandes bloquées
Les commandes SRC et DMA peuvent être signalées comme bloquées (ACP_MESSAGE_TYPE_SRC_BLOCKED et ACP_MESSAGE_TYPE_DMA_BLOCKED (voir l’énumération ACP_MESSAGE_TYPE)) dans plusieurs scénarios, comme le montre le tableau suivant.
Une fois qu’il est déterminé que des commandes sont bloquées (ce qui peut survenir à la fois avant que des éléments soient ajoutés à une file d’attente SHAPE pour traitement et pendant l’exécution), les commandes sont évincées du graphe. Cela pourrait entraîner une perte audio. Pendant le développement, examinez d’abord les commandes bloquées pour trouver des améliorations dans la gestion des graphes de flux. Avant la sortie, votre titre devrait également empêcher le blocage des commandes.
Vous pouvez empêcher le blocage des commandes DMA en vous assurant que votre mémoire tampon audio est suffisamment grande et que les données sont diffusées à intervalles réguliers par rapport à la taille de la mémoire tampon. Par exemple, si vous diffusez quatre trames matérielles à la fois, assurez-vous qu’un multiple de ces trames (au moins une double mise en mémoire tampon, soit huit) se trouve dans la mémoire tampon pour permettre au matériel d’écrire en avance sur le pointeur de lecture du titre. Vous pourriez également imposer le vidage de la mémoire tampon avant de soumettre le graphe de flux suivant en consommant les données, en mettant à jour le pointeur de lecture DMA, puis en soumettant le graphe de flux.
Les commandes SRC ont les trois modes suivants (détaillés dans ShapeSrcContext.h).
-
SHAPE_SRC_COMMAND_TYPE_STARTUtilisez-le pour presque toutes les commandes SRC d’un graphe de flux. Effectuez le traitement normalement, et attendez-vous à ce que d’autres données audio suivent le graphe de flux actuel. -
SHAPE_SRC_COMMAND_TYPE_STOP_IMMEDIATEUtilisez-le pour arrêter immédiatement le traitement des données XMA ou PCM sources. Le SRC produira une mémoire tampon remplie de zéros pour cette trame. -
SHAPE_SRC_COMMAND_TYPE_STOP_ENDUtilisez-le pour indiquer le dernier paquet d’une voix. S’il n’est pas soumis avecSTOP_ENDouSTOP_IMMEDIATE, la commande SRC ne sera pas terminée. Cela provoquera le blocage du graphe de flux actif. Un graphe de flux persistant se terminera à la fin de la trame audio, et un graphe de flux non persistant ne sera jamais terminé.