Pular para o conteúdo principal

Visão geral

As Instruction Trace Captures ajudam você a otimizar o uso que o seu título faz dos caches de memória e de instruções do console. O PIX registra dados sobre cada instrução da CPU executada enquanto a captura estava em execução. Todas as instruções de carregamento e armazenamento de memória são então analisadas usando uma simulação de cache. Os resultados da simulação são usados para:
  • Identificar quais funções causaram mais falhas de cache e carregaram mais dados nos caches. As linhas de código-fonte C++ específicas e as instruções de assembly que resultaram em uma falha de cache também são identificadas.
  • Ver estatísticas sobre os acertos e as falhas de cache de cada núcleo da CPU e módulo.
  • Visualizar a eficiência com que cada linha de cache está sendo usada. As Instruction Trace Captures mostram quais bytes de uma linha de cache foram acessados, junto com o código que acessou cada byte. Também são fornecidas informações de estruturas de dados para ajudar a otimizar seus layouts de dados e fazer o melhor uso dos caches de memória.
Além dos recursos de análise de cache de memória, as Instruction Trace Captures também ajudam você a identificar possíveis ineficiências ou defeitos relacionados à leitura de memória de combinação de gravação ou ao acesso à pilha de outra thread.

Fazer uma captura

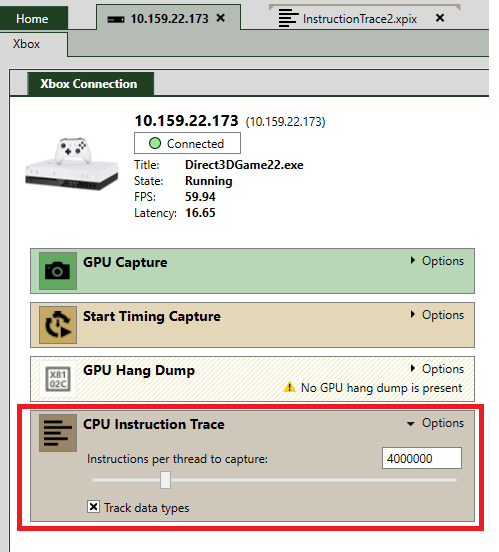
Os rastreamentos de instruções registram dados de um número especificado de instruções da CPU a partir do momento em que a captura foi iniciada. O número de instruções a capturar é especificado usando o campo Instructions per thread to capture no painel CPU Instruction Trace Options antes de iniciar uma captura. Observe que o número de instruções que você especificar será capturado para cada thread em execução no processo do título. O PIX também pode, opcionalmente, registrar informações sobre os tipos de dados acessados por cada linha de código-fonte e instrução de assembly. Marque a caixa de seleção Track Data Types para adicionar informações de tipos de dados à captura. Depois de especificar um número de instruções e a opção de rastreamento de tipos, selecione o botão Capture para iniciar a captura. CPU Instruction Trace
Layouts do Instruction Trace

  • Summary. Fornece um resumo de como o título está interagindo com os caches de dados e de instruções do console.
  • Instruction Table. Exibe as instruções da CPU que foram executadas para uma determinada função. Também são fornecidas informações sobre os tipos de dados acessados e quais instruções de assembly causaram falhas de cache de dados.
  • Source. Exibe o código-fonte C++ de uma determinada função. Também são fornecidas informações sobre os tipos de dados acessados e quais linhas de código-fonte causaram falhas de cache de dados.
  • Callgraph. Exibe o gráfico de chamadas de todas as funções executadas durante a captura. A exibição pode ser usada para examinar várias estatísticas sobre cada chamada, incluindo o número de falhas de cache, um detalhamento por tipo de instrução e assim por diante. Também é fornecida uma exibição butterfly de funções para navegar pelos chamadores e chamados de uma função especificada.
  • Memory Regions. Fornece detalhes sobre os padrões de acesso à memória para um conjunto de intervalos de endereços.
  • Memory Region Details. Fornece um nível adicional de análise de linhas de cache, exibindo as linhas de código-fonte C++ e as instruções de assembly que estão acessando a memória na região selecionada no momento.

Capture Summary

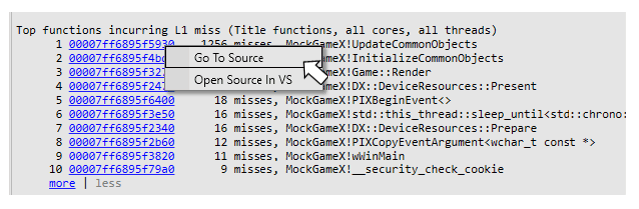
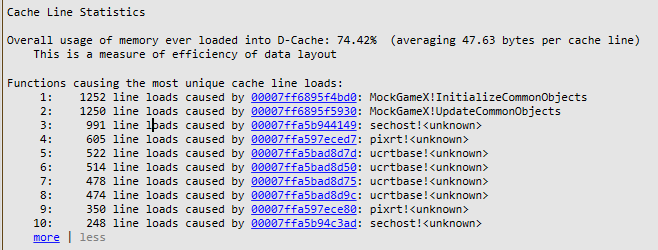
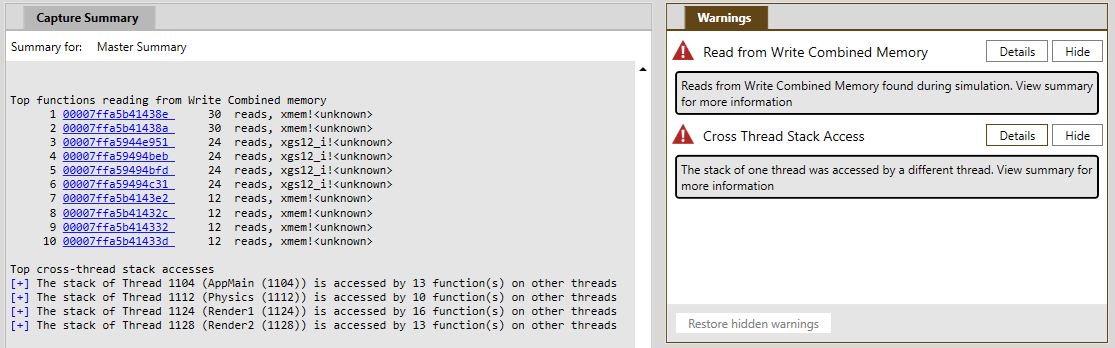
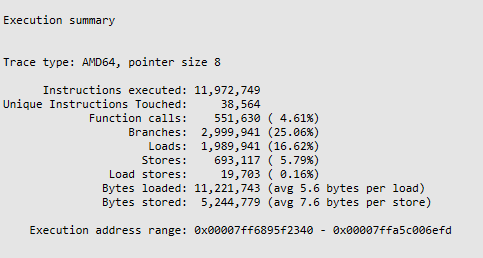
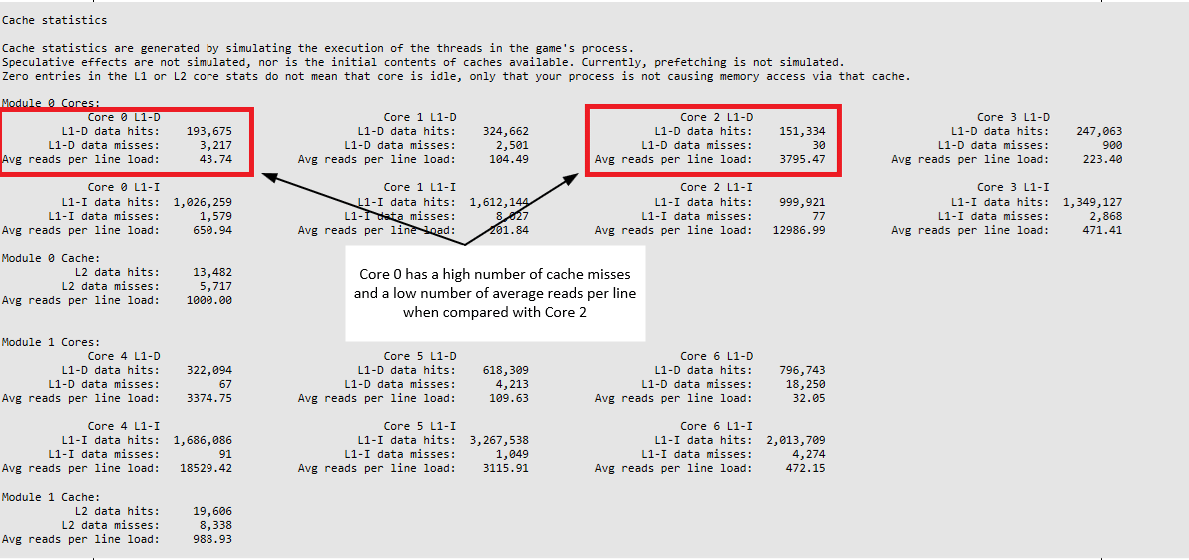
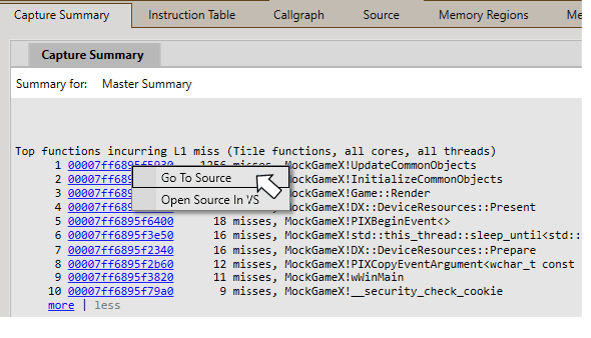
As Instruction Trace Captures abrem em um layout de resumo que fornece uma análise de como o título está interagindo com os caches de memória e de instruções do sistema. Também são fornecidos avisos, como leituras de memória de combinação de gravação. A seção Execution Summary da página de resumo exibe algumas estatísticas básicas sobre a captura, incluindo um detalhamento das instruções por tipo e a quantidade de dados carregados e armazenados. Resumo e estatísticas básicas da captura A seção Cache Statistics da página de resumo exibe estatísticas sobre os caches de dados e de instruções do console. São fornecidos o número de acertos de cache, de falhas de cache e o número médio de vezes que cada linha de cache foi lida. Esses números podem ser usados para ter uma noção geral de como o código executado em um núcleo se comporta em relação à eficiência de cache, em comparação com o código executado em outro núcleo. Por exemplo, na imagem a seguir, a taxa de falhas de dados do L1-D é relativamente alta no Core 0 em comparação com o Core 2 (3.127 vs. 30). Os dados de estatísticas de cache também mostram que o número de vezes que uma linha de cache foi lida depois de ser carregada no cache é relativamente baixo para o Core 0 em comparação com o Core 2 (~43 vs. ~3795). Um número alto de falhas de dados, combinado com um número baixo de leituras médias de linhas de cache, pode indicar uso ineficiente do cache. Comparação das estatísticas de cache entre núcleos A análise de resumo do rastreamento de instruções inclui uma lista das principais funções que causaram falhas de L1 e L2. As falhas de L3 também são fornecidas quando a captura é feita em um XBOX Series X Dev Kit ou XBOX Series S Test Kit. Clicar no hiperlink ao lado de uma função na lista navega até o layout Instruction Table, que mostra o conjunto de instruções de assembly executadas quando essa função foi executada, junto com anotações que descrevem quais instruções causaram falhas de cache. Clicar com o botão direito do mouse no hiperlink ao lado de uma função abre um menu de contexto que pode ser usado para ver o código-fonte da função usando o layout Source ou abrindo o arquivo de origem no Visual Studio. Análise de linhas de cache A seção Cache Line Statistics da exibição Summary inclui uma análise do uso de cada linha de cache, tanto em bytes quanto em porcentagem. Quanto maiores esses números, mais eficiente é o layout das suas estruturas de dados, resultando em um uso mais eficiente das linhas de cache. O exemplo a seguir mostra que ~74% dos dados carregados nos caches de dados foram acessados (~47 bytes de cada linha de cache de 64 bytes). A seção de estatísticas de linhas de cache da página de resumo do rastreamento de instruções Também é fornecida uma lista das funções que fizeram mais linhas de cache serem carregadas, junto com o conjunto de funções que leram e gravaram mais linhas de cache. Além de uma análise do uso das linhas de cache, a exibição Summary também fornece informações sobre outros possíveis problemas de desempenho e confiabilidade. Esses problemas incluem o uso de memória de combinação de gravação e casos em que uma thread acessou a pilha de outra thread. A exibição Warnings no canto superior direito do layout padrão indica quando esses problemas ocorreram. A exibição Capture Summary fornece mais detalhes, incluindo as pilhas de chamadas de quando esses problemas ocorreram. Leituras de memória de combinação de gravação e acessos à pilha entre threads
Instruction Table

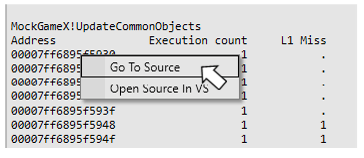
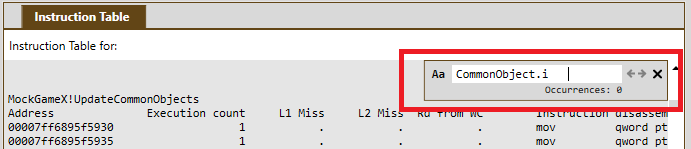
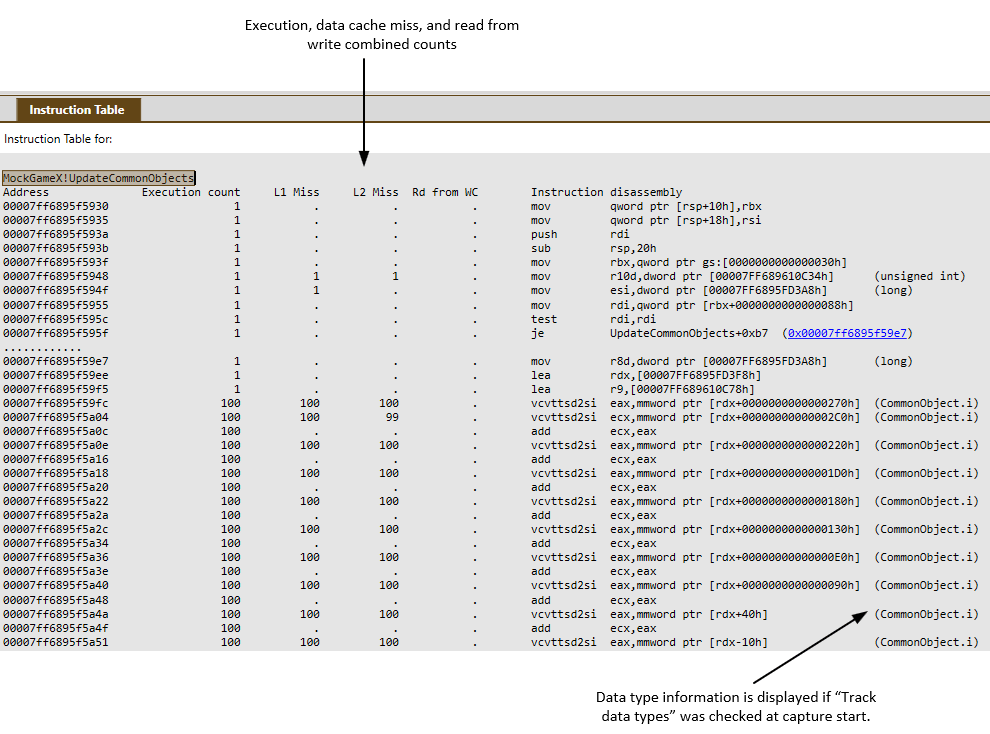
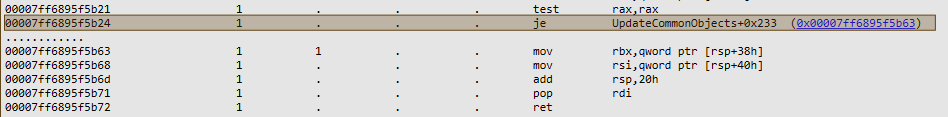
O layout Instruction Table é usado para examinar o conjunto de instruções da CPU que foram executadas para uma determinada função. São fornecidas contagens de execução e de falhas de cache para cada instrução executada. Os tipos de dados acessados por cada instrução também são mostrados se a opção Track Data Types tiver sido selecionada antes de iniciar a captura. Com frequência, chega-se ao layout Instruction Table clicando em um hiperlink ao lado de uma função no layout Summary. Exibição Instruction Table O conjunto de instruções exibido na Instruction Table é composto pelas instruções que foram executadas quando a função foi executada, e não por todas as instruções da função. Especificamente, as instruções de ramificações que não foram seguidas não são mostradas. Os grupos de instruções que não foram executados são exibidos como uma linha de pontos na coluna de endereço. Por exemplo, a instrução je na figura a seguir resultou em um salto que ignorou algumas instruções, conforme indicado pela linha de pontos após o salto. Uma ramificação seguida, conforme exibida na Instruction Table Clicar com o botão direito do mouse na coluna de endereço exibe um menu de contexto que pode ser usado para navegar até o layout Source ou abrir o arquivo de origem no Visual Studio. O menu de contexto na Instruction Table A sequência de teclas Ctrl+F pode ser usada para abrir uma caixa de pesquisa. A caixa de pesquisa na Instruction Table O texto pode ser copiado da Instruction Table e colado em outra ferramenta para dar suporte a cenários de análise adicionais. Depois de selecionar o texto a ser copiado, use Ctrl+C para copiá-lo para a área de transferência. Ctrl+A pode ser usado para selecionar todo o texto na Instruction Table.
Source

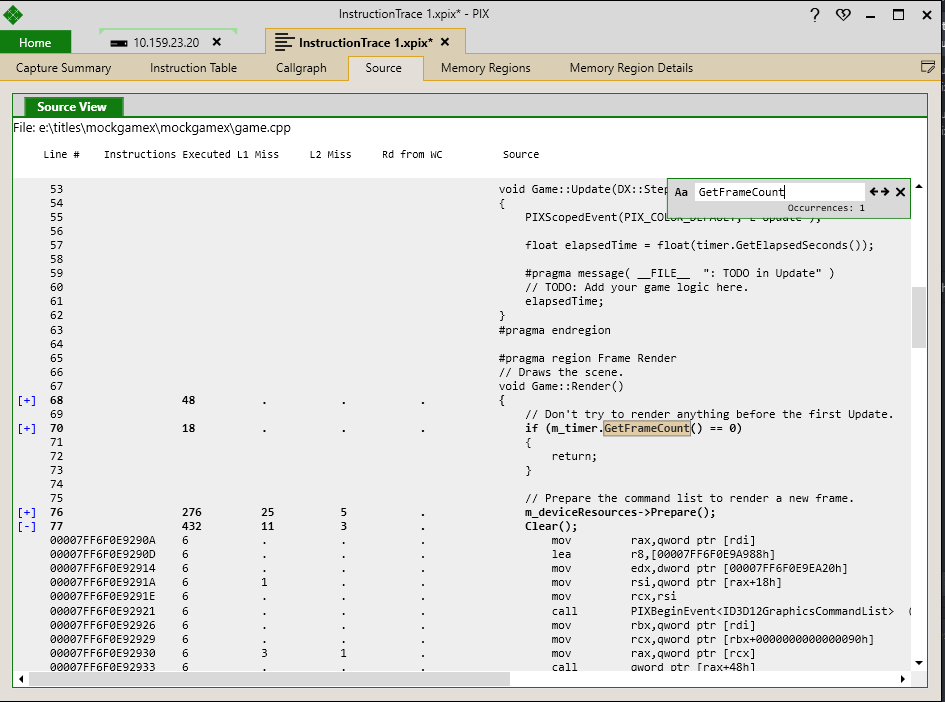
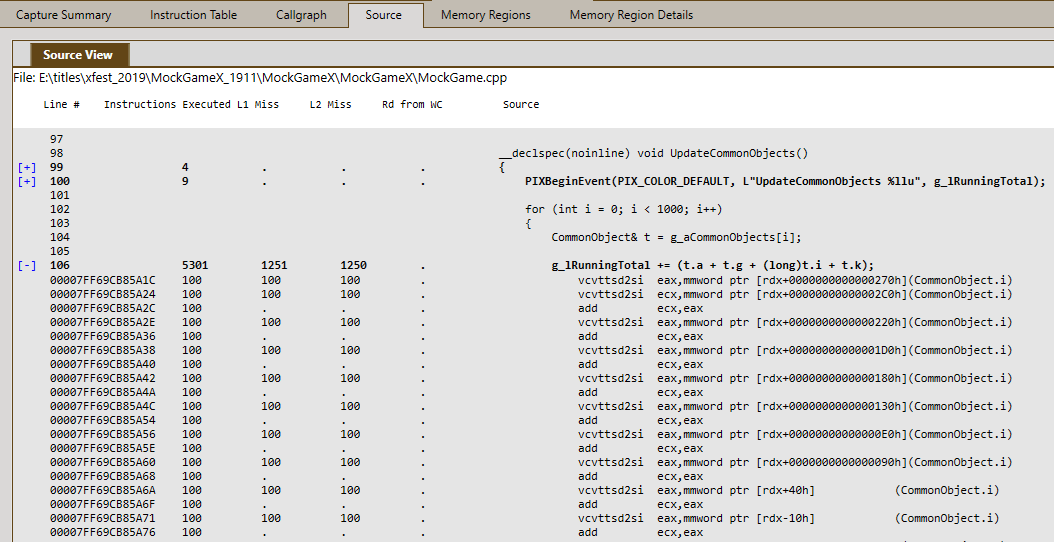
O layout Source é usado para examinar o código-fonte C++ de uma determinada função. Com frequência, chega-se a esse layout clicando em um hiperlink ao lado de uma função no layout Summary ou selecionando o item de menu de contexto Goto Source no layout Summary ou no layout Instruction Table. Go To Source Cada linha de código-fonte C++ é anotada com as instruções em linguagem assembly correspondentes a essa linha, junto com as contagens de execução e de falhas de cache de cada instrução executada. Os tipos de dados acessados por cada instrução também são mostrados se a opção Track Data Types tiver sido selecionada antes de iniciar a captura. O nome do arquivo de origem é exibido na parte superior da exibição. O arquivo de origem aberto é o arquivo especificado no PDB, incluindo seu caminho. As setas de expandir e recolher podem ser usadas para ver ou ocultar todas as instruções de assembly associadas a uma determinada linha de código-fonte. Código-fonte do rastreamento de instruções Se o arquivo de origem C++ especificado no PDB não puder ser encontrado, uma mensagem será exibida ao lado do nome do arquivo de origem, e a exibição voltará a mostrar somente as instruções em linguagem assembly. A exibição Source também tem um recurso “Find” usado para localizar um texto específico no código-fonte, conforme mostrado na figura a seguir. Para abrir a caixa de diálogo Find in Source, pressione Ctrl+F. Para encontrar a próxima ocorrência do texto, pressione F3. Recurso Find do rastreamento de instruções O texto pode ser copiado da exibição Source e colado em outra ferramenta para dar suporte a cenários de análise adicionais. Depois de selecionar o texto a ser copiado, use Ctrl+C para copiá-lo para a área de transferência. Ctrl+A pode ser usado para selecionar todo o texto na exibição Source.
Callgraph

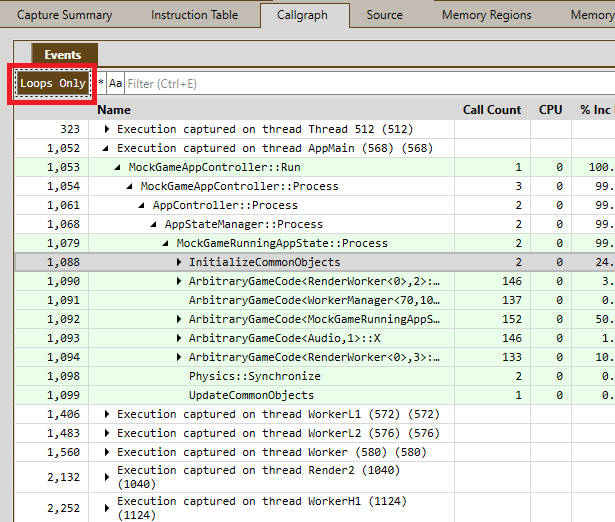
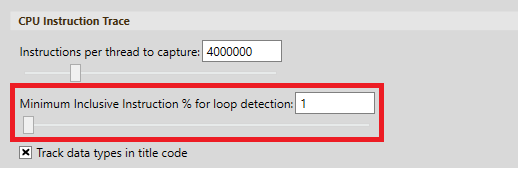
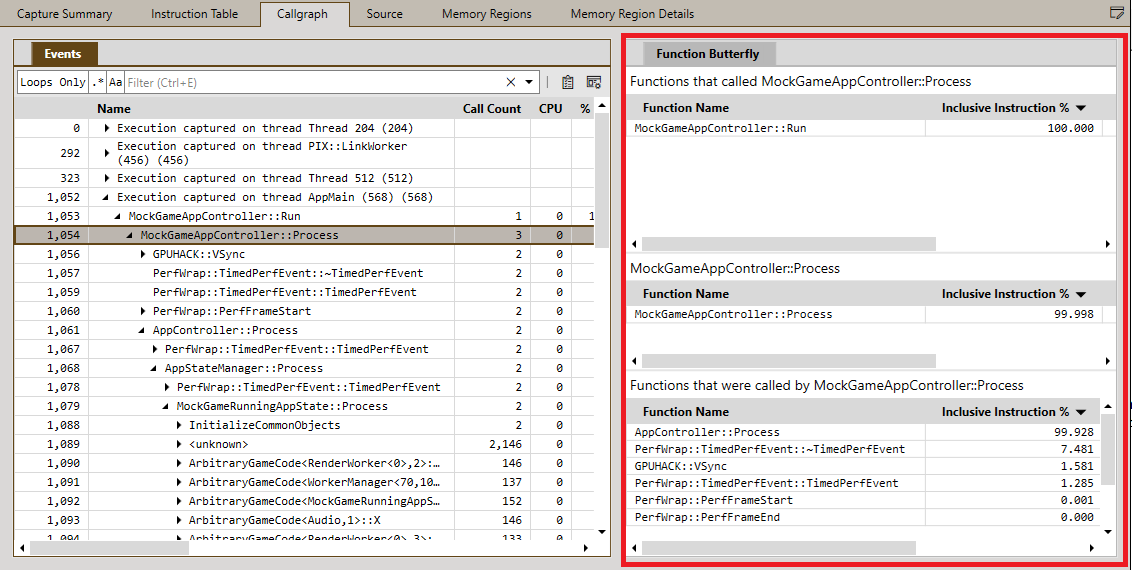
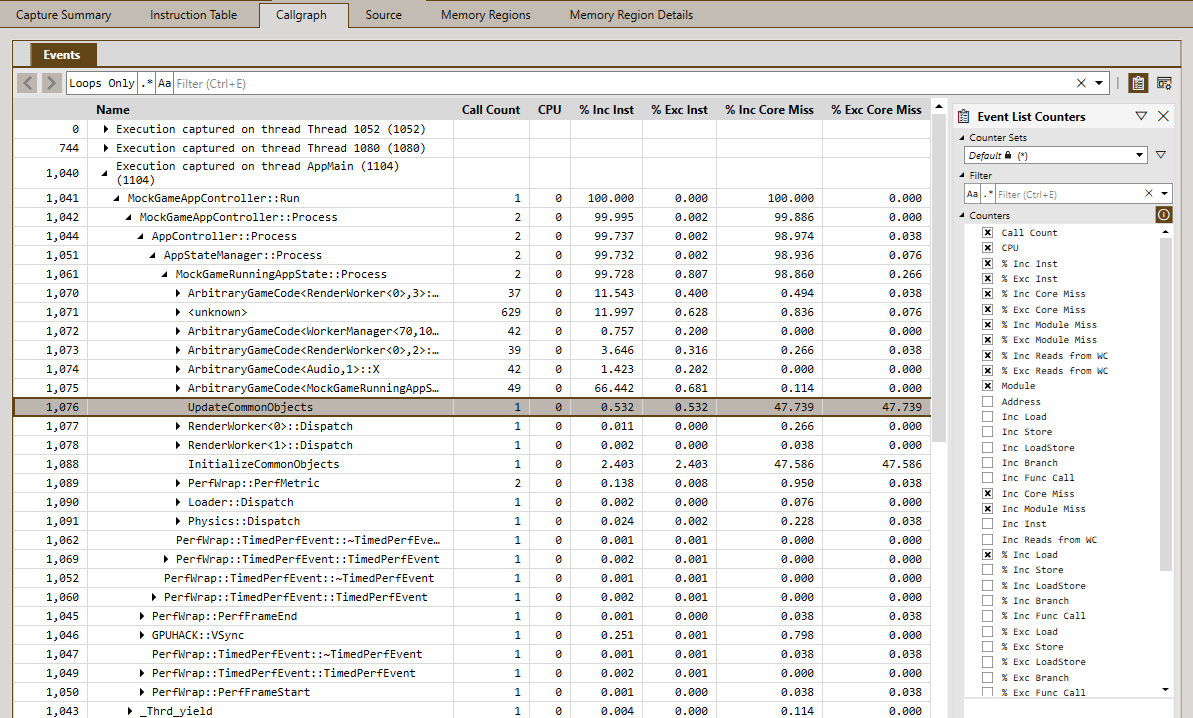
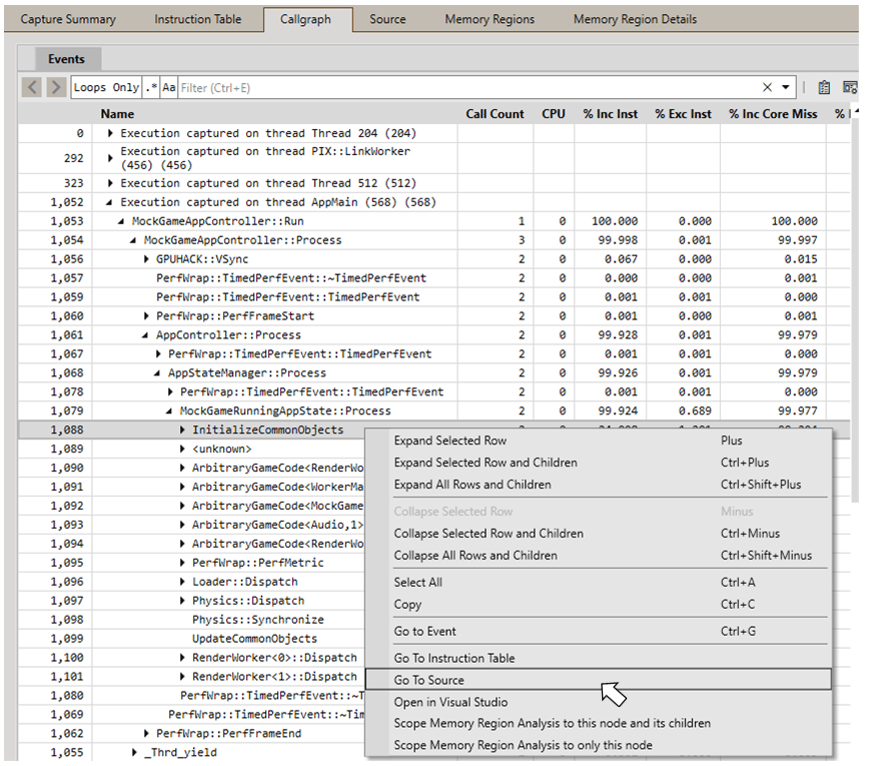
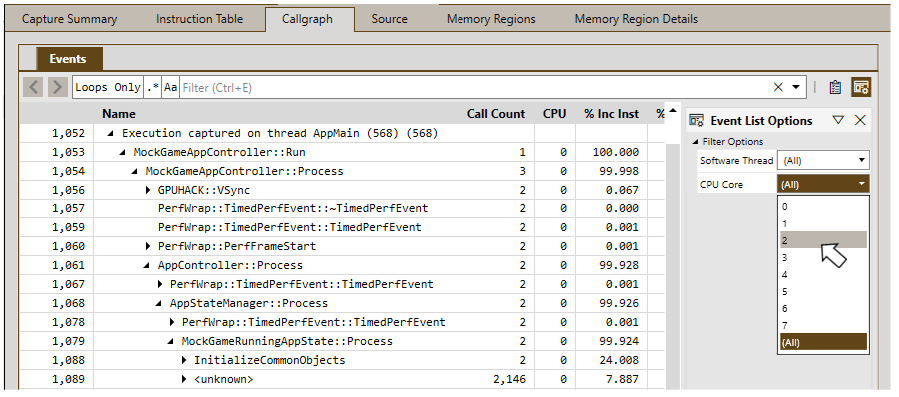
Os rastreamentos de instruções incluem um layout que mostra o gráfico de chamadas de todas as funções executadas durante a captura. Cada thread em que o código foi executado é um nó de nível superior na árvore. O conjunto de colunas da exibição pode ser usado para examinar várias estatísticas sobre cada chamada, incluindo o número de falhas de cache, um detalhamento por tipo de instrução e assim por diante. O conjunto de colunas a serem exibidas pode ser personalizado usando o painel Event List Counters. Gráfico de chamadas do rastreamento de instruções Clicar com o botão direito do mouse em uma função no gráfico de chamadas abre um menu de contexto que contém várias opções para você explorar melhor a função, conforme mostrado na figura a seguir. As opções incluem ver uma combinação de código-fonte e código assembly da função e a possibilidade de abrir o layout Memory Regions com escopo na memória acessada pela função. Menu de contexto da exibição Callgraph O gráfico de chamadas pode ser filtrado para uma thread ou um núcleo específico usando o painel Event List Options. O painel Event List Options na exibição Callgraph A barra de filtro na parte superior do gráfico de chamadas tem um botão Loops Only que filtra os dados para as funções que contêm loops. Os loops costumam ser seções de código interessantes para investigar problemas de desempenho. Problemas comuns incluem aninhamento desnecessário e percurso ineficiente de estruturas de dados. Loops do rastreamento de instruções Por padrão, somente são exibidos os loops contidos em funções cuja contagem inclusiva de instruções foi de 1% ou mais de todas as instruções executadas na captura. Essa tolerância pode ser ajustada usando a configuração Minimum Inclusive Instruction % for loop detection, que pode ser encontrada na seção CPU Instruction Trace da exibição Settings. A configuração Minimum Inclusive Instruction % for loop detection A exibição Butterfly no lado direito do layout mostra os chamadores e os chamados de uma função selecionada. Clicar em uma linha no gráfico de chamadas define essa função como a função em foco na exibição butterfly. A função em foco é exibida na tabela do meio da exibição. A tabela superior da exibição lista todos os chamadores da função em foco. A tabela inferior da exibição lista todas as funções chamadas pela função em foco. Clicar duas vezes em uma função na tabela de chamadores ou de chamados define essa função como a nova função em foco, facilitando a navegação pelos chamadores e chamados de uma série de funções. A exibição Butterfly nas Instruction Trace Captures
Memory Regions

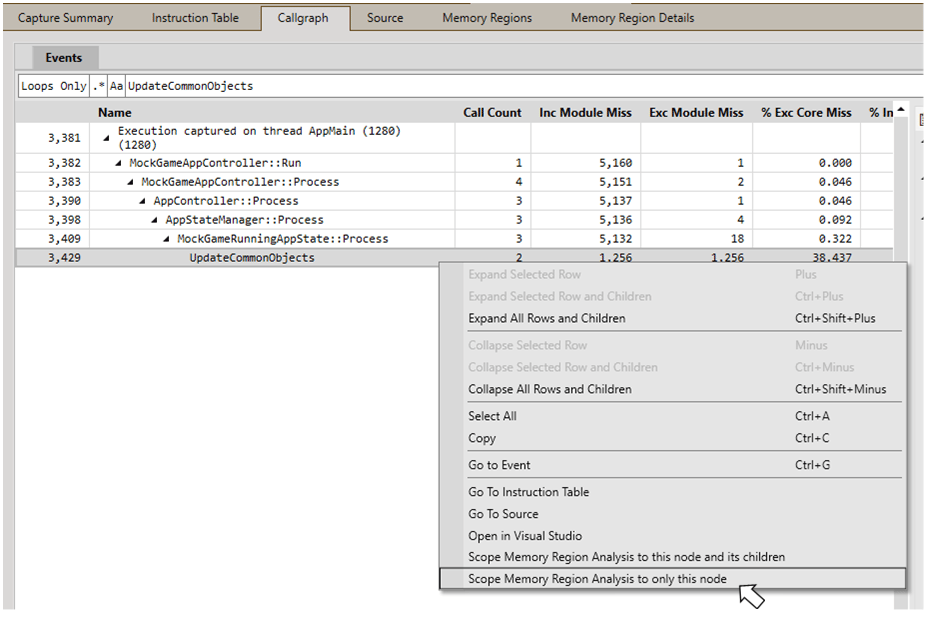
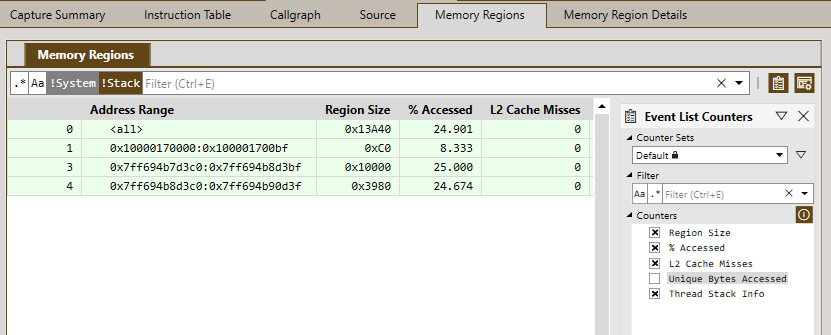
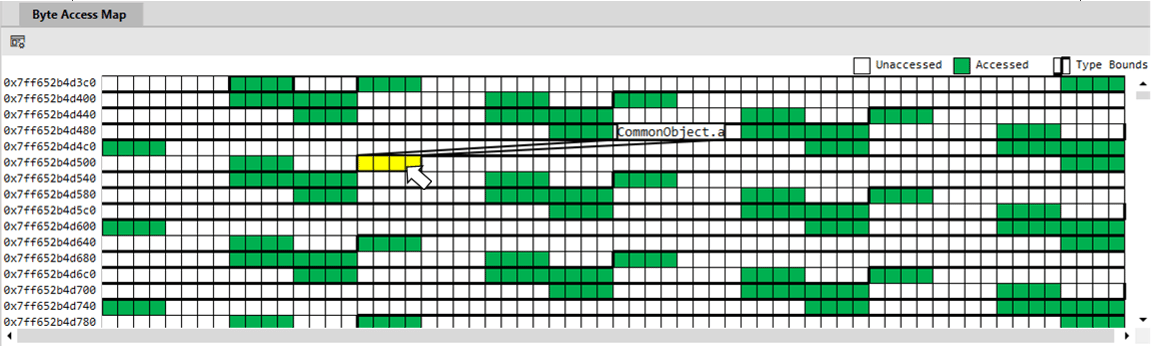
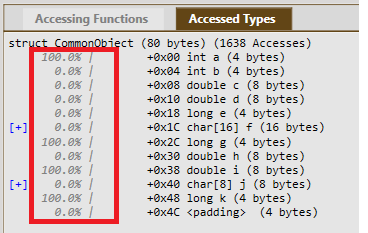
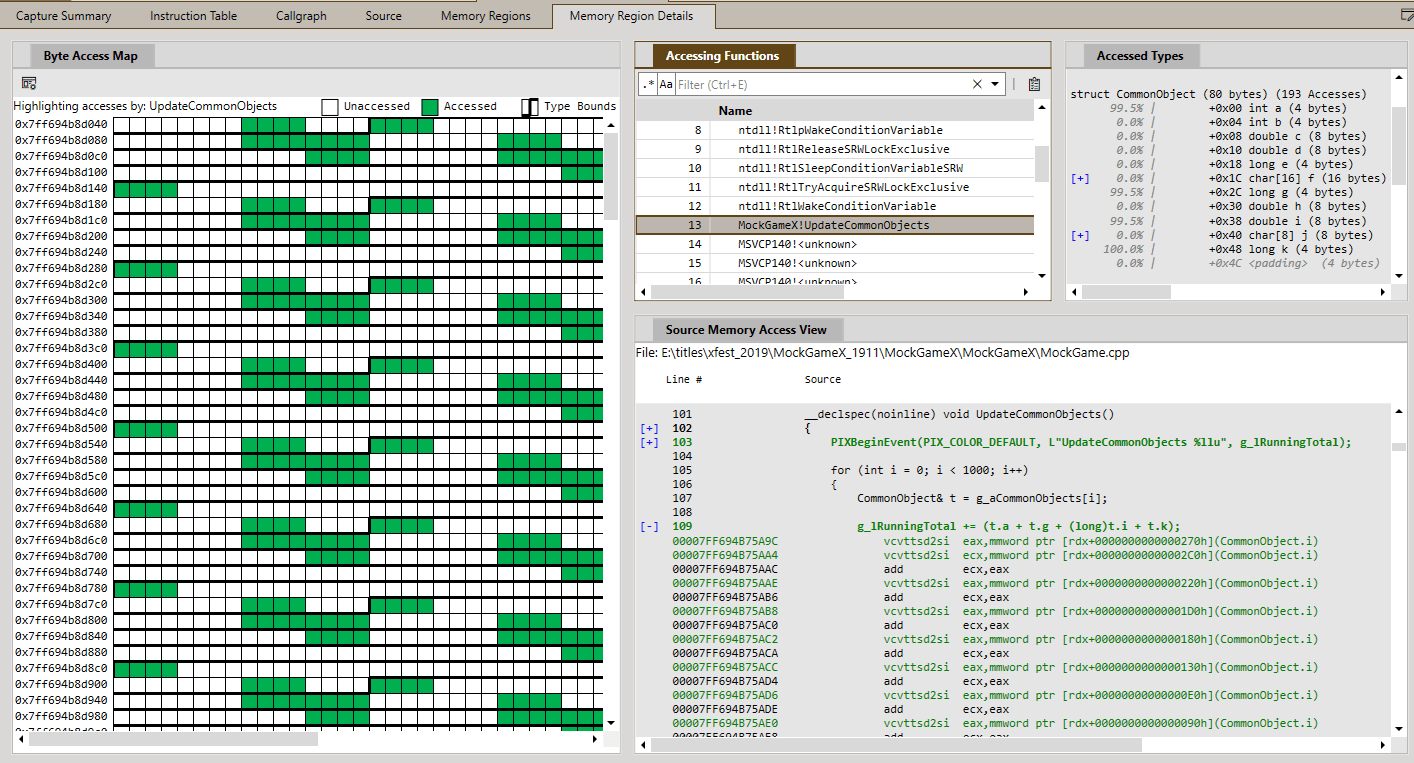
O layout Memory Regions fornece detalhes sobre os padrões de acesso à memória para um conjunto de intervalos de endereços. Esses detalhes incluem o conjunto de bytes individuais que foram acessados em cada linha de cache, junto com o conjunto de funções e tipos de dados associados a cada acesso à memória. O layout Memory Regions é mais útil quando os dados que exibe têm como escopo uma função específica. Um fluxo de trabalho comum é identificar uma função que está causando falhas de cache de dados usando o layout Summary ou o layout Callgraph e, em seguida, usar o menu de contexto do layout Callgraph para navegar até o layout Memory Regions. Na figura a seguir, uma função chamada UpdateCommonObjects foi identificada como uma função de interesse, devido às altas contagens de falhas de cache exibidas no layout Callgraph. O item de menu de contexto Scope Memory Analysis to only this node é usado para navegar até o layout Memory Regions. Definir o escopo da exibição Memory Regions para uma função específica A tabela Memory Regions mostra o conjunto de intervalos de endereços analisados no momento. As colunas disponíveis incluem o tamanho da região, o número de falhas de cache de dados do L2 e a porcentagem da região de memória que foi acessada. O tamanho de uma região de memória normalmente é de 64K. Intervalos com tamanho menor que 64K indicam que houve uma lacuna significativa nos endereços entre os acessos à memória. Os botões !System e !Stack na barra de filtro podem ser usados para excluir regiões de memória que foram acessadas somente por código do sistema ou que corresponderam a acessos à pilha. O conjunto de colunas a serem exibidas pode ser personalizado usando o painel Event List Counters. A tabela Memory Regions Selecionar uma linha na tabela Memory Regions preenche as exibições Byte Access Map, Accessing functions e Accessed Types. O Byte Access Map fornece detalhes de acesso à memória para bytes individuais em uma linha de cache. Cada linha da exibição representa uma linha de cache. As 64 caixas da linha representam os bytes individuais da linha. As caixas verdes representam bytes que foram acessados, enquanto as caixas brancas representam bytes que não foram acessados. Passar o mouse sobre um conjunto de caixas exibe uma dica de ferramenta com informações de tipo de dados, se disponíveis. As informações de tipo de dados estarão disponíveis se a opção Track Data Types tiver sido selecionada antes de iniciar uma captura. O Byte Access Map a seguir mostra um padrão de acesso a dados relativamente ineficiente (esparso), conforme indicado pelo número relativamente pequeno de caixas verdes e pelas lacunas significativas entre os bytes que foram acessados. A dica de ferramenta mostra que o conjunto realçado de caixas verdes representa um acesso ao campo a de uma estrutura de dados chamada CommonObject. O Byte Access Map A tabela Accessing Functions lista o conjunto de funções que acessaram a memória no intervalo selecionado no momento. Se várias funções estiverem listadas, selecionar uma função atualizará o Byte Access Map para realçar os acessos feitos por essa função. A exibição Accessed Types lista o conjunto de tipos de dados que foram acessados no intervalo selecionado no momento. Se um tipo de dados for uma estrutura, a exibição será anotada com a porcentagem de vezes que cada campo da estrutura foi acessado. A figura a seguir mostra um tipo em que os campos a, g, i e k foram acessados 100% das vezes, enquanto os outros campos nunca foram acessados. A lista Accessed Types Também são fornecidas informações de tamanho de cada campo, junto com o tamanho do próprio tipo. O padrão de acesso esparso da estrutura CommonObject, conforme indicado tanto no Byte Access Map quanto na lista Accessed Functions, representa uma oportunidade de refatorar o tipo de dados e o código que o acessa para fazer um uso mais eficiente dos caches de dados do console.
Memory Region Details

O layout Memory Region Details fornece um nível adicional de análise de linhas de cache por meio da exibição Source Memory Access. Essa exibição fornece o código-fonte C++, intercalado com instruções de assembly e informações de tipos de dados, que mostra exatamente quais linhas da função estão afetando a região de memória. As linhas de código-fonte e de assembly realçadas em verde estão acessando dados na região de memória. Selecionar outra função na exibição Accessing Functions atualiza o Byte Access Map e a exibição Source Memory Access com informações específicas da função selecionada. O layout Memory Region Details
Práticas recomendadas e limitações

O rastreamento de instruções mostra as falhas de cache de dados do L1 e do L2. As falhas de L3 também são fornecidas quando a captura é feita em um XBOX Series X Dev Kit ou XBOX Series S Test Kit. Essas contagens aparecem nos vários layouts da captura. As contagens de falhas de cache se baseiam em uma simulação dos caches, e não em contadores ou eventos reais de hardware. A simulação é usada porque o rastreamento de instruções gera processamento adicional por instrução executada, o que distorceria quaisquer contadores reais de hardware. No entanto, há vários fatores a considerar ao analisar os dados produzidos pela simulação de cache.
  • Presume-se que os caches estejam frios, portanto as falhas iniciais podem não ser precisas.
  • A latência para carregar linhas não é modelada.
  • Tipos de memória diferentes de write-back (a memória em cache padrão) não são modelados.
  • Os prefetchers de hardware não são modelados.
  • Nenhum acesso especulativo à memória é modelado, porque a execução fora de ordem não é totalmente modelada.
Observe também que o rastreamento de instruções não pode ser usado se o título estiver parado em um ponto de interrupção no depurador.

Veja também

PIX
Última modificação em 8 de outubro de 2026