> ## Documentation Index
> Fetch the complete documentation index at: https://devdocs.xbox.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 混合式 CPU 環境中的遊戲效能
> 針對 Intel、AMD 和 Qualcomm 的異質 CPU 調整 PC 遊戲的執行緒親和性、CPU 集合列舉和優先順序提升,以達成一致的畫面時間。
CPU 製造商一直在效能、耗電量和晶粒面積之間取得平衡。原因在於客戶有不同的使用模式和優先考量。使用桌上型電腦的人較重視效能,而筆記型電腦使用者則較重視電池續航力。較小的晶粒面積可以帶來較低的生產成本。為了因應這些相互競爭的需求,CPU 製造商設計了*異質架構*,讓系統能夠動態適應目前的工作負載需求,同時維持成本效益。
CPU 製造商透過使用不同效率等級的 CPU 核心來實作異質拓撲。這種方法以更省電的核心取代現有 CPU 架構中的部分核心。如果使用者不需要 CPU 的完整效能,作業系統會關閉效能較高的核心以節省大量電力,進而延長電池續航力。需要更多效能時,作業系統可以動態開啟效能較高的核心,以處理增加的工作負載。
## 硬體
各家獨立硬體廠商 (IHV) 對異質 CPU 拓撲的定義各不相同。Intel 和 Qualcomm 使用 **Performance** (效能) 和 **Efficiency** (效率) 這兩個詞,而 AMD 則使用 **Performance** (效能) 和 **Compact** (精簡)。每家廠商在設計其核心拓撲時,都會在效能與效率之間做出取捨。
下列範例說明其中涉及的一些設計選擇:
* **不同的快取大小**
* 不同的核心可能有不同的快取大小。
* 例如,效能核心可能有較大的 L1 和 L2 快取。
* **快取共用**
* 核心之間的快取共用程度可能各不相同。
* 例如,效能較高的核心可能各自擁有專用的 L2 快取,而效率較高的核心則可能共用單一 L2 快取。
* **對同步多執行緒 (SMT) 的支援**
* 有些核心可能支援 SMT,而其他核心則不支援。
* Intel 將 SMT 稱為*超執行緒 (Hyper-Threading)*。
* **核心內部配置**
* 各種核心類型的內部資源可能不同。
* 例如,效能核心可能包含更多浮點管線、ALU 管線或更寬的資料通道。
* **最大頻率**
* 不同核心類型的最大頻率可能不同。
* 例如,效能核心可能可以達到比效率核心更高的頻率。
這些變更旨在平衡 CPU 內各核心的效能與耗電量。頻率較高的核心效能較高,但代價是耗電量增加。多個核心共用相同的快取可縮小晶粒大小,進而降低耗電量,但代價是效能降低。其目標是在效能與耗電量方面提供更動態的選擇。如果使用者不需要完整效能,作業系統會切換到效率較高的核心以降低耗電量。
請務必注意,Windows 要求 CPU 上的所有核心都支援相同的[指令集架構](https://en.wikipedia.org/wiki/Instruction_set_architecture) (ISA)。此需求表示,如果 CPU 支援特定指令集,則 CPU 中的所有核心都支援該指令集。例如,如果 CPU 表示支援 AVX2,則所有核心都支援 AVX2。
如需效能核心與效率核心之間差異的具體詳細資料,請參閱各 IHV 的官方文件。
## 效能數據
您會預期不同效率等級的核心表現不同。一種核心專為效能而設計,另一種則專為省電而設計。問題在於這些核心之間的差異有多大。
所顯示的資料是彙整各家 IHV 的結果。根據各 IHV 對其拓撲所做的選擇,每項測試的縮放比例都不同。雖然確切數字不同,但所有 IHV 的模式都很相似。此外,每一代 CPU 都會做出不同的取捨,進而調整其相對數字。建立涵蓋所有現有 IHV 和世代的數據超出了本文的範圍。
### 綜合測試
向量數學是遊戲在一個畫面內所執行工作的主要部分。此工作負載可以是物理、AI 到轉譯等任何內容。遊戲使用包含三或四個浮點數的向量類型來執行這項工作,這些向量可放入單一 128 位元 SSE 暫存器中。它們涵蓋廣泛的運算,例如內積、矩陣乘法、平方根計算和向量轉換。這些運算的效能差異可能會對整體畫面時間產生重大影響。
下列圖表顯示執行七種常見數學運算的相對成本。測量使用的向量包含四個 32 位元浮點值,儲存在單一 128 位元 SSE 暫存器中。矩陣由四個向量組成,共有十六個 32 位元浮點值,分布在四個 128 位元 SSE 暫存器中。之所以選擇這些運算,是因為它們在一個畫面內很常使用。
* **內積**:計算向量的內積。
* **轉換向量**:將向量與矩陣相乘以轉換向量。
* **向量加法**:將兩個向量相加。
* **外積**:計算兩個向量的外積。
* **向量正弦**:計算向量中每個元素正弦的近似值。
* **向量 FMA (融合乘加)**:將兩個向量相乘,再加上第三個向量。
* **反平方根**:計算向量長度的反平方根。
**圖 1:執行運算所花費的時間。越低越好。**
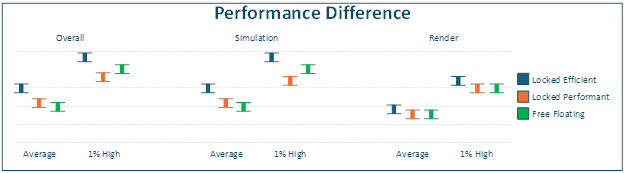 在此圖表中,y 軸是執行運算所花費的時間。每個長條代表在所有 IHV 上測得的運算時間範圍,也就是在效能核心或效率核心上執行測試時的最短和最長時間。
不出所料,不同核心類型之間的效能有所不同。然而,從這些數字得到的重點是,效能並不會在所有運算和 IHV 之間等比例縮放。雖然各 IHV 結果的變異性往往相似,但有些變異性較高。變異性較高的運算主要出現在向量正弦和反平方根運算中。這種差異可以追溯到效能核心與效率核心之間的核心架構選擇。此差異的確切原因可能來自多個來源。例如,效能較高的核心可能有更多浮點管線,因此能平行執行更多運算。確切原因因每個 IHV 和 CPU 世代而異。甚至可能存在某些運算沒有效能差異的組態。總而言之,遊戲需要考量各 IHV 之間的這種變異性。
## 實際情況
前述數字顯示的是單獨的特定基準測試,只說明了部分情況。下列數字來自一款 AAA 遊戲引擎的基準測試,該引擎使用兩個主要執行緒 (模擬和轉譯) 以及一組工作執行緒。基準測試使用三種測試組態。
* 兩個主要執行緒只在效能較高的核心上執行。
* 兩個主要執行緒只在效率核心上執行。
* 兩個主要執行緒在系統中的所有核心上執行。
在每種測試組態中,工作執行緒都可以在系統中的所有核心之間自由浮動。轉譯工作使用最低的解析度和品質。此設定可保證遊戲在整個測試執行期間都受 CPU 限制。此設定也讓模擬執行緒成為影響畫面播放速率的主要因素。
此圖表顯示一個畫面期間每個執行緒所花費的時間量。它同時顯示平均畫面時間和 1% 高值。1% 高值是最長的 1% 畫面的臨界值。所有畫面中只有 1% 高於此值。這個數字能很好地反映出卡頓畫面的數量。與平均值的差距越大,遊戲的卡頓就越嚴重。在所有情況下,值越低表示長畫面越少,可見的卡頓也越少。
如前所述,所顯示的資料是彙整各家 IHV 的結果。根據各 IHV 對其拓撲所做的選擇,每項測試的縮放比例都不同。雖然確切數字不同,但各 IHV 的模式都很相似。每一代 CPU 可能會做出不同的取捨,進而調整其相對數字。建立涵蓋所有現有 CPU IHV 和世代的數據超出了本文的範圍。
**圖 2:平均花費時間和 1% 高值。越低越好。**
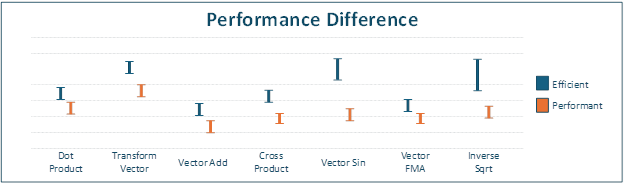 在此圖表中,y 軸是一個畫面所花費的時間。每個長條代表在所有 IHV 上測得的運算時間範圍,也就是每種受測執行緒拓撲的最短和最長時間。
作業系統執行緒排程器會使用啟發學習法來判斷執行緒所執行的工作量。這些啟發學習法結合了作業系統的選擇以及 IHV 的驅動程式調整。排程器會使用此資訊來選擇特定執行緒應該在哪些核心上執行。當排程器判定某個執行緒正在執行大量工作時,會將該執行緒移至效能較高的核心。
由於排程器的啟發學習法,可能會發生一些違反直覺的行為,也就是允許關鍵執行緒自由浮動時,遊戲反而執行得更快。這種行為不一定會發生,而是取決於工作負載、核心拓撲和確切的排程器啟發學習法。
在此處測試的案例中,模擬執行緒在每個畫面中執行的時間比轉譯執行緒多。排程器偏好將此執行緒放在效能較高的核心上。由於轉譯執行緒花更多時間暫停等待工作,排程器也決定將其放在效能較低的核心上。最終結果是,此決定為其中一個工作執行緒空出了一個效能較高的核心。如果轉譯執行緒執行更多工作,可能就不會發生這種情況。
然而,此圖表中最有趣的重點在於 1% 高值。即使關鍵執行緒自由浮動時的平均值相同,其 1% 高值仍比關鍵執行緒鎖定在效能核心上時更差。這表示關鍵執行緒自由浮動時,畫面播放速率的卡頓會更多。最常見的原因是排程器的啟發學習法是在滑動視窗上運作。它需要時間來回應一個畫面所需工作量的突增。在這段時間內,關鍵執行緒可能正在效能較低的核心上執行。
每家製造商都可以調整這些排程器啟發學習法,以針對其硬體量身打造。例如,AMD 有其 Workload Profile Scheduling,而 Intel 有其 Thread Director 技術。每家 IHV 也傾向於調整啟發學習法,以符合 SoC 的特定拓撲。
## 建議
### 執行緒親和性
在只有單一效率類別的桌上型電腦上執行時,對執行緒親和性的建議是避免設定硬性執行緒親和性,而是讓執行緒在所有核心之間浮動。造成這種不確定性的主要原因是,事先無法得知使用者電腦上可能正在執行哪些其他處理序。具有硬性親和性的執行緒可能最終會與系統中另一個高優先順序執行緒共用一個核心。最終結果是遊戲執行緒無法獲得執行時間。如果此爭用發生在畫面關鍵執行緒上,遊戲可能會出現不一致的畫面時間。您需要確保作業系統有地方可以移動遊戲執行緒,讓它們持續執行。
然而,在異質 CPU 上執行時,此建議需要改變。主要原因是作業系統不一定知道遊戲的哪些執行緒或工作是畫面關鍵的。它有一些啟發學習法可判斷它認為的畫面關鍵執行緒,但這些啟發學習法仍可能做出錯誤的選擇。它可能會決定將其中一個執行緒或工作移至效能較低的核心,因而提高遊戲發生效能問題的可能性。
建議的目標是允許遊戲執行緒至少在三到四個核心上執行,越多越好。例如,在擁有一個高效能核心和三個低效能核心的低階系統上,您應該允許執行緒在所有核心之間浮動。在擁有三個以上效能核心的電腦上,您可以將畫面關鍵執行緒限制為只在這些高效能核心上執行。
在擁有許多核心且支援 SMT 的高階電腦上,有些遊戲可能會嘗試將其執行緒鎖定在實體核心上。此技術可避免多個高優先順序執行緒共用實體核心的相同資源時,在實體核心層級發生爭用。不過一般而言,不建議考慮這種情況。作業系統已在整個系統套用此行為。它會先將執行緒排程到各個實體核心上,只有在必要時才使用更多邏輯核心。
遊戲唯一應考慮的情況是,系統中有足夠的高效能核心來支援遊戲的關鍵執行緒。在此情況下,可能會希望將畫面關鍵執行緒鎖定在效能較高的核心上。不過,應該允許這些執行緒在所有效能較高的核心之間浮動。雖然在某些情況下,允許所有執行緒在所有核心之間浮動可以改善效能,但這種行為在所有 CPU 製造商之間並不一致。
如果遊戲實作了可在所有執行緒之間完全平衡工作負載的工作竊取系統,則應允許任何工作執行緒在所有核心之間浮動。無論它們是高優先順序或低優先順序的工作執行緒都沒有關係。工作竊取演算法會自動平衡負載,讓最多的工作在最短的時間內完成。效能較高之核心上的執行緒會在畫面期間執行更多工作。
如果有多個畫面關鍵執行緒,設定其親和性讓任兩個畫面關鍵執行緒都無法在同一個核心上執行,可能會很有用。例如,如果有兩個畫面關鍵執行緒,將其親和性設定為彼此互斥 (exclusive or),即可消除作業系統導致這些執行緒彼此爭用的可能性。不過同樣地,只有在核心數足以支援此情況,同時仍允許每個畫面關鍵執行緒至少在三到四個核心之間浮動時,才考慮此選項。
### 執行緒拓撲
在考慮如何在異質環境中將工作指派給執行緒時,主要資料圍繞在各種工作的長度以及它們彼此之間的互動方式。例如每項工作的平均長度、工作之間的相依性、每項工作的優先順序等。
工作執行緒能吸收多少任何關鍵執行緒或工作的時間突增?如果其中一個執行緒或工作的執行速度慢了 35%,對畫面時間的影響有多大?例如,如果某項工作執行時間過長,此延遲對畫面其餘部分的影響有多大?系統是否會停滯直到該工作完成?
在關鍵執行緒或工作中加入額外負荷,有助於判斷異質系統對畫面時間的影響程度。作為測試,可隨機讓某個工作或工作區塊多花 25%-35% 的時間。整體畫面時間的變化程度,可顯示工作系統吸收執行突增的能力。理想情況是畫面時間幾乎沒有變化。這表示系統可以吸收畫面時間中的任意突增。這些突增可能來自在效能較低的核心上執行,或來自系統中其他隨機處理序佔用 CPU 時間。
### 執行緒通訊
使用鎖定基本類型進行執行緒通訊時,應多加考量。內容切換的負荷與新執行緒開始執行前接收端核心的 [C-State](https://en.wikipedia.org/wiki/ACPI) 密切相關。核心必須處於 C0 (執行狀態),新執行緒才能開始執行。成本最低的情況是核心已經在執行中,也就是已處於 C0。然而,如果核心處於閒置狀態,就會處於較低的 C-State。C-State 的等級對應到更深層的睡眠。睡眠越深,核心使用的電力就越少。然而,從較深的睡眠中喚醒並重新開始執行的成本較高。最常見的低功耗 C-State 是 C1,可能會增加 2-7 μs 的負荷。下一個 C-State C2 可能會增加大約 40-100 μs 的負荷。確切數字因 IHV 和 SoC 而異。有許多變數會控制核心閒置時處於哪個 C-State,這是回應能力與耗電量之間的平衡。較低的 C-State 比較高的 C-State 使用更少的電力。常見的情況是核心先進入 C1,如果一段時間沒有執行程式碼,再切換到 C2。
另一個需要考量的問題是,當提交工作的執行緒與執行工作的執行緒位於效能特性不同的核心上時,會發生什麼情況。技術上,工作執行緒完成工作的速度有可能比建立新工作的速度更快。如果執行工作的執行緒所在核心比提交工作的執行緒更快,就更有可能發生這種情況。
如果執行工作所需的時間比建立工作的時間短,遊戲可能會陷入工作執行緒不斷暫停以等待新工作的情況。最終結果是,由於工作執行緒不斷暫停,工作的執行成本變得更高。內容切換的負荷成本會加到每個工作的執行時間上。這種負荷可能會矛盾地導致在效能較高的核心上執行時,畫面播放速率反而降低。例如,原本需要 250 μs 的工作可能突然開始需要 275 μs,這種退化相當於效能下降 10%。
基於這種情況,建議以批次方式提交工作,而不是在建立時就逐一提交。例如,如果系統遵循建立工作、提交工作、建立工作、提交工作等模式,則應將此模式調整為先執行一批建立作業,然後再同時提交所有工作。
如果遊戲使用需要 [WaitForSingleObject](https://learn.microsoft.com/windows/win32/api/synchapi/nf-synchapi-waitforsingleobject) 的物件,則應將其放在小型的旋轉迴圈內。以逾時值 0 呼叫函式,旋轉完成後再使用遊戲的一般逾時值。不過,此問題的最佳解決方案是使用新式同步 API,例如 [Slim Reader/Writer (SRW) Locks](https://learn.microsoft.com/windows/win32/sync/slim-reader-writer--srw--locks)、[Critical Sections](https://learn.microsoft.com/windows/win32/sync/critical-section-objects) 和 [WaitOnAddress](https://learn.microsoft.com/windows/win32/api/synchapi/nf-synchapi-waitonaddress)。這些同步 API 在內部都包含某種形式的旋轉,可避免執行緒不斷暫停。對於只持有短時間的鎖定,這種旋轉特別有用。
請務必避免長時間的旋轉鎖定。例如,執行緒不斷旋轉以等待要執行之工作的模式。如果核心上有其他需要執行的工作,排程器最終會暫停旋轉中的執行緒以執行這項工作。發生這種先佔時,被暫停的執行緒很可能會維持暫停相當長的時間。這種行為完全是為了防止其他執行緒無法獲得執行時間。由於遊戲幾乎無法控制暫停何時發生,因此可能會導致畫面播放速率卡頓。
### 工作系統
為了獲得最佳效能,請以工作為核心來建構引擎,而不是依賴專用、長時間執行的畫面關鍵執行緒。例如,模擬/轉譯執行緒模型會建立兩個持續存在的畫面關鍵執行緒。然而,冗長的工作可能會導致任何工作執行緒表現得像畫面關鍵執行緒。如果某個工作需要 10 毫秒,無論執行它的執行緒原本的角色為何,該執行緒在這段期間都會成為畫面關鍵執行緒。
### 工作竊取
首要建議是在整個工作系統中使用工作竊取,並讓任何畫面關鍵執行緒參與工作竊取演算法。例如,如果轉譯執行緒正在等待轉譯相關工作完成,它應該執行其中一些工作。
這種行為在許多遊戲引擎中已經是常見做法。不過,在此仍值得一提,因為這類行為對於遊戲引擎能否吸收因異質核心和可能的作業系統先佔所造成的畫面突增至關重要。
當工作需要較長時間執行時,會增加畫面時間突增的風險。這種行為可能是因為工作在效能較低的核心上執行,或是 PC 內的其他工作所造成。建議引擎的目標是讓每個工作約佔畫面的 2%。例如,對於以 60 fps 執行的遊戲,此預算表示不超過約 333 μs。如有需要,應將多個較小的工作批次處理成較大的工作,以達到 2% 的目標。這種方法能在工作大小、執行緒通訊和吸收突增的能力之間取得良好的平衡。
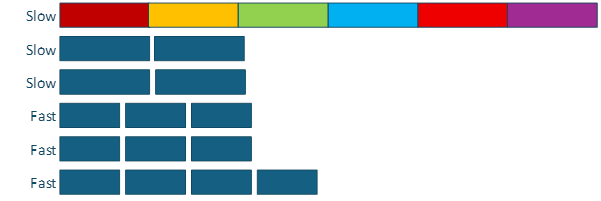
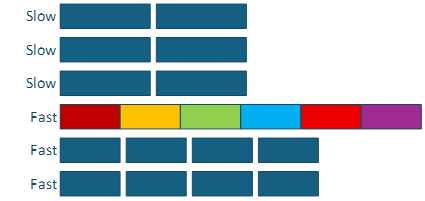
這些範例顯示長時間的畫面關鍵工作可能對系統效能造成的影響。在這些範例中,每個工作都包含相同數量的運算。在此範例中,單一工作在慢速核心上需要 375 μs,在快速核心上需要 250 μs。長桿工作的成本是其他工作的 6 倍。
最糟的情況是長桿工作最終落在其中一個慢速核心上。這可能會對畫面時間造成劇烈影響。在此情境中,執行工作的總時間為 2,250 μs,也就是 375 μs 的六倍。
**圖 3:在較慢核心上執行的長桿範例。**
 當長桿工作最終落在較快的核心上時,情況確實會好轉。在此情況下,總時間為 1,500 μs。雖然仍不理想,但已有改善。
**圖 4:在較快核心上執行的長桿範例。**
 最佳結果是讓工作大小保持小且平均分布,以避免長桿工作。在此範例中,總執行時間降至 1,125 μs,在完成相同工作量的情況下,時間是前一個範例的一半。
**圖 5:使用適當的工作長度以避免長桿工作。**
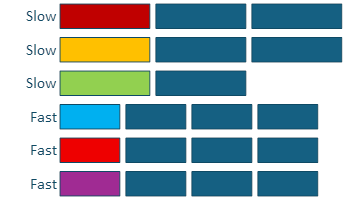 更重要的是,如果作業系統嘗試在工作執行期間中斷,系統會自動平衡工作負載。在此情況下,作業系統在快速核心上以一個 375 μs 的工作中斷了遊戲。這種重新平衡對整體畫面時間沒有影響,仍維持在 1,125 μs。其中一個工作移轉到慢速核心上的空閒時間。
**圖 6:作業系統中斷時,工作負載重新平衡可維持穩定的畫面時間。**
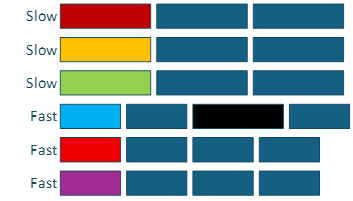 這些範例只涵蓋長桿工作可以立即開始的情況;如果它要等到工作佇列後段才能開始,情況會更糟。這一切都回歸到 [Amdahl 定律](https://en.wikipedia.org/wiki/Amdahl%27s_law),也就是任何系統的執行時間都取決於該系統中執行最久的部分。引擎不可能吸收任何會增加這些長桿執行緒執行時間的突增。這些突增可能來自在較慢的核心上執行,或來自系統中其他高優先順序處理序的中斷。
## 總結
實作這些建議後,您可以確保遊戲在不同的 CPU 架構上都能可靠地執行,並在面對其他 Windows 處理序的干擾時保持穩定。
## 附錄
### 判斷核心的效率類別
使用 [GetLogicalProcessorInformationEx](https://learn.microsoft.com/windows/win32/api/sysinfoapi/nf-sysinfoapi-getlogicalprocessorinformationex) 函式判斷系統中每個處理器的效率類別。逐一查看函式傳回的資料,尋找包含效率類別和核心遮罩的 [RelationProcessorCore](https://learn.microsoft.com/windows/win32/api/winnt/ns-winnt-processor_relationship) 區塊。
```cpp theme={null}
char* processorInfoData = nullptr;
DWORD processorInfoDataSize = 0;
GetLogicalProcessorInformationEx(RelationAll, nullptr, &processorInfoDataSize);
processorInfoData = new char[processorInfoDataSize];
GetLogicalProcessorInformationEx(RelationAll, processorInfoData, &processorInfoDataSize);
auto workingDataBuffer = processorInfoData;
auto dataLeft = processorInfoDataSize;
while (dataLeft)
{
auto procInfo = (SYSTEM_LOGICAL_PROCESSOR_INFORMATION_EX*) workingDataBuffer;
switch (procInfo->Relationship)
{
case RelationProcessorCore:
{
processorEfficiency[procInfo->Processor.GroupMask[0].Mask] =
procInfo->Processor.EfficiencyClass;
}
break;
}
dataLeft -= procInfo->Size;
workingDataBuffer += procInfo->Size;
}
```
### 根據耗電量固定執行緒
如前所述,由於電腦上其他處理序可能造成干擾,因此不建議在桌面環境中使用親和性來固定核心。不過,Windows 提供了一些方法,讓遊戲可以向作業系統提供提示,建議應在何處執行工作。其中一種提供此指引的方式是透過電源管理 API。
```cpp theme={null}
THREAD_POWER_THROTTLING_STATE PowerThrottling;
ZeroMemory(&PowerThrottling, sizeof(PowerThrottling));
PowerThrottling.Version = THREAD_POWER_THROTTLING_CURRENT_VERSION;
//
// EcoQoS
// Turn EXECUTION_SPEED throttling on.
// ControlMask selects the mechanism
// and StateMask declares which mechanism should be on or off.
//
PowerThrottling.ControlMask = THREAD_POWER_THROTTLING_EXECUTION_SPEED;
PowerThrottling.StateMask = THREAD_POWER_THROTTLING_EXECUTION_SPEED;
SetThreadInformation(GetCurrentThread(),
ThreadPowerThrottling,
&PowerThrottling,
sizeof(PowerThrottling));
//
// HighQoS
// Turn EXECUTION_SPEED throttling off.
// ControlMask selects the mechanism
// and StateMask is set to zero as mechanisms should be turned off.
//
PowerThrottling.ControlMask = THREAD_POWER_THROTTLING_EXECUTION_SPEED;
PowerThrottling.StateMask = 0;
SetThreadInformation(GetCurrentThread(),
ThreadPowerThrottling,
&PowerThrottling,
sizeof(PowerThrottling));
//
// Let system manage all power throttling. ControlMask is set to 0 as we don't want
// to control any mechanisms.
//
PowerThrottling.ControlMask = 0;
PowerThrottling.StateMask = 0;
SetThreadInformation(GetCurrentThread(),
ThreadPowerThrottling,
&PowerThrottling,
sizeof(PowerThrottling));
```
### 使用 CPU Sets 查詢效率類別
使用 [CPU Sets](https://learn.microsoft.com/windows/win32/procthread/cpu-sets) 是查詢系統中每個核心效率類別的另一種方法。
```cpp theme={null}
bool QueryCPUSets()
{
ULONG requiredSize = 0;
(void)GetSystemCpuSetInformation(nullptr, 0, &requiredSize, GetCurrentProcess(), 0);
if (requiredSize == 0)
return false;
std::vector rawBuffer(requiredSize);
PSYSTEM_CPU_SET_INFORMATION cpuSets =
reinterpret_cast(rawBuffer.data());
if (!GetSystemCpuSetInformation(cpuSets, requiredSize,
&requiredSize, GetCurrentProcess(), 0))
return false;
std::vector cores;
std::map efficiencyLevelCounts;
uint8_t* current = rawBuffer.data();
uint8_t* end = current + requiredSize;
while (current < end)
{
PSYSTEM_CPU_SET_INFORMATION info =
reinterpret_cast(current);
if (info->Type == CpuSetInformation)
{
CoreEfficiencyInfo coreInfo = {};
coreInfo.cpuSetId = info->CpuSet.Id;
coreInfo.coreIndex = info->CpuSet.CoreIndex;
coreInfo.logicalProcessorIndex = info->CpuSet.LogicalProcessorIndex;
coreInfo.efficiencyClass = info->CpuSet.EfficiencyClass;
coreInfo.group = info->CpuSet.Group;
cores.push_back(coreInfo);
efficiencyLevelCounts[coreInfo.efficiencyClass]++;
}
current += info->Size;
}
return true;
}
```
### 使用 CPU Sets 將執行緒指派給效率類別
[CPU Sets](https://learn.microsoft.com/windows/win32/procthread/cpu-sets) 也可以用來取代為執行緒明確設定親和性遮罩。建議使用 CPU Sets,而不是明確的親和性遮罩。
```cpp theme={null}
bool LockThreadToEfficiencyClass1(HANDLE thread,
const std::vector& cores,uint32_t efficiencyClass)
{
std::vector cpuSetIds;
for (const auto& core : cores)
{
if (core.efficiencyClass == efficiencyClass)
{
cpuSetIds.push_back(core.cpuSetId);
}
}
if (cpuSetIds.empty())
return false;
if (!SetThreadSelectedCpuSets(thread, cpuSetIds.data(),
static_cast(cpuSetIds.size())))
return false;
return true;
}
```
## Related topics
- [PC 遊戲開發環境與工具](/zh-TW/tools/tools-pc/gc-tools-pc-toc.md)
- [XR-003 提交的遊戲品質](/zh-TW/publishing/certification/xr/xr-003.md)
- [Visual Studio 中的分析導引最佳化](/zh-TW/tools/tools-console/pgo/pgo_full.md)
- [針對 XBOX Game Streaming 最佳化您的遊戲](/zh-TW/build/core-features/common/game-streaming/game-streaming-optimizing-your-game.md)
- [永續性開發人員概觀](/zh-TW/build/game-principles/sustainability/sustainability-developer-overview.md)