> ## Documentation Index
> Fetch the complete documentation index at: https://devdocs.xbox.com/llms.txt
> Use this file to discover all available pages before exploring further.
# SHAPE 音訊流程圖建構最佳做法
> 深入了解 SHAPE:建構音訊流程圖的最佳做法
## 簡介
可擴充硬體音訊處理引擎 (SHAPE) 為多種最常見的音訊播放與處理建構區塊提供硬體加速。
遊戲可完全控制 SHAPE 處理區塊的設定與排序,這些區塊由音訊控制處理器 (ACP) 管理。ACP 是一個硬體元件。遊戲會建立已定義的路徑,將一或多個 SHAPE 元件從輸入串連到輸出。這些路徑稱為*流程圖*。建立之後,每個流程圖都會以一系列命令的形式提交給 ACP 處理。
本主題討論建立及提交流程圖的最佳做法,協助您成功實作最常遇到的執行階段案例,並說明為了將效能最大化而應避免的設定。
本主題涵蓋下列內容:
* [SHAPE 元件與功能](#ID4E5B)
* [效能不佳的案例與異常情況](#ID4ETBAC)
* [SHAPE 流程圖規劃與審查](#ID4EEHAC)
* [持續性與非持續性流程圖](#ID4ERIAC)
* [偵錯 SHAPE 問題](#ID4E3JAC)
## SHAPE 元件與功能
將流程圖提交至硬體時,ACP 會自動管理並填入*命令佇列*。
下表列出各元件及其執行個體功能的彙總清單。
| SHAPE 元件 | 描述 | 最大並行執行個體數 | 命令佇列大小 | 每個執行個體的聲道數 | 備註 |
| - | - | - | - | - | - |
| XMA | XMA 解壓縮 | 512 | 不適用:平行 | 1 - 2 (交錯) | 通常路由至 SRC。 |
| SRC | 取樣率轉換 | 512 | 8 | 1 - 2 (交錯) | 從 RAM 取用:XMA 區塊輸出或脈衝編碼調變 (PCM)。 |
| FLT/VOL | 濾波器/音量 | 2560 | 8 | 1 | |
| EQ/CMP | 等化/壓縮器 | 512 | 8 | 1 | |
| MB | 混音緩衝區 | 8192 (128 個實體) | 不適用:平行 | 1 | 在所有其他 SHAPE 元件之後皆為必要,但 XMA 至 SRC 除外。 |
| DMA | 直接記憶體存取 (輸入/輸出) | 取決於記憶體頻寬;少於 4096 | 8 | 1
每次傳輸最多 32 個音訊框架 | 可將 DMA 緩衝區配置為相鄰,以支援往返記憶體的多聲道 DMA 傳輸。 |
| | | | | | |
下表列出各元件及其混音緩衝區路由規則的彙總清單。
\| SHAPE 元件| 每個執行個體的輸入混音緩衝區| 每個執行個體的輸出混音緩衝區|
\| --- | --- | --- | --- | --- | --- | --- | --- | --- |
\| XMA| 不適用。從記憶體讀取。| 不適用。解碼至記憶體,通常由 SRC 取用。|
\| SRC| 0;從記憶體讀取。| 單聲道為 1,立體聲為 2。|
\| FLT/VOL| 1。| 1。|
\| EQ/CMP| 1 (若為側鏈設定則為 2)。| 1。|
\| MB| 不適用。混音緩衝區無法直接從其他混音緩衝區讀取。| 不適用。混音緩衝區無法直接寫入其他混音緩衝區。|
\| DMA| 1;每次傳輸最多 32 個音訊框架。| 1;每次傳輸最多 32 個音訊框架。|
如需 SHAPE 建構區塊的詳細資料,請參閱相關的 Xfest 演講 [The Sound of XBOX One (Conference Material > Xfest 2012)](https://aka.ms/xgddl) 以及白皮書 [The Sound of the Future (Developer Education Materials > All NDA Whitepapers)](https://aka.ms/xgddl)。
### 關於流程圖使用案例的注意事項
許多遊戲可能永遠不會直接實作流程圖。XAudio2 會隱含地實作 SHAPE 元件,而音訊中介軟體可能會為遊戲開發人員抽象化硬體流程圖。不過,建構流程圖可讓您直接利用 XBOX One 主機的音訊加速功能,特別是當您正在開發並實作自己的音訊轉譯解決方案,或擁有 XAudio2 或中介軟體不支援的自訂設定時。
對於您開發的所有遊戲,了解 SHAPE 的功能 (本主題稍後會討論) 並事先規劃可能的流程圖拓撲,都會很有幫助。
## 效能不佳的案例與異常情況
下列各節說明可能造成效能問題的常見案例,並提供避免這些問題的建議。
### 格式錯誤的流程圖
您可能會建立出建構了不可能訊號流程的流程圖,或產生永遠不會在輸出端實現的資料。以下是建立流程圖時最常發生的一些錯誤。
* 參考了尚未建立或配置的 SHAPE 物件
* 無效的命令或參數
* 混音緩衝區輸入/輸出參考計數的正確性
* 重新配置現有的混音緩衝區虛擬 ID
* 在 SHAPE 元件之間遺漏連接的混音緩衝區
* 為 SHAPE 元件使用多個混音緩衝區作為輸出,但 SRC 區塊除外,它在轉譯立體聲內容時可路由至兩個混音緩衝區
除了較明顯的流程圖錯誤 (例如參考了未配置或未建立的 SHAPE 物件) 之外,格式錯誤流程圖最常見的案例包括下列各項:
* 混音緩衝區中的循環參考
混音緩衝區必須等到其所有輸入都已提供且輸出都已取用後才會變成可用。如果混音緩衝區中存在循環參考,該混音緩衝區實際上會有無限多個輸入,永遠不會變成可用,並使圖形停止回應。
* 孤立的混音緩衝區
沒有輸出的混音緩衝區會在其最後一個輸入處理完成時立即變成可用。要轉譯至音訊裝置 (例如喇叭或耳機) 的混音緩衝區,應以 DMA 輸出區塊作為結尾。這樣會將混音緩衝區提供給主記憶體以進行最終混音。
### 命令排序
ACP 會自動為每個 SHAPE 元件填入命令佇列。填入佇列時,ACP 會略過特定元件的後續命令,直到該元件的項目釋出為止。
一般而言,略過命令所造成的效能損失微乎其微。不過,根據命令排序,遊戲可能會建立次佳的 SHAPE 元件排序。這會導致一或多個未滿的佇列必須等待其他佇列。此等待會減少每個框架可用的執行個體數目。
圖 1 示範命令排序可能如何影響效能。最佳做法是依照流程圖所示,由上而下發出 FLT/VOL 命令,而不是由左至右,這樣可以完成更多語音。此方法可讓流程圖底部所示的 EQ/CMP 平行處理。
**圖 1. 此流程圖說明如何由上而下 (而非由左至右) 發出 FLT/VOL 命令,讓 EQ/CMP 能平行處理並提升效能。**
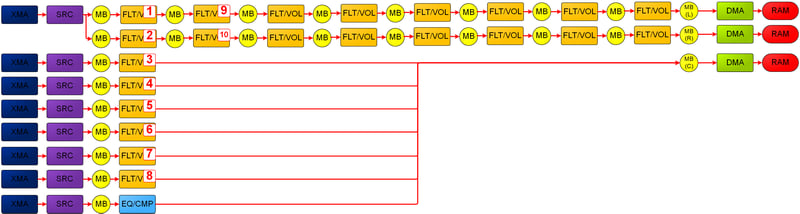 在特定類型的命令之間排序流程圖時,最佳做法是優先沿著語音的處理路徑往深處進行,直到子混音階段或重複使用的 SHAPE 元件為止。接著,對共用相同處理順序的語音優先往廣度進行。
圖 1 顯示,最佳 (也是典型) 的做法是先為最左欄的 FLT/VOL 建立 FLT/VOL 命令,然後再轉向為頂端立體聲語音的兩個聲道建立其餘的 FLT/VOL 命令。
### 混音緩衝區執行個體的配置
混音緩衝區在寫入期間會被鎖定。在所有輸入都已參與混音之前,無法從中讀取任何輸出。從實作的角度來看,混音緩衝區使用 `numIn` 和 `numOut` 欄位來管理此情況。因此,有可能建構出同時需要超過 128 個實體混音緩衝區的案例。
SHAPE 會將混音緩衝區虛擬化,因此即使在高複音數的情況下,此案例通常也不會造成問題。不過,您可能會建構出需要同時存取大量混音緩衝區的流程圖。特別是,在多個語音之間進行子混音或主控混音的混音緩衝區,會一直鎖定到最後一個語音混入其中,並且其最後一個輸出被後續的 SHAPE 區塊取用為止。
在典型案例中 (所有 SHAPE 語音都混入單一 7.1 主控語音),128 個語音中有 8 個會在整個框架期間被鎖定。如果有大量具有流程圖相依性鏈的多聲道子混音,其他混音緩衝區可能會在框架的大部分時間內鎖定 (減少虛擬混音緩衝區的容量)。或者,例如您為四人遊戲同時建立主喇叭混音以及每位玩家各自的 7.1 耳機混音,就會建立額外的主控語音,這可能會占用 40 個並行混音緩衝區。
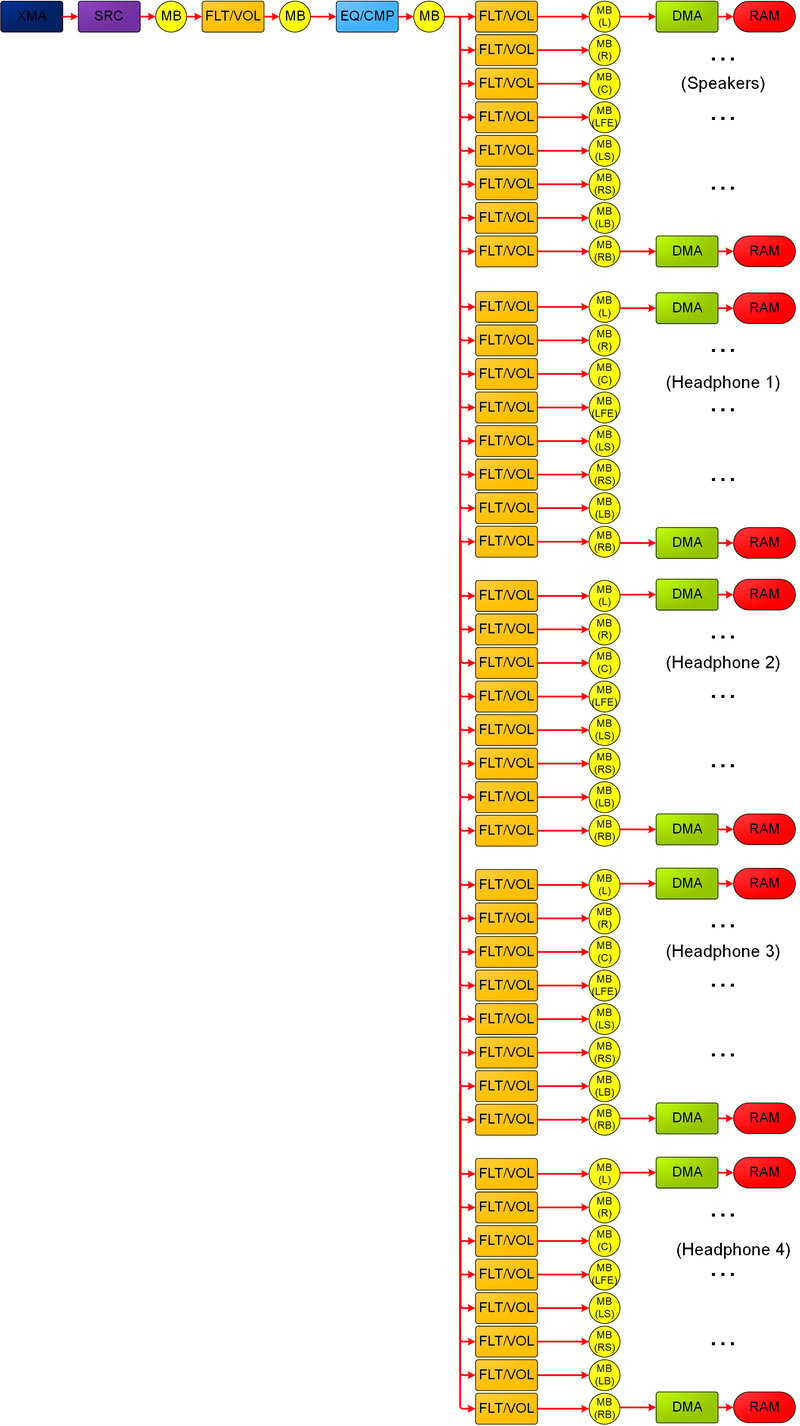
一般而言,需要超過 128 個並行實體混音緩衝區的情況屬於異常情況。不過,在整個框架期間不必要地鎖定混音緩衝區,會降低遊戲達到潛在輸送量的能力。圖 2 呈現了可能減少特定時間可用混音緩衝區數目的不必要子混音。
根據命令排序 (圖 2),5 組獨立的 7.1 主控混音緩衝區可能會在幾乎整個框架期間被鎖定,這代表 128 個實體混音緩衝區中的 40 個。雖然此路徑同時只需要使用另外 2 個混音緩衝區 (也就是 FLT/VOL 或 EQ/CMP 的成對輸入與輸出),但請考慮先處理所有進入喇叭的混音緩衝區。然後您可以釋放這些混音緩衝區,再處理耳機 1、2 等。
**圖 2. 此流程圖顯示因命令排序不佳而造成不必要的子混音,以及已配置的混音緩衝區執行個體遭到鎖定。**
 ### SHAPE 元件的選擇與平衡 (FLT/VOL 與 EQ/CMP)
如果您依序重複使用相同的 SHAPE 元件,可能會降低達到最大輸送量的能力。相較之下,交替使用不同的元件,可確保每個 SHAPE 區塊都在進行有意義的平行處理。
圖 3 顯示一個常見範例:FLT/VOL 無法全部平行處理。效能可能會因此受到影響。
**圖 3. 此流程圖顯示嘗試平行處理所有 FLT/VOL。**
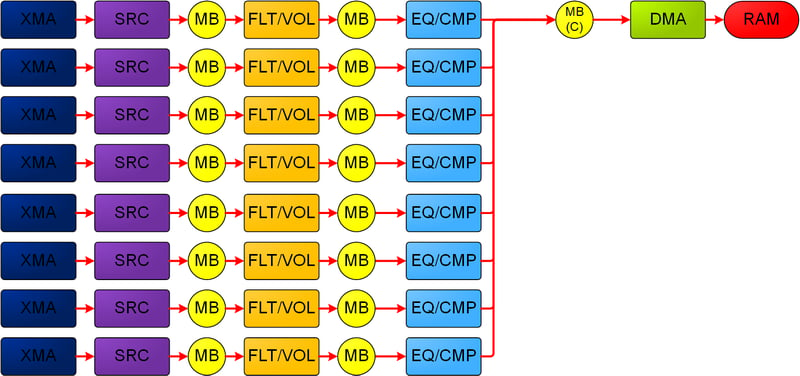
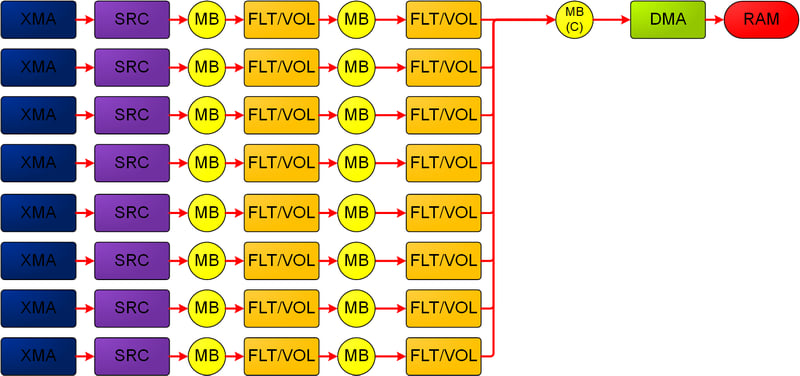 第二組 FLT/VOL 必須等待第一組完成,而在此期間其他 SHAPE 區塊可能處於閒置狀態。如果任一組僅用於濾波,那麼對其中一組使用 EQ/CMP 可能是更好的選擇,特別是當具有相同設定的流程圖 (圖 4) 有更多語音時。如此一來,在第一組處理其 EQ/CMP 區塊的同時,這些語音就能開始進行其 FLT/VOL。
圖 4 顯示的效能更接近 SHAPE 的理想能力。此流程圖將一組假設僅用於濾波的 FLT/VOL (請參閱圖 3) 取代為 EQ/CMP,讓這兩種 SHAPE 元件可以平行處理。
**圖 4. 此流程圖顯示嘗試平行處理 FLT/VOL 與 EQ/CMP。**
 考量各元件的最大執行個體數時,SHAPE 元件的平衡也很重要。一個框架內可出現 2560 個 FLT/VOL 元件,這讓 FLT/VOL 硬體能執行的計算量約為 512 個 EQ/CMP 區塊的五倍。
如果將一個 EQ/CMP 區塊與單一 FLT/VOL 串聯執行,所獲得的效能會低於執行多個搭配一個 EQ/CMP 的 FLT/VOL 元件,因為前者的處理會受到後者取用速度的限制。
### 過多或頻繁的低價值 DMA 往返
DMA 受限於 SHAPE 匯流排可用的讀取/寫入頻寬。如果您用盡所有可用頻寬 (雖然此案例通常屬於異常情況),DMA 區塊將會停滯並降低輸送量。
如先前所述,DMA 輸入區塊之後的所有處理都必須等到 DMA 完成。因此,您可能會建立出大部分都被封鎖、必須等待 DMA 完成後才能開始處理的流程圖。
您也應該評估 DMA 往返對音訊串流所帶來的價值。對大多數音訊播放案例而言,所增加的少量延遲 (您可以透過 DMA 存取的框架數目來控制,以 2.667 毫秒音訊框架大小的倍數為單位) 可能不是問題。這是因為 DMA 右側的區塊將處理先前框架的音訊資料。特別是,當您同時打算將最終混音透過 DMA 送回記憶體以提供給音訊端點時,僅為了執行最終混音而將 DMA 送回 SHAPE 可能是不必要的。
圖 5 顯示一個可能價值較低的範例:一個透過 DMA 送至記憶體以進行 CPU/GPU 處理的語音被帶回 SHAPE,只為了以 7.1 聲道定位混入主控混音中。然後,該語音再透過 DMA 送回記憶體。圖 5 假設 FLT/VOL 區塊中的語音未套用任何濾波,且 7.1 主控混音緩衝區還有其他語音路由至其中。
**圖 5. 此流程圖顯示一個可能價值較低的路由,其中包含不必要的 FLT/VOL 元件和不必要的 DMA 往返。**
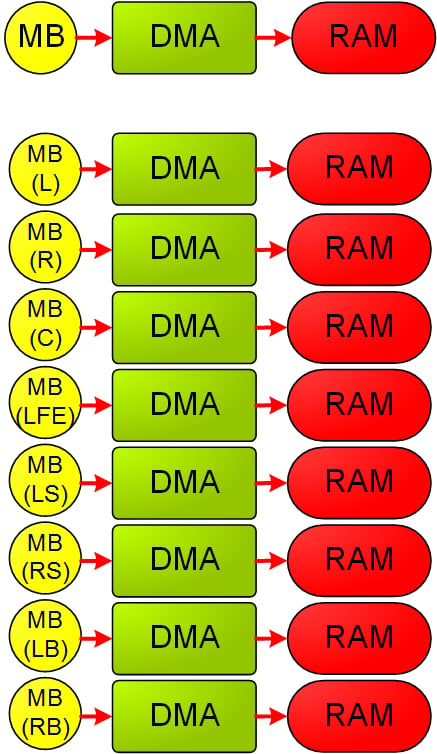
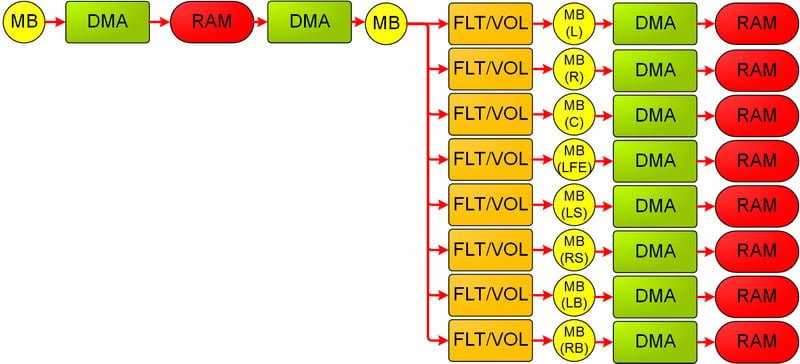 圖 6 針對圖 5 的意圖顯示可能更佳的路由。語音透過 DMA 送至記憶體以進行 CPU/GPU 處理。接著,可以直接在 CPU 上對該語音進行 7.1 聲道定位,並與其餘的 7.1 混音合併,而不需要額外 DMA 的負擔、額外的音訊框架延遲,或使用七個 FLT/VOL 元件。
**圖 6. 此流程圖顯示更佳的路由,沒有額外的 DMA 往返或不必要的 FLT/VOL 元件。**
 從流程中移除 DMA 時,請確保不要移除過多。如果符合下列情況,使用往返 DMA 是合理的:
* 打算對特定語音執行大量額外的 SHAPE 處理。
* 想要利用混音緩衝區所提供的硬體計量與削波偵測功能。
## SHAPE 流程圖規劃與審查
作為一項練習,在實作之前,請以視覺化方式呈現您預期在一個框架內使用語音的流程圖,並將語音分類與量化,例如以音效數目和並行音樂串流數目來表示。
以視覺化方式擷取此資訊,有助於您了解如何避免先前討論的一些效能陷阱。以下是您可以從此類流程圖推導出的一些關鍵指標。
* 每種 SHAPE 元件在並行狀態下及整個框架內的最大數目:
* 確認此流程圖充分低於理論峰值。
* 注意元件的使用不足與過度使用情況。視需要重新平衡元件。
* 如果有太多混音緩衝區必須在流程圖的大部分過程中保持鎖定,請考慮重新調整混音緩衝區的使用方式。
* 規劃透過 SHAPE 實作 3D 定位:
* 所有語音都會以 7.1 聲道定位,還是會在 2 個或 *n* 個最近的喇叭之間定位?
* 所有 7.1 聲道定位都應在 SHAPE 中完成,還是已透過 DMA 送至 CPU 的語音最好直接在 CPU 上定位?
* 往返記憶體的 DMA 轉換次數,以及這些轉換是否不對稱。例如,某些語音寫入和寫出 SHAPE 的次數比其他語音多,這表示它們可能會有額外的延遲。
建構流程圖也可以作為音訊設計師與引擎或音訊中介軟體開發人員之間討論的依據,以確保動態或靜態建立的圖形能正確建立並依需求路由。
## 持續性與非持續性流程圖
您可以將流程圖提交為持續性或非持續性處理。
持續性流程圖在處理後會保持常駐,並在讀取和寫入指標前進且其他內容資訊更新後,於下一個框架中重複其處理。請在下列任一案例中使用持續性流程圖。
* **高度複雜的流程圖:** 每個框架都需要大量 CPU 處理才能重新組合的流程圖
* **高度靜態的流程圖:** 長時間維持相同語音數目與設定的流程圖
請在下列任一案例中使用非持續性流程圖。
* 語音拓撲經常變更。
* 遊戲音訊軟體引擎的處理節奏與 SHAPE 硬體脫鉤;也就是說,不是 2.667 毫秒的倍數。
* 您想要在快於即時的案例中執行音訊處理;也就是說,當您提交圖形以便在其可用時盡快取用時。
## 偵錯 SHAPE 問題
我們建議您在開發流程圖時,註冊可協助您偵錯問題的訊息。具體來說,請使用 [IAcpHal::Connect](/zh-TW/reference/audio/acphal/interfaces/IAcpHal/methods/iacphal_connect) 方法的 `NumMessages` 參數。
訊息系統會針對各種問題提供豐富的意見反應,包括無效的流程圖 (例如 [ACP\_FLOWGRAPH\_TERMINATED\_REASON\_INVALID\_GRAPH](/zh-TW/reference/audio/acphal/enums/acp_flowgraph_terminated_reason))、遭封鎖的命令,以及因嘗試執行超過 2.667 毫秒硬體框架大小所允許的處理量而造成的框架逾時。
此方法有助於偵錯。不過,在遊戲發行之前,請嘗試執行下列動作:
1. 從執行階段案例中消除所有表示錯誤的訊息。
2. 針對每個已提交的流程圖檢查 `ACP_MESSAGE_TYPE_FLOWGRAPH_COMPLETED` 訊息 (請參閱 [ACP\_MESSAGE\_TYPE](/zh-TW/reference/audio/acphal/enums/acp_message_type) 列舉),以確認流程圖處理持續成功。
### 遺漏的訊息
如果您使用 ACP 訊息來驅動引擎狀態,且需要處理大量訊息,則應在開發期間檢查 `ACP_MESSAGE::droppedMessageCount`。非零值表示訊息佇列已滿,必須捨棄訊息。如果出現此值,請考慮加快處理佇列的速度並將其加大。
### 框架逾時
在開發期間,由於預算超支、流程圖次佳及其他原因,流程圖可能無法在音訊框架 (2.667 毫秒) 結束前完成。對於持續性流程圖,此未完成的流程圖會產生 `ACP_FLOWGRAPH_TERMINATED_TIME_EXCEEDED` 訊息。它們將不會完成。相反地,非持續性流程圖不受此方式限制,會一直執行到完成為止,即使跨越多個框架也一樣。
### 遭封鎖的命令
在下表所示的數種案例中,SRC 和 DMA 命令可能會被回報為遭封鎖 (`ACP_MESSAGE_TYPE_SRC_BLOCKED` 和 `ACP_MESSAGE_TYPE_DMA_BLOCKED` (請參閱 [ACP\_MESSAGE\_TYPE](/zh-TW/reference/audio/acphal/enums/acp_message_type) 列舉))。
| 命令類型 | 回報遭封鎖的案例 | | |
| - | - | - | - |
| XMA SRC | 相關聯的 XMA 內容發生剖析器錯誤或沒有來源資料 (錯誤:`SHAPE_XMA_ERROR_STATUS_READ_BUFFER_INVALID_VALIDBUFFER_CURRBUF_IS_0` | `SHAPE_XMA_ERROR_STATUS_FRAME_CROSSES_BOUNDARY_INTO_INVALID_READ_BUFFER_VALIDBUFFER_CURRBUF_IS_0` | `SHAPE_XMA_ERROR_STATUS_FRAME_CROSSES_BOTH_READ_BUFFER_BOUNDARIES`)。
XMA SRC 不會因為缺少已解碼的資料而遭封鎖。 |
| PCM SRC | 相關聯的 PCM 內容為 `SHAPE_PCM_MODE_CIRCULAR`,且沒有來源資料。 | | |
| 讀取 (從混音緩衝區進行 DMA) | DMA 緩衝區已滿。 | | |
| 寫入 (DMA 至混音緩衝區) | DMA 緩衝區是空的。 | | |
確定命令遭封鎖後 (可能發生在項目加入 SHAPE 佇列進行處理之前,也可能發生在執行階段),命令就會從圖形中移出。這可能會導致音訊遺失。在開發期間,請將遭封鎖的命令作為改善流程圖處理的首要檢查之處。在發行之前,您的遊戲也應防止命令遭封鎖。
您可以確保音訊緩衝區夠大,並根據緩衝區大小以固定間隔串流資料,來防止 DMA 命令遭封鎖。例如,如果您一次串流四個硬體框架,請確保緩衝區中有這些框架的某個倍數 (至少是雙重緩衝的八個),讓硬體能在遊戲的讀取指標之前寫入。或者,您也可以在提交下一個流程圖之前強制清空緩衝區,方法是先取用資料、更新 DMA 讀取指標,然後再提交流程圖。
SRC 命令有下列三種模式 (詳見 *ShapeSrcContext.h*)。
* `SHAPE_SRC_COMMAND_TYPE_START`
幾乎所有流程圖中的 SRC 命令都使用此模式。正常處理,並預期在目前流程圖之後還有更多音訊資料。
* `SHAPE_SRC_COMMAND_TYPE_STOP_IMMEDIATE`
用於立即停止處理來源 XMA 或 PCM 資料。SRC 會為此框架輸出歸零的緩衝區。
* `SHAPE_SRC_COMMAND_TYPE_STOP_END`
用於表示語音的最後一個封包。如果未以 `STOP_END` 或 `STOP_IMMEDIATE` 提交,SRC 命令將不會完成。這會導致作用中的流程圖停滯。持續性流程圖會在音訊框架結束時終止,而非持續性流程圖則永遠不會完成。
### 同步處理問題
如果您未遵循 SHAPE 硬體對內容與命令的取用方式,可能會產生許多同步處理問題。雖然您的遊戲仍保有對 ACP 配置記憶體的完整存取權,但請注意不要在內容結構使用中時修改它。您可以提交命令 (請參閱 [IAcpHal::SubmitCommand](/zh-TW/reference/audio/acphal/interfaces/IAcpHal/methods/iacphal_submitcommand)),使其在特定框架、下一個框架開始時,或盡快執行。
對於最後一種案例 (盡快執行的命令),請注意*盡快*仍然與遊戲的任何 CPU 處理非同步。某些命令可能不會立即完成,例如當內容正處於不可中斷的作業中時。請等待 [ACP\_MESSAGE\_TYPE\_COMMAND\_COMPLETED](/zh-TW/reference/audio/acphal/enums/acp_message_type) 訊息,以確認命令確實已處理。
## Related topics
- [RTA 服务的最佳做法](/zh-CN/services/xbox-services/fundamentals/rta/concepts/live-rta-best-practices.md)
- [PlayFab 消费最佳做法](/zh-CN/services/playfab/pricing/consumption-best-practices.md)
- [SHAPE 音频流程图构建最佳实践](/zh-CN/build/console-features/audio/overviews/best-practices-audio-flowgraph-construction.md)
- [XR-003 提交的遊戲品質](/zh-TW/publishing/certification/xr/xr-003.md)
- [XBOX 遊戲的 XBOX 需求](/zh-TW/publishing/certification/xbox-requirements.md)