> ## Documentation Index
> Fetch the complete documentation index at: https://devdocs.xbox.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Práticas recomendadas para traçado de raios no XBOX Series X|S
> Práticas recomendadas para traçado de raios no XBOX Series X|S
Este tópico descreve as práticas recomendadas para traçado de raios no XBOX Series X|S.
O traçado de raios é uma técnica de renderização viável no XBOX Series X|S há mais de um ano, e aprendemos muito sobre como obter o desempenho máximo com o hardware do XBOX. Este tópico resume o que aprendemos de mais importante e fornece dicas, truques e práticas recomendadas para desenvolver jogos de alta qualidade com traçado de raios no XBOX Series X|S.
Estas informações estavam atualizadas em abril de 2022. Vários recursos foram alterados ou atualizados desde então.
## Traçado de raios no XBOX Series X|S
Temos visto uma ótima adoção da funcionalidade de traçado de raios nos consoles XBOX Series. Hoje, mais de 20 títulos são lançados com suporte a traçado de raios no XBOX Series X. Vários desses títulos passaram a oferecer suporte a traçado de raios no XBOX Series S. Efeitos simples, como sombras e oclusão de ambiente, são comuns, e alguns títulos também implementaram reflexos e iluminação global.
No Xfest 2019, o GDK de novembro de 2019 tinha acabado de ser lançado e nenhum título estava sendo executado com traçado de raios. No final de 2020, havia apenas três títulos sendo executados no GDK de agosto de 2020. Desde então, várias melhorias foram feitas no runtime. Agora temos uma compreensão muito melhor do que é necessário para obter um bom desempenho de traçado de raios em nossos consoles.
## Construtor de BVH em runtime
O *construtor de BVH* (hierarquia de volumes delimitadores) *em runtime* é executado na GPU, portanto consome tempo de GPU que, de outra forma, seria usado para rasterização ou traçado de raios. Até hoje, todos os títulos usam o construtor de BVH em runtime para construir sua Top-Level Acceleration Structure (TLAS). Eles fazem reconstruções completas a cada quadro, portanto não tente atualizar uma TLAS. Para as Bottom-Level Acceleration Structures (BLAS), cerca de metade dos títulos ainda usa o construtor de BVH em runtime para geometria estática. A outra metade usa o construtor de BVH offline. Para geometria dinâmica, todos os títulos continuam usando o construtor de BVH em runtime, pois é a única opção.
O desempenho de tempo de construção do construtor de BVH em runtime é excelente já de início. Ele foi comparado com GPUs da NVIDIA e da AMD no PC e apresenta ótimo desempenho. Os desenvolvedores disseram que queriam uma API de construção explicitamente em lote, na qual várias estruturas de aceleração são construídas simultaneamente para melhor desempenho de GPU. O feedback dos desenvolvedores é que o desempenho aumentou pelo menos 10 vezes, se não 20 vezes. Para entender de onde vêm esses aumentos de velocidade, é importante entender como o construtor de BVH em runtime funciona.
Construir uma BVH não é um único dispatch, nem mesmo dois dispatches. É uma série de muitos dispatches, todos executados um após o outro com barreiras de unordered access view (UAV) entre eles. Ao fornecer todas as suas construções de nível inferior em uma única chamada de API, elas podem ser agendadas de forma mais eficiente e reduzir o número de barreiras de UAV nessa fase.
**Figura 1. Slide 8.**
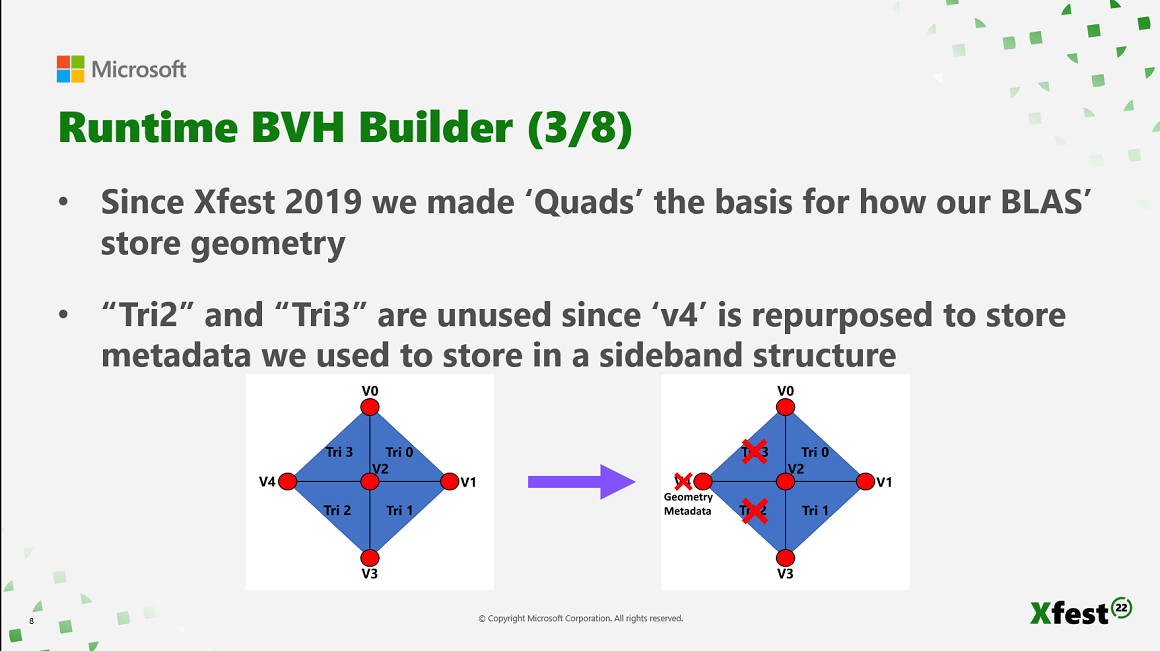 Desde o Xfest 2019, mudamos a forma como a travessia funciona. Os quads são a base de como a BLAS armazena a geometria. No Xfest anterior, o triângulo 2 (Tri2) e o triângulo 3 (Tri3) do nó da AMD ainda eram usados e eram fornecidos no hardware, conforme mostrado na figura 1. Alguns metadados auxiliares eram armazenados na BVH e carregados explicitamente durante a travessia. Ao abrir mão do uso de Tri2 e Tri3, o vértice 4 agora pode armazenar metadados de geometria. Agora, quando é necessário acessar esses dados, é mais provável que estejam no cache, o que proporciona melhor desempenho.
Essa foi principalmente uma otimização de desempenho, mas teve como custo BLAS um pouco maiores na memória do que se Tri2 e Tr3 fossem usados. O construtor em runtime forma quads a partir de pares de triângulos adjacentes na lista. A primeira thread verifica se o primeiro e o segundo triângulos formam um quad, a segunda thread verifica o terceiro e o quarto triângulos, a terceira thread verifica o quinto e o sexto triângulos, e assim por diante. Cada thread verifica se os triângulos \_N\_ésimo e \_N\_ésimo+1 podem formar um quad e, portanto, usar Tri0 e Tri1 em um nó folha.
**Figura 2. Slide 10.**
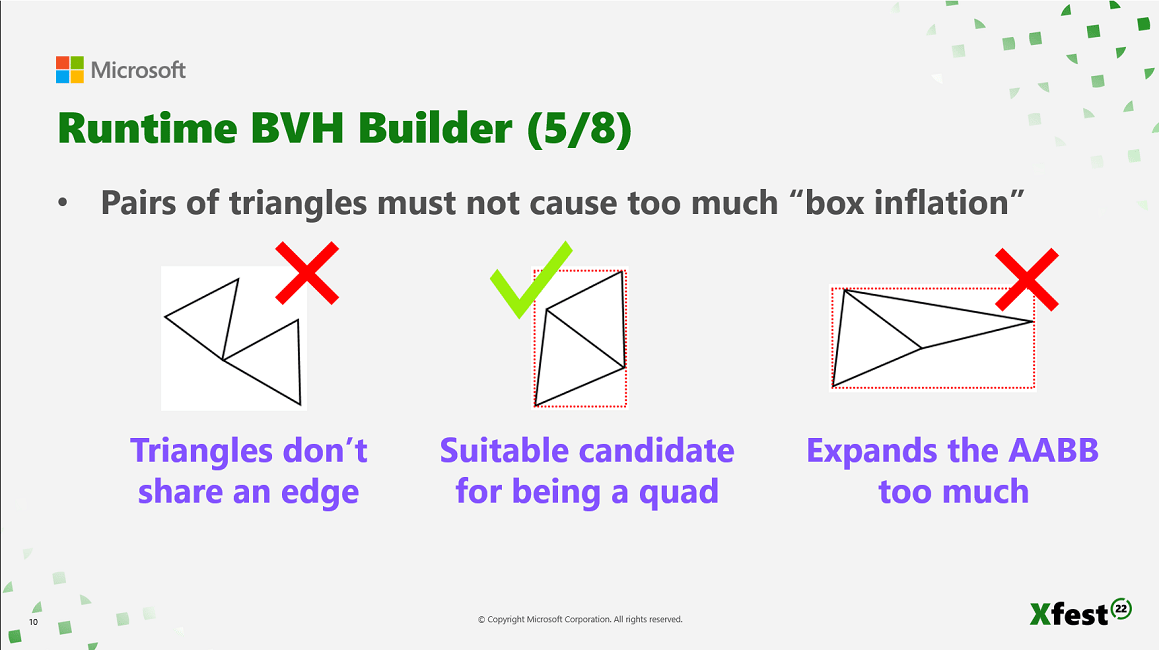 No diagrama à esquerda na figura 2, os dois triângulos não compartilham uma aresta, portanto não formam um quad. No meio, há dois triângulos que formam um quad. Eles se aproximam de um retângulo, e é um quad adequado. No lado direito, os dois triângulos formam um quad. No entanto, a inflação da AABB que os contém é significativa demais. Isso seria rejeitado como quad e, em vez disso, haveria um único triângulo em cada nó.
A tolerância permitida de inflação da caixa é controlada pelo limite de formação de quads. Quanto maior o limite, mais agressiva é a tentativa de formar quads a partir desses dois triângulos. Isso produz BVHs menores, pois há menos nós de triângulo, mas tem como custo uma travessia com desempenho inferior. Por outro lado, se você definir o limite como baixo, só transformará dois triângulos em quad se eles se aproximarem da forma de um retângulo ou de um quad, o que produz BVHs maiores, mas potencialmente melhora o desempenho da travessia.
Usar computação assíncrona para construir suas BVHs não é obrigatório, mas é um grande ganho de desempenho. Muitas dessas construções, em especial as de nível superior, não usam toda a largura da GPU, especialmente no XBOX Series X, com seus 26 WGPs/52 CUs. Ao executar a API de construção em lote e a computação assíncrona, você pode efetivamente ocultar o custo da maior parte da construção de suas BVHs. No caso de um título, os desenvolvedores construíram uma TLAS de 1,5 milissegundo quase de graça, movendo-a para a computação assíncrona. Se for possível começar a construir estruturas de aceleração muito antes de serem necessárias no quadro, elas podem ser candidatas ideais para a computação assíncrona.
As construções de nível superior e de nível inferior têm uma série de sinalizadores com os quais você já deve estar familiarizado por trabalhar no PC. Na construção, esses sinalizadores controlam dois sistemas diferentes. Um deles é a agressividade com que as AABBs FP16 são usadas nas BVHs. O segundo é o quanto o processo chamado *reconstrução de treelets* é executado na BVH. Esses dois aspectos podem ser configurados usando a API em lote [BuildRaytracingAccelerationStructureBatched2X](/pt-BR/reference/graphics/d3d12_xs/interfaces/ID3D12GraphicsCommandList6/methods/id3d12graphicscommandlist6_buildraytracingaccelerationstructurebatched2x).
É importante entender que a GPU AMD RDNA 2 dá suporte tanto a AABBs FP16 quanto a AABBs FP32. Não é uma decisão de tudo ou nada. A construção gera BVHs com AABBs FP16 e FP32 em uma única BVH. As AABBs FP16 têm metade do tamanho das AABBs FP32, o que melhora as taxas de acerto de cache. Elas devem ser infladas de forma conservadora para garantir que contenham toda a geometria dentro delas. A quantização de FP32 para FP16 torna essas caixas maiores, dependendo dos valores. Isso pode ser configurado usando o membro de limite de inflação de caixa FP16 e a API [FP16BoxInflationThreshold](/pt-BR/reference/graphics/d3d12_xs/structs/d3d12xbox_build_raytracing_acceleration_structure_params1). Quanto mais baixo você definir esse limite, mais caixas FP32 serão usadas. Mais memória é usada para essas BVHs. No entanto, os limites mais justos proporcionam um desempenho de travessia mais rápido. Por outro lado, se você definir esse limite como alto, serão usadas mais AABBs FP16, menos memória será usada, os limites serão mais folgados e o desempenho da travessia será menor.
### Reconstrução de treelets
O construtor em runtime usa BVH linear (LBVH). Ela é fácil de paralelizar e é uma boa candidata para implementação na GPU. Em sua forma bruta, a qualidade de uma LBVH pode ser ruim. Para melhorar a qualidade dessas BVHs, é executado um processo de pós-reconstrução de treelets. Se você tiver interesse nos detalhes, consulte [Fast Parallel Construction of High-Quality Bounding Volume Hierarchies](https://research.nvidia.com/sites/default/files/pubs/2013-07_Fast-Parallel-Construction/karras2013hpg_paper.pdf). Esse processo permuta subárvores da BVH para melhorar a heurística de área de superfície. Isso, por sua vez, melhora o desempenho da travessia.
### Top-level Acceleration Structure Pull Up (TAPU)
Outra opção na ordem da BVH em runtime, no que diz respeito à TLAS, é o *Top-level Acceleration structure Pull Up (TAPU)*. Na TLAS, há limites de instância grandes e sobrepostos. As câmeras costumam estar dentro de instâncias, portanto as origens dos raios ficam dentro dos limites das instâncias. Como resultado, torna-se difícil para o código de travessia seguir o melhor caminho pela BVH durante a travessia. O hardware testa o raio contra quatro caixas simultaneamente e retorna esses quatro acertos ordenados por distância. Se os raios estiverem dentro das quatro caixas, a distância até a interseção em todos os casos é zero. A ordem retornada é desconhecida, mas você precisa de limites de instância bem ajustados à geometria. É aqui que a otimização TAPU se aplica e melhora a situação.
**Figura 3. Slide 17.**
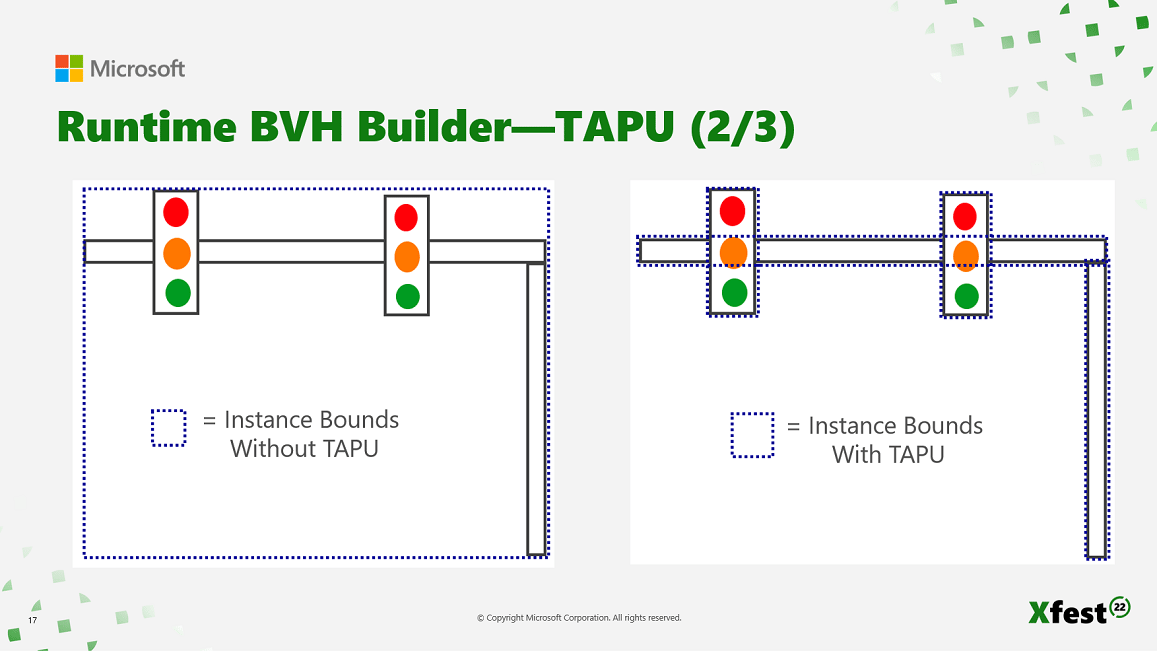 A figura 3 mostra uma estrutura de uma série de semáforos montados em um poste vertical que pende de um poste horizontal. No lado esquerdo, as caixas azuis pontilhadas são os limites de instância. Toda essa estrutura é uma BLAS, e esses são os limites de instância. Há espaço para os raios passarem pela parte inferior, em espaço vazio. No lado direito, não há.
**Figura 4. Slide 18.**
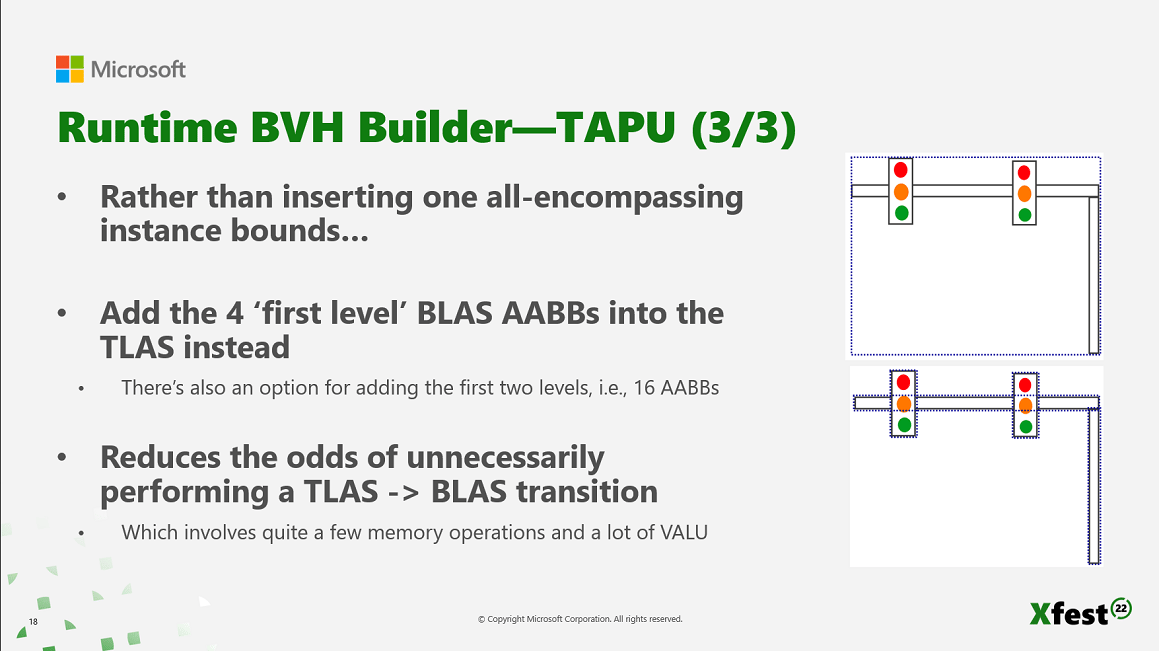 Na figura 4, a instância superior está contida em uma única caixa. Isso vai para o primeiro nível da BLAS. Você também pode descer dois níveis e observar as primeiras 16 caixas, conforme mostrado na ilustração inferior. Essas caixas são extraídas e, em seguida, puxadas para cima, para a TLAS, daí o nome TAPU. Isso significa que os raios que passam por baixo do semáforo, que antes teriam cruzado os limites da instância, não fazem mais isso. Nenhum código que teria sido executado nessa transição da TLAS para a BLAS precisa mais ser executado.
## Construtor de BVH offline
O *construtor de BVH offline* não estava disponível quando o XBOX Series X|S foi lançado, mas foi adicionado em 2020. Se você lançou seus títulos no PC, usou a API padrão para construir BVHs. O formato da BVH é completamente opaco para você, como desenvolvedor. Não há como construir suas BVHs offline, colocá-las em um disco óptico ou em seu download digital e fazer com que os clientes baixem BVHs pré-construídas. Há uma API no PC com a qual você pode construir uma BVH em runtime, armazená-la em cache em um disco rígido e depois carregá-la novamente. Como a velocidade do disco rígido pode ser baixa e essas BVHs podem ser invalidadas por atualizações de driver, o valor de fazer isso é bem baixo.
Como os consoles XBOX Series são plataformas fixas e têm armazenamento SSD de alta velocidade, podemos construir nossas BVHs offline e depois distribuí-las no SSD. Da mesma forma que podemos distribuir texturas pré-swizzled para o XBOX Series X|S, também podemos pré-construir nossas BVHs.
O GDK de maio de 2020 adicionou suporte ao construtor de BVH offline. É um processo executado na CPU, não na GPU. O processo é executado em um PC com Windows, e não no console. O construtor de BVH offline é um construtor de nível internacional criado com base na tecnologia líder de mercado Intel Embree. Trabalhamos com essa tecnologia e podemos converter uma BVH construída pelo Intel Embree em uma BVH pronta para o hardware do XBOX Series X|S. Nenhum processamento adicional é feito em runtime para usar essa BVH depois que ela é carregada. Atualmente, ele só é usado para BLASs. Nenhum desenvolvedor pediu ainda para construir uma TLAS offline. Não há muito valor em fazer esse tipo de construção.
Quando lançamos originalmente o construtor de BVH offline em maio de 2020, não oferecíamos suporte a construções com `BUILD_FLAG_ALLOW_UPDATE`. Isso significava que qualquer coisa com skinning, como personagens, árvores e grama, não podia ser construída offline, pois não havia como reajustá-las em runtime. Esse sinalizador foi adicionado ao GDK de abril de 2021 por causa do seu feedback. O construtor de BVH offline agora é adequado para qualquer conteúdo não procedural. Por exemplo, geometria cuja aparência você já conhece offline. Esse sinalizador pode não ser adequado se um jogador puder moldar ou esculpir novo conteúdo, pois o desenvolvedor não saberá qual será a aparência dele offline. Esse é agora o único caso em que o construtor de BVH offline não é adequado.
Use essa opção, pois ela não consome seu orçamento de quadro de GPU da mesma forma que o construtor de BVH em runtime. O construtor de BVH offline não só economiza tempo de GPU, mas também produz BVHs de qualidade muito superior em comparação com o construtor de BVH em runtime. O construtor de BVH offline também gera pares de quads quase perfeitos. Ao contrário do construtor de BVH em runtime, em que uma única thread analisava dois triângulos adjacentes, o construtor de BVH offline faz uma pesquisa completa. Se o Triângulo 7 precisar ser emparelhado com o Triângulo 12 para construir o melhor quad, é isso que ele faz. Além disso, nenhuma memória de rascunho é necessária para construtores de BVH offline. Você pode simplesmente carregá-las do disco. Você não precisa alocar memória de rascunho extra no console em runtime para a construção.
O construtor de BVH offline consome apenas parte do seu orçamento de quadro de GPU. Em runtime, chame [CopyRaytracingAccelerationStructure](/pt-BR/reference/graphics/d3d12/interfaces/id3d12graphicscommandlist4/methods/id3d12graphicscommandlist4_copyraytracingaccelerationstructure_public) com o novo sinalizador [D3D12\_RAYTRACING\_ACCELERATION\_STRUCTURE\_COPY\_MODE\_DESERIALIZE](/pt-BR/reference/graphics/d3d12/enums/d3d12_raytracing_acceleration_structure_copy_mode_public). A desserialização, que é apenas um [memcpy](https://learn.microsoft.com/cpp/c-runtime-library/reference/memcpy-wmemcpy), ocorre na linha do tempo da GPU. É muito mais rápida do que fazer uma construção real. No futuro, se você achar esse custo proibitivo, um processo de desserialização na CPU poderá ser adicionado. Ele envolve remover alguns cabeçalhos e fazer algumas alterações. Se você quiser isso, avise-nos.
O construtor de BVH offline produz BVHs de qualidade superior às do construtor de BVH em runtime por causa da divisão de triângulos. As BVHs geralmente incluem triângulos com formatos irregulares e em ângulos incomuns. Podemos melhorar o desempenho adicionando AABBs extras em torno de alguns dos triângulos. Isso reduz a heurística de área de superfície para obter uma travessia mais rápida. Isso aumenta o consumo de memória. Considere isso ao decidir o quão agressivamente deseja aplicar essa otimização.
**Figura 5. Slide 26.**
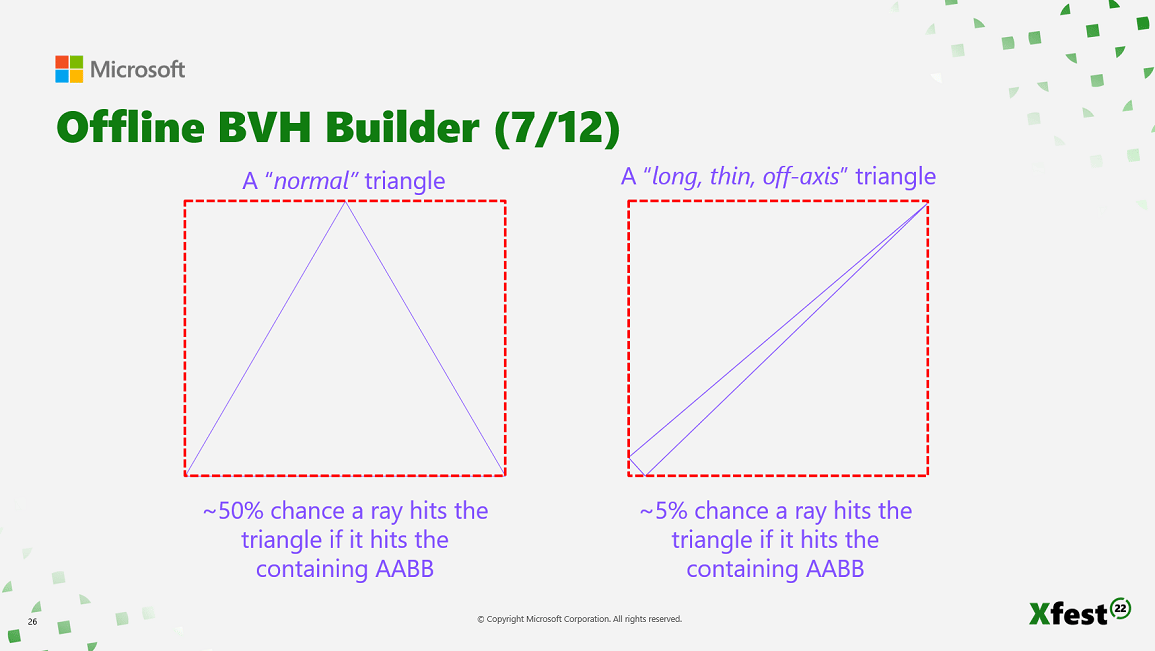 Para explicar o que é a divisão de triângulos e como ela funciona, o triângulo do lado esquerdo da figura 5 é considerado um triângulo normal. Se um raio passar pela caixa vermelha pontilhada, há cerca de 50% de chance de que esse raio atinja o triângulo. Por outro lado, no lado direito da figura 5, há outro triângulo ocupando a mesma AABB. No entanto, há cerca de 5% de chance de que um raio atinja esse triângulo.
**Figura 6. Slide 27.**
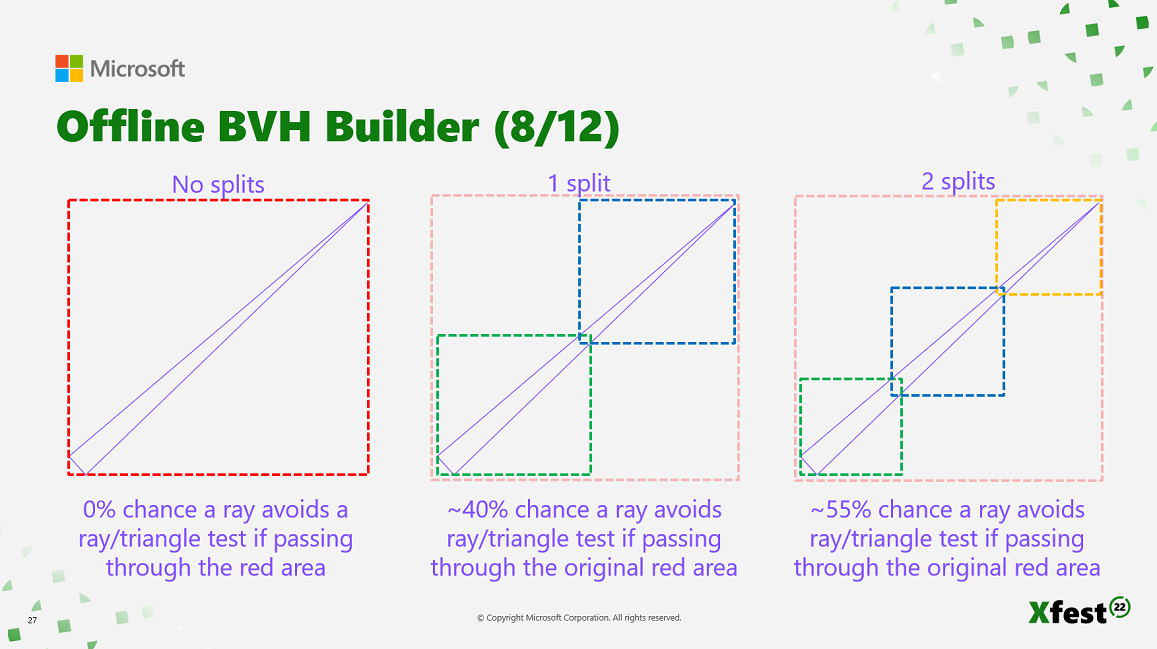 Na figura 6, no meio, temos uma *divisão única*. Em vez de delimitar o triângulo em uma única AABB, ele é delimitado em duas AABBs sem fazer nada com a geometria do triângulo. Se um raio passar por essa mesma caixa vermelha pontilhada, há cerca de 40% de chance de que ele passe sem ser onerado por nenhum teste de triângulo. Isso pode ser melhorado dividindo o triângulo novamente, chegando a ter duas divisões e delimitando o triângulo com três caixas. Quanto mais caixas forem adicionadas, maior a chance de o raio passar pela caixa vermelha pontilhada sem precisar considerar esse triângulo como candidato.
**Figura 7. Slide 28.**
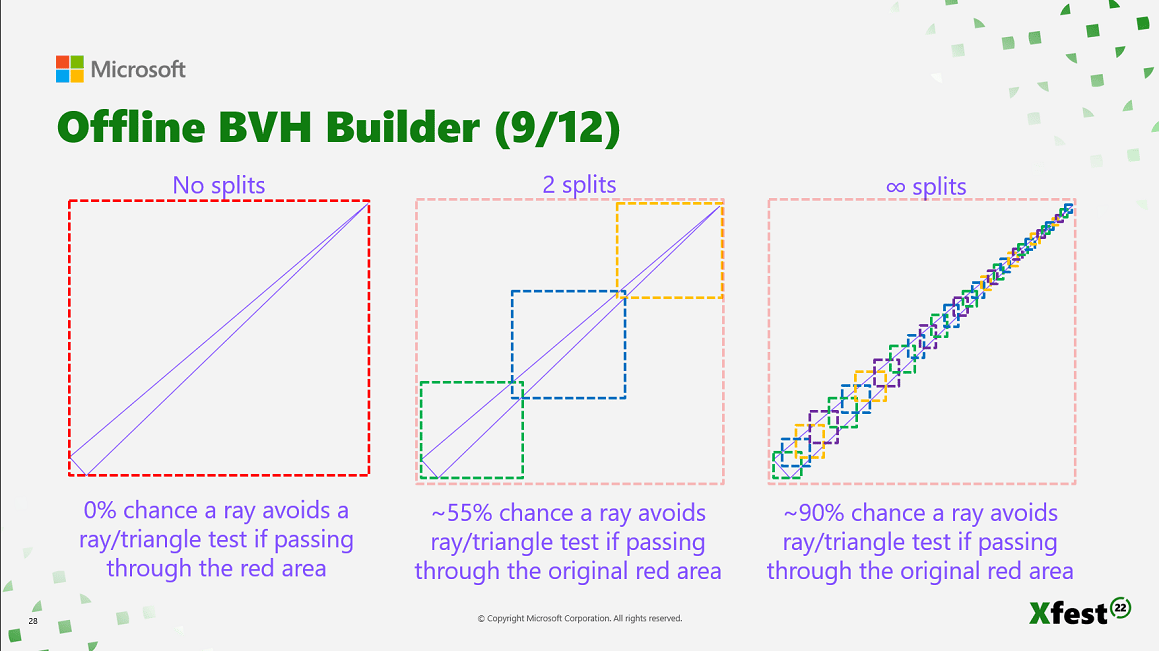 Se mais divisões são melhores, poderia haver um número infinito de divisões que aproximam a forma desse triângulo com um número infinito de AABBs. Eventualmente, a área de superfície do triângulo na figura 7 ficaria próxima da área de superfície do próprio triângulo. Ela não teria sido inflada artificialmente pela AABB que o contém.
Embora mais divisões sejam melhores, as AABBs usam memória, e esse consumo aumenta significativamente. O teste de raio/AABB também tem seus custos. Se você tiver um número infinito de caixas delimitando cada triângulo, precisará fazer um número infinito de testes de raio/AABB. No entanto, o hardware só é capaz de fazer uma quantidade limitada desses testes. O Intel Embree, quando aplica essa otimização, só faz essa divisão onde é necessário. Se ele encontrar um triângulo normal, não o dividirá, pois não há necessidade. O Intel Embree determina se o triângulo longo e fino, posicionado fora do eixo, é candidato a três, quatro, cinco ou mais divisões. Você pode usar [TriangleSplitFactor](/pt-BR/reference/graphics/d3d12_xs/structs/d3d12xbox_build_raytracing_acceleration_structure_params2) para controlar quantas vezes o triângulo é dividido e quanta memória extra ele usa.
As BVHs do XBOX Series X|S têm aproximadamente 120 a 140 bytes por triângulo. Isso vale para a BVH offline e para as BVHs construídas em runtime após a compactação. Aumentar o fator de divisão de triângulos para valores mais altos aumenta o tamanho da BVH em mais 10 a 20%. Infelizmente, ambos os números são três vezes maiores que a BVH da NVIDIA no PC. No entanto, não há muito o que fazer a respeito nesta geração de consoles, pois o hardware do XBOX Series X|S é uma plataforma fixa com uma camada de memória fixa exigida pela instrução de interseção.
Se você tiver um jogo grande com um bilhão de triângulos exclusivos em um mundo aberto, poderá ter cerca de 140 GB de BVHs offline. A compactação tradicional pode proporcionar uma redução de dois para um, mas, para lançar seu jogo, você ainda estará diante de 70 GB, ou um Blu-ray Disc (BD) extra inteiro. Para resolver esse problema de compactação, você pode usar a *compactação de BVH*.
## Compactação de BVH
Os desenvolvedores nos pediram para revisar o tamanho de nossas BVHs. Entregamos uma solução de compactação no GDK de março de 2022. A *compactação de BVH* proporciona uma redução de quatro a seis vezes no tamanho da BVH no disco. Aquele bilhão de triângulos que você quer distribuir em seu título de mundo aberto agora exige apenas 25 GB em vez de 140 GB. Antes que a GPU possa acessar os triângulos, as BVHs compactadas precisam ser descompactadas. Esse é um processo que envolve a CPU. A compactação de BVH não economiza memória no console em runtime; ela permite que você lance jogos menores, com tamanhos de instalação menores.
Uma etapa de compactação baseada em CPU é executada offline em uma máquina de build em um PC com Windows depois que a BVH offline é construída. Uma etapa de descompactação baseada em CPU é executada no console em runtime para deixá-la pronta para a GPU. Se você estiver usando o driver de PC do XBOX Series X|S em um PC com Windows, um novo sinalizador [D3D12XBOX\_RAYTRACING\_ACCELERATION\_STRUCTURE\_COPY\_MODE\_SERIALIZE\_AND\_COMPRESS](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-compression) foi adicionado à API `CopyRaytracingAccelerationStructure`, que solicita serialização e compactação em uma única etapa. Para a descompactação em runtime no console, use a biblioteca XG e a nova função [XGBVHComputer::DecompressBVH](/pt-BR/reference/graphics/xg_xs/interfaces/XGBVHComputer/methods/xgbvhcomputer_decompressbvh_xs). Talvez você já use essa biblioteca para texturas.
Atualmente, a descompactação em runtime é feita apenas na CPU e em uma única thread, pois os desenvolvedores geralmente não querem que façamos nosso próprio multithreading. Supondo uma taxa média de compactação de 5:1, uma entrada de 250 a 360 MB por segundo lida do SSD resulta em uma saída de 1,2 a 1,8 GB por segundo. Como o SSD pode ler dados a até 2 GB por segundo, uma única thread não acompanhará a taxa de descompactação necessária. Se a descompactação de BVHs na CPU se tornar um gargalo para o seu carregamento, considere usar mais threads. Você pode descompactar BVHs facilmente em 1, 2, 3 ou 4 threads ao mesmo tempo para acelerar seus tempos de carregamento.
## DXR 1.0 + extensões
No XBOX Series X|S, o DXR 1.0 (DirectX Raytracing) compatível com PC tem suporte da mesma forma que quando foi lançado, há vários anos. A única omissão significativa é a API de sombreadores chamáveis (Callable shaders). Houve poucas solicitações de desenvolvedores para essa API. O DXR 1.0 é frequentemente usado por desenvolvedores que já criaram títulos com traçado de raios para PC com Windows, onde o traçado de raios já funciona, e agora querem que ele também funcione no XBOX Series X|S. Embora não fosse o caso quando o XBOX Series X|S foi lançado, muitos desenvolvedores relataram que essa opção funcionou de imediato. Eles pressionaram F7 e depois F5. O jogo foi executado e eles tinham traçado de raios.
Embora executar um título DXR 1.0 nos consoles XBOX Series funcione (e funcione há algum tempo), esse não será o caminho para o desempenho ideal. Se você quiser lançar seu título com DXR 1.0, talvez precise dedicar tempo extra tentando otimizá-lo para o XBOX Series X|S. As extensões mostradas na figura 8 facilitam isso.
**Figura 8. Slide 39.**
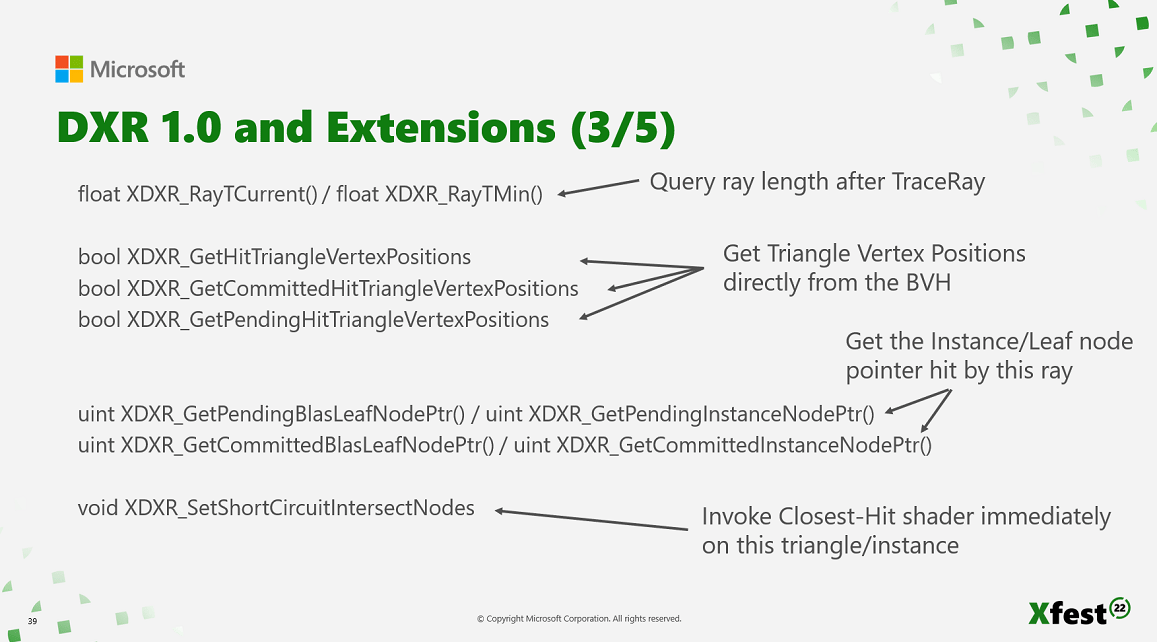 Essas extensões são agrupadas em várias categorias.
Para consultar o comprimento do raio depois que [TraceRay](https://learn.microsoft.com/windows/win32/direct3d12/traceray-function) for concluído, use:
* [XDXR\_RayTCurrent()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
* [XDXR\_RayTMin()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
Para retornar as posições dos vértices do triângulo atingido, para uma interseção confirmada ou pendente, use:
* [XDXR\_GetHitTriangleVertexPositions()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
* [XDXR\_GetCommittedHitTriangleVertexPositions()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
* [XDXR\_GetPendingHitTriangleVertexPositions()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
Para obter o ponteiro do nó de instância/folha atingido pelo raio, use:
* [XDXR\_GetPendingBlasLeafNodePtr()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
* [XDXR\_GetPendingInstanceNodePtr()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
* [XDXR\_GetCommittedBlasLeafNodePtr()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
* [XDXR\_GetCommittedInstanceNodePtr()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
Para invocar o sombreador de acerto mais próximo imediatamente no triângulo/instância, use:
* [XDXR\_SetShortCircuitIntersectNodes()](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr)
No DXR 1.0 no XBOX, várias informações são retornadas depois que a chamada `TraceRay` é concluída. Você não precisa usar um sombreador de erro (miss) ou um sombreador de acerto mais próximo para colocar essas informações de volta no payload do raio. Para efeitos como sombras ou oclusão de ambiente, você precisa saber se houve um acerto. Você não precisa saber as informações difusas ou as coordenadas baricêntricas. Tudo o que você precisa é de um sim ou não binário. É desnecessário executar um sombreador de erro ou um sombreador de acerto mais próximo e ter um payload de 4 bytes para determinar o que seria um único bit. Duas dessas extensões podem ser chamadas depois de `TraceRay`. Você pode obter o comprimento final do raio e compará-lo ao comprimento original para ver se houve um acerto. Você também pode ler as três posições de vértice do acerto confirmado. Em vez de associar o buffer de vértices que contém as posições à chamada DispatchRays e depois ler da sua própria estrutura de dados, essas posições de vértice vêm diretamente da BVH. Isso pode economizar memória. Você pode se livrar da sua cópia do buffer de vértices.
**Figura 9. Slide 41.**
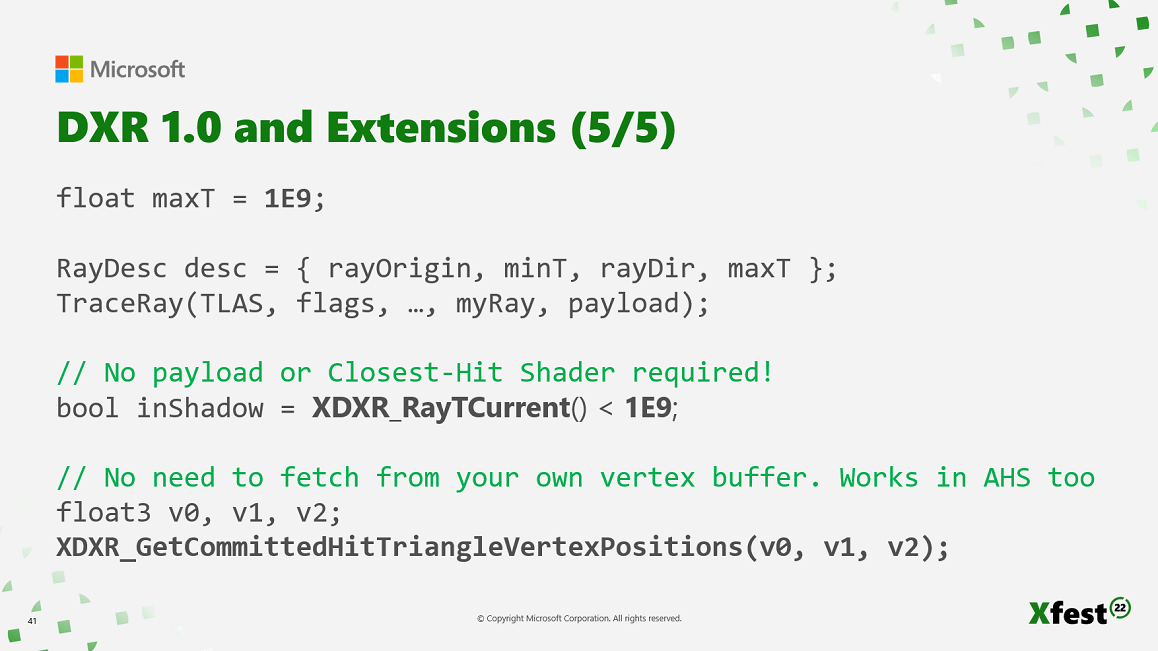 O exemplo de código na figura 9 mostra o uso das extensões `XDXR_RayTCurrent` e `XDXR_GetCommittedHitTriangleVertexPositions`. Comece inicializando [maxT](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-xdxr) com o comprimento máximo do raio e, em seguida, chame `TraceRay`. Compare `XDXR_RayTCurrent` depois que a chamada `TraceRay` for concluída e retornar ao sombreador de geração de raios. Se o valor for menor que o definido originalmente, houve um acerto. Se houve um acerto e você quiser saber quais eram essas posições de vértice, chame `XDXR_GetCommittedHitTriangleVertexPositions`. Você obtém as três posições de vértice diretamente da memória da BVH.
## Traçado de raios embutido
Embora alguns títulos ainda usem o DXR 1.0, recomendamos que os desenvolvedores usem o DXR 1.1 e o traçado de raios embutido. O DXR 1.1, que existe no PC, introduziu uma versão de traçado de raios embutido chamada [RayQuery](https://microsoft.github.io/DirectX-Specs/d3d/Raytracing.html#rayquery). Isso permite traçar raios a partir de estágios de sombreador tradicionais, como sombreadores de computação ou sombreadores de pixel. `RayQuery` não pode chamar outros sombreadores. Por exemplo, você não pode lidar com uma transparência com teste alfa chamando um sombreador de acerto. Tudo precisa ser feito nesse sombreador, sem chamadas de função disponíveis. O XBOX não dá suporte à API `RayQuery` do DXR 1.1. No entanto, há outra opção.
O DXR 1.0 continua sendo uma caixa-preta no console da mesma forma que no PC. O código-fonte do construtor de BVH em runtime não é fornecido, e o código de travessia fica oculto no driver por trás da chamada DispatchRays. O código de travessia de raios foi implementado em HLSL ([linguagem de sombreador de alto nível](https://learn.microsoft.com/windows/win32/direct3dhlsl/dx-graphics-hlsl)). Você pode ver esse código e incluí-lo diretamente nos seus próprios sombreadores. O código de travessia é distribuído em HLSL em um arquivo de cabeçalho que acompanha o GDK. Você pode usar `hash #include` para incluí-lo em seus sombreadores e usá-lo como quiser.
Você chama `hash #include` com o arquivo [XDXRStandaloneTraverseShortStack.hlsli](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-standalone), incluído no diretório de instalação do GDK. Ele pode ser usado em qualquer estágio de sombreador que possa alocar LDS ou memória compartilhada de grupo. Atualmente, esses estágios são o sombreador de computação e o sombreador de pixel. Como o código-fonte foi fornecido, você pode modificar o sombreador. Se houver funcionalidades de que você não precisa (ou pelas quais está pagando) e quiser se livrar delas, exclua o código.
Se você tiver código que deseja adicionar ao seu sombreador para personalizar seu título, adicione esse código diretamente ao cabeçalho e continue incluindo-o. Não há nenhum requisito binário para que seu sombreador corresponda a algo no driver. Ele não tem nenhum tipo de controle de versão. Ele está ali para você incluir em seus sombreadores.
**IMPORTANTE**: reservamo-nos o direito de alterar o formato da BVH a qualquer momento, em qualquer atualização do GDK. Esses sombreadores podem mudar de um GDK para o outro. Se você estiver fazendo modificações, esteja preparado para mesclar suas alterações personalizadas a cada atualização do GDK.
**Figura 10. Slide 46.**
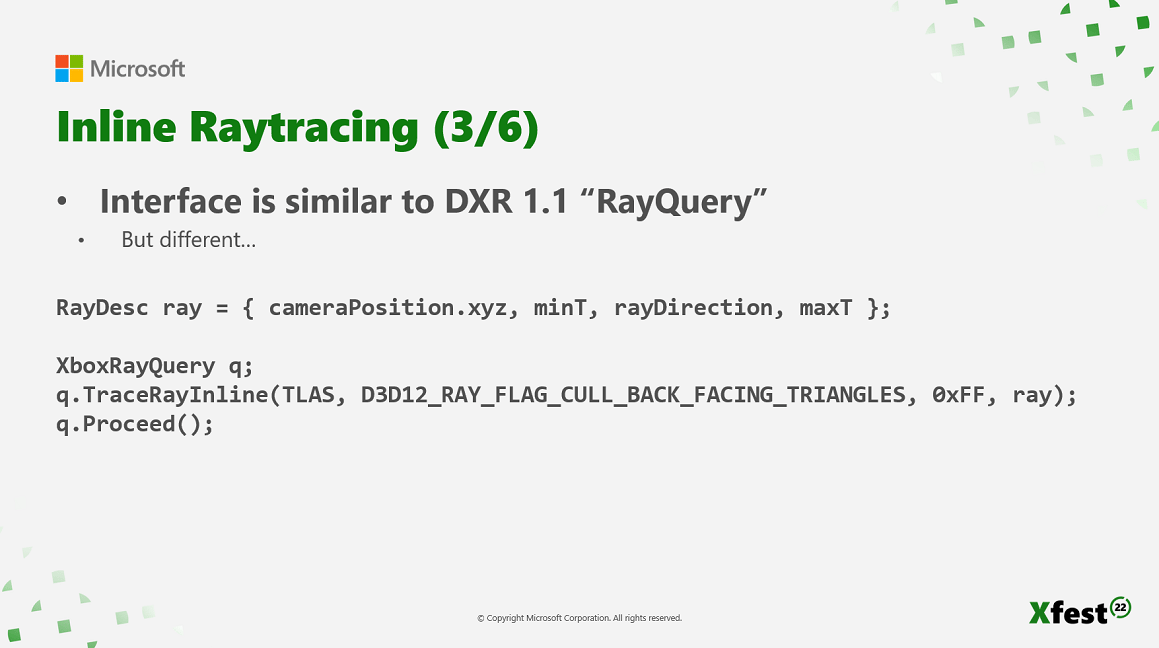 A interface do cabeçalho autônomo na figura 10 é semelhante à `RayQuery` do DXR 1.1. Ela se chama [XboxRayQuery](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-standalone) e usa muitos dos mesmos sinalizadores e muitas das mesmas entradas. Na verdade, ela é parecida, e é por isso que não houve investimento no DXR 1.1.
Se você estiver usando a abordagem de traçado de raios embutido, talvez queira lidar com o teste alfa. Isso pode ser feito de uma das duas maneiras a seguir.
* A função [Proceed](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-standalone) retorna sempre que um acerto não opaco é encontrado e pergunta se esse acerto deve ser confirmado. Você pode usar o intrínseco de candidato para obter informações sobre as coordenadas baricêntricas, fazer uma pesquisa de textura e depois verificar o canal alfa para ver se deseja aceitar o acerto.
* Injete sua função de acerto de teste alfa diretamente no loop de travessia. O benefício de desempenho é que você não sai do loop de travessia para executar seu código e depois precisa entrar novamente no loop de travessia pelo início. Execute sua função de teste dentro do loop de travessia para economizar Vector General-Purpose Registers (VGPRs), aumentar a ocupação e executar menos instruções. Recomendamos que você use essa opção por causa desses benefícios.
A abordagem de traçado de raios embutido tem vários benefícios em comparação com o DXR 1.0. Como o compilador vê o sombreador inteiro, incluindo a travessia, ele pode eliminar o código de travessia não utilizado que não é relevante para o seu título. Por exemplo, o tratamento de primitivos procedurais de AABB. Os requisitos de VGPR costumam ser cerca de 10 VGPRs menores do que no DXR 1.0. Isso proporciona melhor ocupação e melhor desempenho. Ela pode ser personalizada de acordo com os requisitos do seu título, o que a torna uma opção melhor que o DXR 1.0.
O traçado de raios embutido tem desvantagens, e algumas são piores que outras. Se você precisar lidar com uma variação significativa de materiais, pode ser difícil fazer isso em um único sombreador. Talvez você consiga lidar com um ou dois materiais com uma instrução `switch` ou `if`. No entanto, quando você precisa chamar 1.000 funções diferentes para lidar com 1.000 sombreadores de acerto mais próximo diferentes, ou código para lidar com materiais diferentes, há um impacto significativo na aparência do sombreador e em como ele é compilado.
O PIX não reconhece que você está fazendo traçado de raios. É apenas mais um sombreador de computação chamando código fornecido em um arquivo de cabeçalho. Como não é reconhecido como traçado de raios, fazer a criação de perfil de desempenho e a depuração é complicado. Além disso, se você já tiver uma implementação DXR 1.0 em execução, há etapas extras para fazer isso funcionar além da solução que já funcionava.
## Ocupação
A ocupação é importante para obter um bom desempenho com traçado de raios.
A baixa ocupação é o problema de desempenho mais comum em títulos. Os desenvolvedores implementaram o traçado de raios, mas estão obtendo um desempenho ruim. Os títulos costumam ter Raytracing Pipeline State Objects (RTPSOs) que usam mais de 160 VGPRs. Isso corresponde a uma ocupação de apenas seis waves ao executar como Wave32. Se o traçado de raios fosse executado como Wave64, a ocupação seria de três. Isso é baixo demais. A prática recomendada é que um título alcance alta ocupação, com 12 ou mais Wave32s sendo executadas simultaneamente.
**Figura 11. Slide 52.**
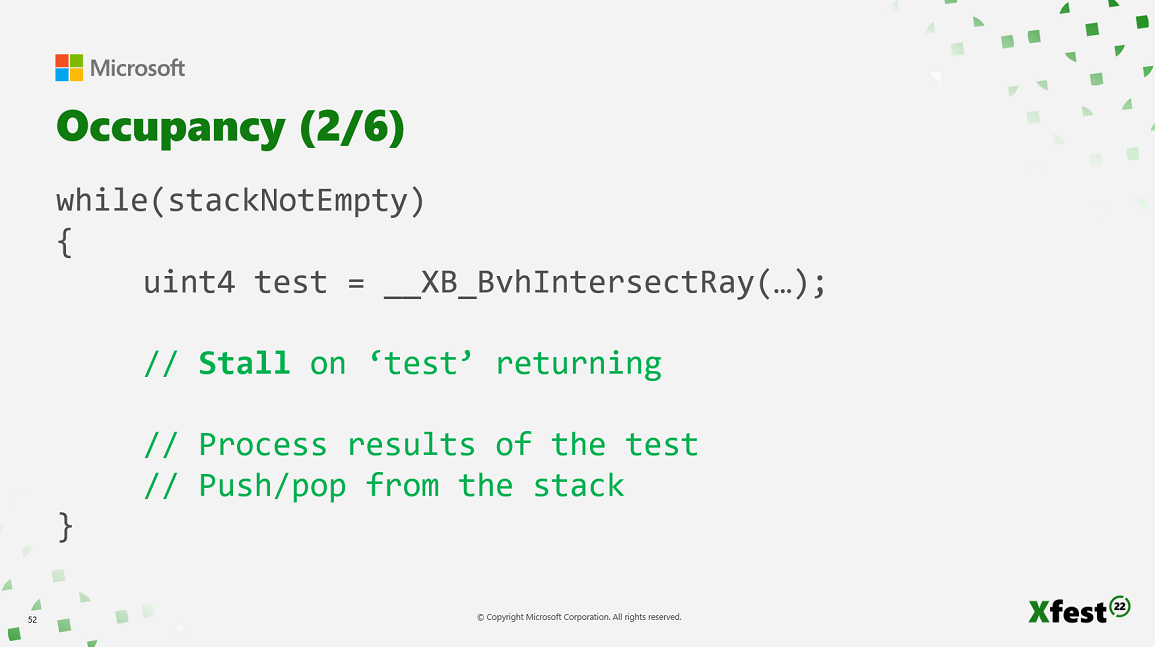 A figura 11 mostra um loop de travessia simples e reduzido. É um loop `while` que diz: "enquanto ainda houver áreas da BVH a explorar, faça um teste de interseção de raio". A figura 11 mostra o intrínseco [\_XB\_BvhIntersectRay](/pt-BR/tools/tools-console/shadercompiler/dxc-xbox-intrinsics). A wave não tem mais nada a fazer: ela está esperando a resposta para "o que este raio atingiu e a que distância foi o acerto?" e, então, fica parada. É fundamental que a GPU agende uma wave diferente para substituir essa wave. Se você estiver com ocupação um, não há outra opção a não ser parar todo o SIMD enquanto aguarda o retorno da solicitação de interseção dessa wave. Quanto mais ocupação você tiver, mais opções a GPU terá para agendar novas waves. É por isso que é importante ter 12, 13, 14, 15 ou 16 waves sendo executadas simultaneamente.
Como nosso código de travessia usa 2 KB de LDS ou memória compartilhada de grupo para cada Wave32, não há como exceder a ocupação 16. Esse é o limite, embora o hardware possa chegar à ocupação 20. Você não consegue alcançar isso por causa da quantidade de LDS que o sombreador usa. A ocupação 16 não pode ser excedida, portanto não há valor em tentar reduzir sua contagem de VGPRs para menos de 64.
Os RTPSOs precisam ser iniciados alocando tantos VGPRs quanto os sombreadores mais caros de todo o RTPSO. Não há visibilidade de quais sombreadores você está chamando, então presume-se que qualquer um deles possa ser chamado. Como resultado, você deve alocar VGPRs no nível mais alto de qualquer um desses sombreadores.
Os sombreadores de qualquer acerto (any-hit) usam seus VGPRs além dos usados pela travessia. Não salve e restaure VGPRs na memória sempre que eles fizerem uma chamada ao sombreador de qualquer acerto. É importante manter baixas as contagens de VGPRs nos sombreadores de qualquer acerto. Os sombreadores de acerto mais próximo costumam ser os sombreadores com os maiores requisitos de VGPRs. Esses sombreadores se aproximam de um sombreador de pixel de uma passagem de rasterização normal. Eles tendem a avaliar materiais, iluminação, BRDF e muito mais, por isso apresentam as maiores contagens de VGPRs. Tenha isso em mente ao observar a contagem de VGPRs de todo o RTPSO.
Recomendamos que você crie um RTPSO por finalidade. Isso significa, por exemplo, ter um RTPSO de sombras, um RTPSO de oclusão de ambiente ou um RTPSO de reflexos.
Por exemplo, as sombras geralmente têm um requisito de VGPRs menor que os reflexos. Ao fazer a renderização de sombras com traçado de raios, você pode obter mais ocupação nas sombras do que nos reflexos. Se você criasse um único RTPSO para reflexos e sombras, ele ficaria limitado aos requisitos de VGPRs dos reflexos. Um RTPSO de sombras pode ser executado com maior ocupação e melhor desempenho.
É fundamental manter os sombreadores de qualquer acerto o mais simples possível. Eles são chamados de forma embutida com a travessia. Sempre que um único raio avalia um sombreador de qualquer acerto, ele atrasa todas as outras threads que não precisam executar o sombreador de qualquer acerto. É recomendável manter os sombreadores o menores possível. Não tente avaliar a iluminação neles e armazená-la no payload. Faça a quantidade mínima de trabalho: decida se deseja aceitar o acerto e, em seguida, retorne à travessia.
O DXR 1.0 aloca uma pilha de 32 MB no momento da criação do dispositivo para dar suporte ao salvamento, à restauração de registradores e à recursão. A recomendação em 2019 era não usar recursão. Isso continua valendo hoje. É um problema de desempenho do qual é difícil sair.
Para uma alocação de pilha de 32 MB, a palavra *pilha* tem um significado um pouco sobrecarregado. Na verdade, há duas pilhas. Há a pilha que cada wave tem alocada no LDS para acompanhar seu caminho pela BVH e o nó para o qual deve retornar. E há a pilha que existe na memória global e é usada para salvar e restaurar registradores.
No segundo tipo de pilha, se uma única wave tiver muitos registradores para despejar e precisar gravar muitos registradores na memória, os 32 MB podem se esgotar rapidamente. Essa pilha de 32 MB pode atuar como um limite de ocupação em casos extremos. A partir do GDK de março de 2022, 32 MB são alocados nos consoles XBOX Series X e XBOX Series S. No GDK de junho de 2022, o XBOX Series S aloca uma pilha muito menor, pois tem menos processadores de grupo de trabalho do que o XBOX Series X. Se você não usar essa pilha, poderá desabilitá-la no momento da criação do dispositivo. Por exemplo, se você estiver usando exclusivamente o DXR 1.1 e o caminho de traçado de raios embutido, isso não despejaria registradores para nenhuma finalidade.
## RTPSO offline
O XBOX sempre pode compilar sombreadores para DXBC ou para DirectX Intermediate Language (DXIL), assim como no PC com Windows. Mas, como plataforma fixa, o XBOX também pode pré-compilar sombreadores até o microcódigo da AMD, pronto para execução sem compilação adicional. Não há dificuldade em fazer isso com sombreadores de vértice, sombreadores de pixel e sombreadores de computação se você fornecer uma assinatura raiz. Sombreadores de computação, de vértice e de pixel são partes de código independentes, compiladas e autocontidas. Eles não fazem chamadas de função para outro código. Não há ABI com a qual trabalhar ao fazer outra chamada. Eles são fáceis de compilar até o microcódigo.
Infelizmente, os sombreadores de traçado de raios são muito mais complexos. Eles têm dependências externas de código que o compilador não consegue ver. O código de travessia existe no driver, mas não existe no compilador. Quando você compila um sombreador de traçado de raios, o sombreador inteiro não pode ser compilado até o microcódigo da AMD. Ele só vai até o DXIL.
Ao compilar sombreadores DXR, use o destino lib\_6\_3 (Library Shader Model 6.3). Esses sombreadores são compilados até o DXIL. Isso funciona da mesma forma que no PC. Somente quando você chama [CreateStateObject](/pt-BR/reference/graphics/d3d12/interfaces/id3d12device5/methods/id3d12device5_createstateobject_public) em runtime é que o microcódigo da AMD é produzido. Em alguns casos, RTPSOs que contêm centenas ou milhares de sombreadores podem levar segundos em vez de milissegundos. Uma chamada `CreateStateObject` de vários segundos é esperada. Um tempo de compilação de dois segundos pode ser algo que você consegue ocultar atrás de uma tela de carregamento. Se o seu título de mundo aberto tiver jogadores navegando por ele em alta velocidade e você não puder atrasar em dois segundos o desenho de um objeto para compilar um novo RTPSO, isso será um problema. Como o XBOX atualmente não dá suporte ao DXR 1.1, a API `AddToStateObject`, que adiciona sombreadores aos RTPSOs, não ajudará.
Em vez disso, você pode pré-compilar totalmente os RTPSOs offline. Isso é mais trabalhoso do que chamar o DXC. Usando o driver de PC do XBOX Series X|S, que é o mesmo driver que você usaria com o construtor de BVH offline, compile seus RTPSOs até o microcódigo da AMD. Chame `CreateStateObject`, que é a mesma API a ser chamada em runtime no console. Serialize o RTPSO no SSD usando a API [SerializeStateObjectX](/pt-BR/reference/graphics/d3d12_xs/interfaces/ID3D12Device8/methods/id3d12device8_serializestateobjectx). Quando gravado no SSD, esse blob tem apenas alguns MB, dependendo de quantos sombreadores você tem. Você pode carregar esse bloco do SSD em runtime e usar a API [DeserializeStateObjectX](/pt-BR/reference/graphics/d3d12_xs/interfaces/ID3D12Device8/methods/id3d12device8_deserializestateobjectx) para obter um RTPSO pré-compilado e carregável, sem uma etapa de compilação.
Essas bibliotecas DXIL podem ser compiladas em RTPSOs de duas maneiras com diferenças sutis.
A primeira opção é um RTPSO totalmente autocontido. Esse é um RTPSO pronto para ser associado ao pipeline e usado em uma chamada DispatchRays.
A segunda opção, que chamamos de RTPSO, também é uma coleção. É um grupo de sombreadores que têm uma finalidade comum ou uma relação comum com um objeto ou nível específico. Esses sombreadores podem ser compilados como um único blob ou uma única entidade e, em seguida, compartilhados entre vários RTPSOs em runtime. Com essa opção, você pode construir um RTPSO em runtime a partir de várias coleções pré-compiladas offline. Em vez de compilar para microcódigo da AMD em runtime, essas coleções pré-compiladas são vinculadas no driver. Esse processo normalmente leva cerca de 10 milissegundos. Essa etapa de pré-compilação offline remove qualquer DXIL e metadados para manter o tamanho reduzido. Se você estiver fazendo associação de subobjetos em runtime, que é uma função da API DXR, isso não é possível com essa opção.
Com a segunda opção, você obtém identificadores de sombreador do RTPSO. Eles são necessários no início de cada registro da sua tabela de associação de sombreadores. Isso, junto com a compactação de BVH, é mostrado no [exemplo OfflineRT do ATG](https://github.com/microsoft/Xbox-ATG-Samples).
## PIX
Foi feito muito investimento no suporte do PIX ao DXR. O Acceleration Structure Viewer e a exibição de recursos na exibição Pipeline também foram aprimorados. Duas áreas que atualmente deixam a desejar, mas que são áreas ativas de muito trabalho, são os PDBs de sombreador para traçado de raios, que atualmente não têm suporte, e a capacidade de depurar raios ou threads dentro de chamadas DispatchRays. Se você tiver sugestões para melhorar o PIX, o suporte ao DXR ou outros comentários, selecione o botão **Feedback** no canto superior direito do PIX e envie-nos qualquer feedback, tanto sobre o suporte ao DXR quanto sobre outras áreas que você gostaria que conhecêssemos.
**Figura 12. Slide 65.**
 As imagens a seguir mostram a aparência do Acceleration Structure Viewer.
A figura 12 mostra uma chamada de dispatch. Selecionar uma estrutura de aceleração no lado esquerdo oferece uma câmera livre que pode orbitar, com uma visão de mundo da sua estrutura de aceleração. Você pode ver os triângulos individuais, as instâncias individuais e as BLASs que compõem toda a sua TLAS.
**Figura 13. Slide 66.**
 A figura 13 mostra um mapa de calor. Use-o para ver onde estão os pontos críticos de desempenho na sua cena. Isso pega o sombreador de traçado de raios embutido e o torna compatível com PC. Seu PC host agora executa o código de travessia dentro do PIX. Como é uma versão instrumentada, é possível extrair informações sobre quantas iterações do loop de travessia foram necessárias para aquele raio. Isso pode ser visualizado na tela na forma de cores.
**Figura 14. Slide 67.**
 A figura 14 demonstra que objetos, como esta lixeira destacada na frente da cena, são selecionáveis. Você pode determinar que ela não está fundida ao chão. Se estivesse fundida, criaria um grande limite de instância. Selecionar objetos e ver onde eles estão na cena é importante.
**Figura 15. Slide 68.**
 Na figura 15, uma árvore está selecionada. O Acceleration Structure Viewer também mostra todas as outras cópias dessa árvore. Esta figura tem cerca de 10 cópias da árvore. Ao selecionar uma árvore, as outras nove são destacadas. Isso mostra que a instanciação é usada e que não há 10 BLASs diferentes usadas para essas árvores.
**Figura 16. Slide 69.**
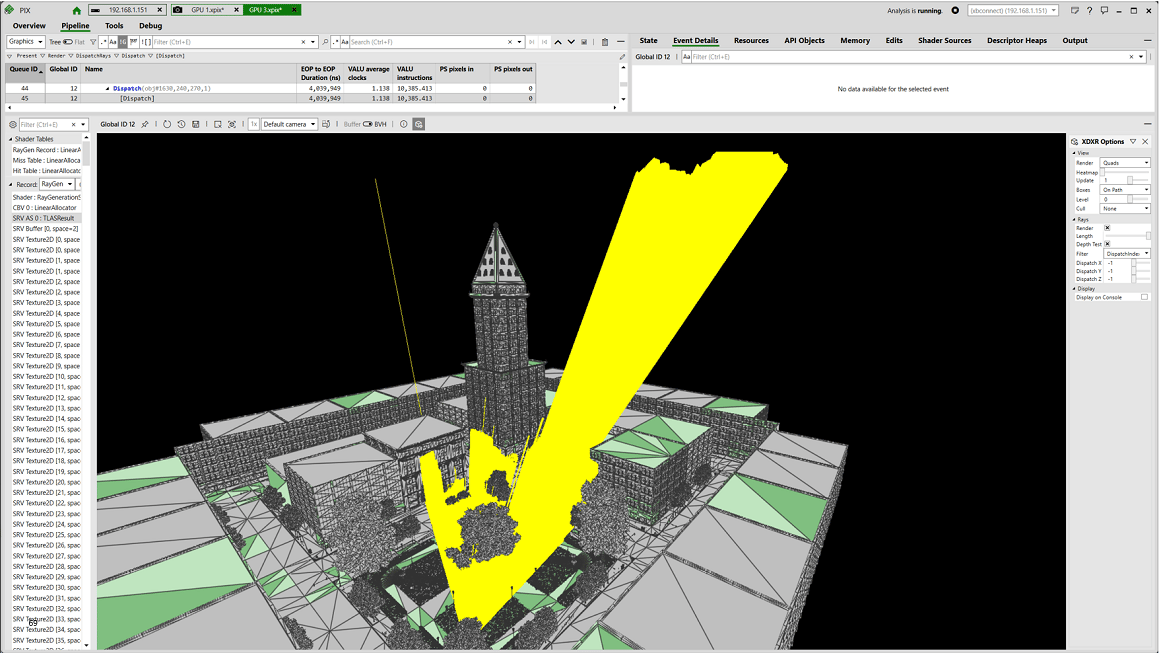 A figura 16 mostra a capacidade, adicionada recentemente, de visualizar raios diretamente no Acceleration Structure Viewer. Como esta é uma versão instrumentada de uma travessia, você pode extrair as origens, as direções e as extensões dos raios. Elas podem ser desenhadas como linhas de wireframe diretamente na cena.
Um único raio no lado esquerdo da tela na figura 16 parece atravessar o prédio e sair do outro lado. Inicialmente, isso parecia ser um bug no PIX. Na verdade, o prédio tem uma pequena rachadura muito fina. Um raio passou pelo prédio e saiu pelos fundos. O culling de faces traseiras estava desabilitado. Esperamos que esse tipo de visualização seja útil para você ao investigar seus problemas de desempenho.
## Resumo
Em resumo:
* O traçado de raios é possível nos consoles XBOX Series X|S.
* Você deve prestar muita atenção ao desempenho.
* Considere os ativos de arte à medida que são criados. Isso inclui os sombreadores que você escreve, os sinalizadores de build que você usa, se você está usando uma API específica do XBOX ou usando computação assíncrona.
* A memória pode ser uma preocupação importante. Particularmente nos consoles XBOX Series S, são necessários cerca de 500 MB de memória para suas BLASs ou TLASs.
Todas essas áreas precisam ser consideradas desde o início ao desenvolver o traçado de raios para o seu título.
A equipe do PIX está trabalhando arduamente para melhorar o PIX. Esperamos fazer o PIX funcionar de forma que você possa resolver por conta própria todos os seus problemas de traçado de raios, depuração e desempenho de GPU, sem precisar entrar em contato primeiro com o ATG para obter ajuda específica.
## Próximas etapas
Se você quiser revisar as informações dos materiais de apresentação relacionados a esta visão geral, baixe os arquivos a seguir do [XBOX Developer Download Secure Data Storage (SDS)](https://www.microsoft.com/en-us/software-download/gdk).
* Apresentação de slides: GR09\_Best Practices for Raytracing on XBOX Series X|S.pptx em Xfest 2022 Graphics Track PowerPoints (Xfest2022GfxPPTs.ZIP)
* Apresentação em vídeo: GR09.mp4 em Xfest 2022 Graphics Track Videos (Xfest2022GfxVids.ZIP)
### Baixar as apresentações do Microsoft PowerPoint e os vídeos
1. Acesse [Downloads do Game Development Kit (GDK)](https://www.microsoft.com/en-us/software-download/gdk).
2. Em Select file type, selecione **Conference Materials** e, em seguida, selecione **Confirm**.
3. Em Select build/version number, escolha uma das seguintes apresentações de gráficos.
* Xfest 2022 Graphics Track PowerPoints
* Xfest 2022 Graphics Track Videos
4. Selecione Download Now e aguarde o término do download do arquivo .zip.
5. Acesse sua pasta Downloads local e descompacte (extraia) os arquivos da pasta compactada.
## Confira também
[Introdução ao traçado de raios](/pt-BR/build/core-features/graphics/newfeatures/raytracing/rt-overview)
## Related topics
- [XR-013 Vinculação de contas Microsoft a contas do publisher](/pt-BR/publishing/certification/xr/xr-013.md)
- [Requisitos XBOX testados na certificação para jogos de console XBOX](/pt-BR/publishing/certification/console-cert-tested-requirements.md)
- [Requisitos do XBOX para jogos do XBOX](/pt-BR/publishing/certification/xbox-requirements.md)
- [XR-003 Qualidade do título para envio](/pt-BR/publishing/certification/xr/xr-003.md)
- [XR-115 Adição e remoção de usuários ou controles durante a jogabilidade](/pt-BR/publishing/certification/xr/xr-115.md)