> ## Documentation Index
> Fetch the complete documentation index at: https://devdocs.xbox.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Performances des jeux dans les environnements à processeurs hybrides
> Ajustez l'affinité des threads, l'énumération des ensembles de processeurs (CPU Sets) et les augmentations de priorité de votre jeu PC pour les processeurs hétérogènes d'Intel, AMD et Qualcomm afin d'obtenir des temps d'image réguliers.
Les fabricants de processeurs cherchent constamment un équilibre entre performances, consommation d'énergie et surface de la puce. En effet, les clients ont des habitudes d'utilisation et des priorités différentes. Une personne utilisant un ordinateur de bureau s'intéresse davantage aux performances, tandis qu'un utilisateur d'ordinateur portable s'intéresse davantage à l'autonomie de la batterie. Une surface de puce plus petite peut se traduire par des coûts de production réduits. Pour répondre à ces exigences concurrentes, les fabricants de processeurs conçoivent des *architectures hétérogènes* qui permettent au système de s'adapter dynamiquement aux exigences de la charge de travail actuelle tout en maîtrisant les coûts.
Les fabricants de processeurs ont mis en œuvre une topologie hétérogène en utilisant des cœurs de processeur présentant différents niveaux d'efficacité. Cette approche remplace certains cœurs d'une architecture de processeur existante par des cœurs plus économes en énergie. Si l'utilisateur n'a pas besoin de toutes les performances du processeur, le système d'exploitation désactive les cœurs les plus performants afin d'économiser une quantité importante d'énergie, ce qui prolonge l'autonomie de la batterie. Lorsque davantage de performances sont nécessaires, le système d'exploitation peut activer dynamiquement les cœurs les plus performants pour gérer l'augmentation de la charge de travail.
## Matériel
Les différents fabricants de matériel indépendants (IHV) définissent les topologies de processeurs hétérogènes de manière différente. Intel et Qualcomm utilisent les termes **Performance** et **Efficiency**, tandis qu'AMD utilise les termes **Performance** et **Compact**. Chaque fabricant fait des compromis entre performances et efficacité lors de la conception de sa topologie de cœurs.
Les exemples suivants illustrent certains des choix de conception en jeu :
* **Tailles de cache différentes**
* Les différents cœurs peuvent avoir des tailles de cache différentes.
* Par exemple, les cœurs performants peuvent disposer de caches L1 et L2 plus grands.
* **Partage du cache**
* Les caches peuvent être partagés entre les cœurs à des degrés divers.
* Par exemple, les cœurs les plus performants peuvent disposer chacun d'un cache L2 privé, tandis que les cœurs plus efficaces peuvent partager un seul cache L2.
* **Prise en charge du multithreading simultané (SMT)**
* Certains cœurs peuvent prendre en charge le SMT, d'autres non.
* Intel désigne le SMT sous le nom d'*Hyper-Threading*.
* **Organisation interne des cœurs**
* Les ressources internes des différents types de cœurs peuvent varier.
* Par exemple, les cœurs performants peuvent comporter davantage de pipelines à virgule flottante, de pipelines ALU ou des voies de données plus larges.
* **Fréquence maximale**
* La fréquence maximale peut différer selon le type de cœur.
* Par exemple, les cœurs performants peuvent atteindre une fréquence plus élevée que les cœurs efficaces.
Ces différences visent à équilibrer les performances et la consommation d'énergie entre les cœurs d'un processeur. Un cœur à fréquence plus élevée offre de meilleures performances au prix d'une consommation d'énergie accrue. Plusieurs cœurs partageant tous le même cache réduisent la taille de la puce, ce qui diminue la consommation d'énergie, mais au prix de performances réduites. L'objectif est de permettre des choix plus dynamiques entre performances et consommation d'énergie. Si l'utilisateur n'a pas besoin de toutes les performances, le système d'exploitation bascule vers des cœurs plus efficaces afin de réduire la consommation d'énergie.
Il est important de noter que Windows exige que tous les cœurs du processeur prennent en charge la même [architecture de jeu d'instructions](https://en.wikipedia.org/wiki/Instruction_set_architecture) (ISA). Cela signifie que si un processeur prend en charge un jeu d'instructions spécifique, tous ses cœurs le prennent en charge. Par exemple, si le processeur indique qu'il prend en charge AVX2, tous les cœurs prennent en charge AVX2.
Pour des détails précis sur les différences entre cœurs performants et cœurs efficaces, consultez la documentation officielle de chaque IHV.
## Chiffres de performances
On s'attend à ce que des cœurs de niveaux d'efficacité différents offrent des performances différentes. L'un est conçu pour les performances, l'autre pour les économies d'énergie. La question est de savoir dans quelle mesure ces cœurs diffèrent.
Les données présentées regroupent plusieurs IHV. Chaque IHV présente une mise à l'échelle différente pour chaque test, en fonction des choix effectués pour sa topologie. Si les chiffres exacts diffèrent, les tendances sont similaires chez tous les IHV. En outre, chaque génération de processeurs fait des compromis différents, ce qui modifie les chiffres relatifs. Produire des chiffres pour l'ensemble des IHV et des générations existants dépasse le cadre de cet article.
### Tests synthétiques
Les calculs vectoriels représentent une part importante du travail effectué par un titre de jeu au cours d'une image. Cette charge de travail peut concerner aussi bien la physique que l'IA ou le rendu. Le jeu effectue ce travail à l'aide de types vectoriels de trois ou quatre nombres à virgule flottante qui tiennent dans un seul registre SSE de 128 bits. Ils couvrent un large éventail d'opérations, telles que les produits scalaires, la multiplication de matrices, les calculs de racine carrée et les transformations de vecteurs. Les différences de performances sur ces opérations peuvent avoir un effet significatif sur le temps d'image global.
Les graphiques suivants montrent le coût relatif de sept opérations mathématiques courantes. Les mesures utilisent un vecteur de quatre valeurs à virgule flottante de 32 bits stockées dans un seul registre SSE de 128 bits. Une matrice est composée de quatre vecteurs, soit un total de seize valeurs à virgule flottante de 32 bits réparties sur quatre registres SSE de 128 bits. Ces opérations ont été choisies parce qu'elles sont couramment utilisées au cours d'une image.
* **Produit scalaire** : calcule le produit scalaire d'un vecteur.
* **Transformation de vecteur** : transforme un vecteur en le multipliant par une matrice.
* **Addition de vecteurs** : additionne deux vecteurs.
* **Produit vectoriel** : calcule le produit vectoriel de deux vecteurs.
* **Sinus vectoriel** : calcule une approximation du sinus de chaque élément d'un vecteur.
* **FMA vectoriel (multiplication-addition fusionnée)** : multiplie deux vecteurs et ajoute un troisième.
* **Racine carrée inverse** : calcule l'inverse de la racine carrée de la longueur d'un vecteur.
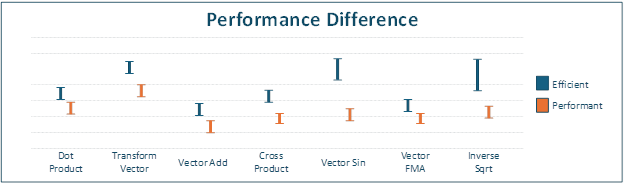
**Figure 1 : temps nécessaire pour effectuer l'opération. Plus la valeur est basse, mieux c'est.**
 Dans ce graphique, l'axe des ordonnées représente le temps nécessaire pour effectuer l'opération. Chaque barre représente la plage de temps mesurée pour l'opération sur l'ensemble des IHV, c'est-à-dire le temps minimal et maximal lors de l'exécution du test sur un cœur performant ou sur un cœur efficace.
Comme prévu, les performances diffèrent selon le type de cœur. Cependant, le principal enseignement de ces chiffres est que les performances n'évoluent pas de manière uniforme selon les opérations et les IHV. Si la variabilité des résultats entre IHV tend à être similaire, certains présentent une variabilité plus élevée. Les opérations présentant la plus forte variabilité sont principalement le sinus vectoriel et la racine carrée inverse. Cette différence s'explique par les choix d'architecture entre cœurs performants et cœurs efficaces. La cause exacte de cet écart peut avoir plusieurs origines. Par exemple, les cœurs les plus performants peuvent disposer de davantage de pipelines à virgule flottante, ce qui permet d'exécuter plus d'opérations en parallèle. La raison exacte est propre à chaque IHV et à chaque génération de processeurs. Il peut même exister une configuration dans laquelle cet écart de performances n'existe pas pour certaines opérations. En fin de compte, un titre doit tenir compte de cette variabilité entre IHV.
## Conditions réelles
Les chiffres précédents présentent des bancs d'essai spécifiques pris isolément et ne racontent qu'une partie de l'histoire. Les chiffres suivants proviennent de bancs d'essai d'un moteur de jeu AAA qui utilise deux threads principaux (Simulation et Rendu) ainsi qu'un ensemble de threads de tâches. Le banc d'essai utilise trois configurations de test.
* Les deux threads principaux s'exécutent uniquement sur les cœurs les plus performants.
* Les deux threads principaux s'exécutent uniquement sur les cœurs efficaces.
* Les deux threads principaux s'exécutent sur tous les cœurs du système.
Dans chaque configuration de test, les threads de tâches peuvent se déplacer librement sur tous les cœurs du système. Le travail de rendu utilise la résolution et la qualité les plus basses possibles. Ce paramètre garantit que le titre est limité par le processeur pendant toute la durée du test. Il fait également du thread Simulation le facteur déterminant de la fréquence d'images.
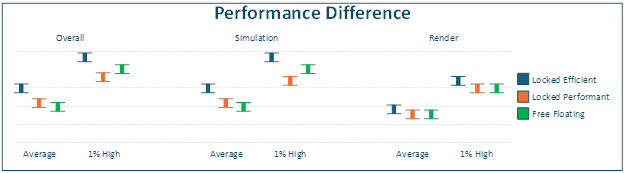
Ce graphique montre le temps passé dans chaque thread au cours d'une image. Il indique à la fois le temps d'image moyen et le centile 1 % le plus élevé. Le centile 1 % le plus élevé est le seuil correspondant aux 1 % d'images les plus longues : seulement 1 % de toutes les images dépassent cette valeur. Ce chiffre donne une bonne idée du nombre d'images saccadées. Plus il s'éloigne de la moyenne, plus les saccades du titre sont importantes. Dans tous les cas, des valeurs plus basses indiquent moins d'images longues et des saccades moins visibles.
Comme indiqué précédemment, les données présentées regroupent plusieurs IHV. Chaque IHV présente une mise à l'échelle différente pour chaque test, en fonction des choix effectués pour sa topologie. Si les chiffres exacts diffèrent, les tendances sont similaires d'un IHV à l'autre. Chaque génération de processeurs peut faire des compromis différents, ce qui modifie les chiffres relatifs. Produire des chiffres pour l'ensemble des IHV de processeurs et des générations existants dépasse le cadre de ce document.
**Figure 2 : temps moyen et centile 1 % le plus élevé. Plus la valeur est basse, mieux c'est.**
 Dans ce graphique, l'axe des ordonnées représente le temps nécessaire pour une image. Chaque barre représente la plage de temps mesurée sur l'ensemble des IHV, c'est-à-dire le temps minimal et maximal pour chaque topologie de threads testée.
Le planificateur de threads du système d'exploitation utilise des heuristiques pour déterminer la quantité de travail effectuée par un thread. Ces heuristiques combinent des choix du système d'exploitation et des ajustements de pilote propres à chaque IHV. Le planificateur utilise ces informations pour choisir les cœurs sur lesquels un thread donné doit s'exécuter. Lorsqu'il estime qu'un thread effectue une grande quantité de travail, il déplace ce thread vers un cœur plus performant.
En raison des heuristiques du planificateur, un comportement contre-intuitif peut se produire : le titre s'exécute plus rapidement lorsque les threads critiques sont autorisés à se déplacer librement. Ce comportement ne se produit pas toujours et dépend de la charge de travail, de la topologie des cœurs et des heuristiques exactes du planificateur.
Dans le cas testé ici, le thread Simulation passe plus de temps à s'exécuter à chaque image que le thread Rendu. Le planificateur préfère placer ce thread sur un cœur plus performant. Il décide également de placer le thread Rendu sur un cœur moins performant, car celui-ci passe plus de temps suspendu dans l'attente de travail. Au final, cette décision libère un cœur plus performant pour l'un des threads de tâches. Si le thread Rendu effectuait davantage de travail, cette situation pourrait ne pas se produire.
Toutefois, l'enseignement le plus intéressant de ce graphique concerne le centile 1 % le plus élevé. Même si la moyenne est identique lorsque les threads critiques se déplacent librement, le centile 1 % le plus élevé est moins bon que lorsque les threads critiques sont verrouillés sur les cœurs performants. Cela signifie que la fréquence d'images présente davantage de saccades lorsque les threads critiques se déplacent librement. La raison la plus courante est que les heuristiques du planificateur fonctionnent sur une fenêtre glissante. Il leur faut du temps pour réagir à un pic de travail nécessaire pour une image. Pendant ce temps, un thread critique peut s'exécuter sur un cœur moins performant.
Chaque fabricant peut ajuster ces heuristiques du planificateur pour les adapter à son matériel. Par exemple, AMD propose sa technologie Workload Profile Scheduling et Intel sa technologie Thread Director. Chaque IHV a également tendance à ajuster les heuristiques en fonction de la topologie spécifique du SoC.
## Recommandations
### Affinité des threads
Sur un ordinateur de bureau ne disposant que d'une seule classe d'efficacité, il est conseillé d'éviter de définir des affinités de threads strictes et de laisser plutôt les threads se déplacer sur tous les cœurs. La principale raison de cette incertitude est qu'on ne peut pas savoir à l'avance quels autres processus peuvent s'exécuter sur la machine d'un utilisateur. Un thread doté d'une affinité stricte peut finir par partager un cœur avec un autre thread de priorité élevée du système. Au final, le thread du titre est privé de temps d'exécution. Si cette contention se produit sur un thread critique pour l'image, le titre peut présenter des temps d'image irréguliers. Vous devez vous assurer que le système d'exploitation dispose d'un endroit où déplacer les threads du titre pour qu'ils continuent de s'exécuter.
Cependant, ce conseil doit être revu pour les processeurs hétérogènes. La raison principale est que le système d'exploitation ne sait pas nécessairement quels threads ou tâches du titre sont critiques pour l'image. Il dispose de certaines heuristiques pour déterminer ce qu'il considère comme les threads critiques pour l'image, mais ces heuristiques peuvent tout de même faire de mauvais choix. Il peut décider de déplacer l'un de ces threads ou l'une de ces tâches vers un cœur moins performant, ce qui augmente la probabilité de problèmes de performances dans le titre.
Il est recommandé de permettre aux threads du titre de s'exécuter sur au moins trois à quatre cœurs, et davantage si possible. Par exemple, sur un système d'entrée de gamme doté d'un cœur plus performant et de trois cœurs moins performants, vous devez permettre aux threads de se déplacer sur tous les cœurs. Sur les machines dotées d'au moins trois cœurs performants, vous pouvez limiter les threads critiques pour l'image à ces seuls cœurs plus performants.
Sur les machines haut de gamme dotées de nombreux cœurs qui prennent également en charge le SMT, certains titres peuvent essayer de verrouiller leurs threads sur des cœurs physiques. Cette technique évite la contention au niveau du cœur physique lorsque plusieurs threads de priorité élevée partagent les mêmes ressources d'un cœur physique. En général, il n'est toutefois pas recommandé d'envisager ce cas. Le système d'exploitation applique déjà ce comportement à l'échelle du système : il répartit d'abord les threads sur les cœurs physiques et n'utilise davantage de cœurs logiques qu'en cas de nécessité.
Le seul cas qu'un titre devrait envisager est celui où le système dispose de suffisamment de cœurs plus performants pour prendre en charge les threads critiques du titre. Dans ce cas, il peut être souhaitable de verrouiller les threads critiques pour l'image sur les cœurs plus performants. Toutefois, ces threads doivent pouvoir se déplacer sur l'ensemble des cœurs plus performants. Si, dans certains cas, permettre à tous les threads de se déplacer sur tous les cœurs peut améliorer les performances, ce comportement n'est pas homogène chez tous les fabricants de processeurs.
Si le titre implémente un système de vol de travail (work stealing) capable d'équilibrer entièrement la charge de travail entre tous les threads, tous les threads de tâches doivent pouvoir se déplacer sur tous les cœurs, qu'il s'agisse de threads de tâches de priorité élevée ou faible. L'algorithme de vol de travail équilibre automatiquement la charge et permet d'effectuer le plus de travail possible dans le temps le plus court. Les threads situés sur les cœurs plus performants exécutent davantage de tâches au cours de l'image.
S'il existe plusieurs threads critiques pour l'image, il peut être utile de définir leur affinité de manière à ce que deux threads critiques ne puissent jamais s'exécuter sur le même cœur. Par exemple, s'il existe deux threads critiques pour l'image, définir leurs affinités de façon mutuellement exclusive (OU exclusif) élimine la possibilité que le système d'exploitation les mette en concurrence. Là encore, n'envisagez cette option que s'il y a suffisamment de cœurs pour la prendre en charge tout en permettant à chaque thread critique pour l'image de se déplacer sur au moins trois à quatre cœurs.
### Topologie des threads
Lorsque vous déterminez comment attribuer le travail aux threads dans un environnement hétérogène, les données principales portent sur la durée des différentes tâches et sur leurs interactions : durée moyenne de chaque tâche, dépendances entre les tâches, priorités de chaque tâche, etc.
Dans quelle mesure les threads de tâches peuvent-ils absorber les pics de temps sur les threads ou tâches critiques ? Si l'un de ces threads ou l'une de ces tâches s'exécute 35 % plus lentement, quel est l'effet sur le temps d'image ? Par exemple, si une tâche dure plus longtemps que prévu, dans quelle mesure ce retard affecte-t-il le reste de l'image ? Le système est-il bloqué jusqu'à la fin de cette tâche ?
Il peut être utile de déterminer dans quelle mesure un système hétérogène affecte le temps d'image en ajoutant une surcharge supplémentaire dans les threads ou tâches critiques. À titre de test, faites en sorte qu'une tâche ou un bloc de travail choisi au hasard prenne 25 % à 35 % de temps en plus. L'ampleur de la variation du temps d'image global indique la capacité du système de tâches à absorber les pics d'exécution. Idéalement, les temps d'image ne varient presque pas, ce qui signifie que le système peut absorber des pics arbitraires de temps d'image. Ces pics proviennent soit d'une exécution sur un cœur moins performant, soit d'un autre processus quelconque du système qui utilise du temps processeur.
### Communication entre threads
La communication entre threads au moyen de primitives de verrouillage mérite réflexion. La surcharge d'un changement de contexte est étroitement liée à l'[état C](https://en.wikipedia.org/wiki/ACPI) (C-State) du cœur récepteur avant que le nouveau thread ne commence à s'exécuter. Le cœur doit être en C0, l'état d'exécution, avant que le nouveau thread puisse démarrer. Le cas le moins coûteux est celui où le cœur était déjà en cours d'exécution, donc déjà en C0. En revanche, si le cœur est inactif, il se trouve dans un état C inférieur. Le niveau de l'état C correspond à des niveaux de veille plus profonds. Une veille plus profonde réduit la consommation d'énergie du cœur, mais il est plus coûteux de sortir d'une veille profonde pour recommencer à s'exécuter. L'état C basse consommation le plus courant est C1, qui peut ajouter une surcharge de 2 à 7 μs. L'état C suivant, C2, peut ajouter une surcharge d'environ 40 à 100 μs. Le chiffre exact dépend de l'IHV et du SoC. De nombreuses variables déterminent l'état C d'un cœur inactif ; il s'agit d'un équilibre entre réactivité et consommation d'énergie. Un état C plus bas consomme moins d'énergie qu'un état C plus élevé. Il est courant qu'un cœur entre d'abord en C1, puis passe en C2 s'il n'a pas exécuté de code depuis un certain temps.
Une autre question se pose : que se passe-t-il lorsque le thread qui soumet la tâche et le thread qui l'exécute se trouvent sur des cœurs aux profils de performances différents ? Techniquement, le thread de tâches peut terminer les tâches plus vite que les nouvelles tâches ne sont créées. Cette situation est plus probable si le thread qui exécute la tâche se trouve sur un cœur plus rapide que le thread qui soumet les tâches.
Si une tâche prend moins de temps à s'exécuter qu'à être créée, le titre peut se retrouver dans une situation où un thread de tâches se suspend constamment dans l'attente de nouvelles tâches. Au final, les tâches deviennent plus coûteuses à exécuter, car le thread de tâches se suspend constamment. Le coût d'un changement de contexte s'ajoute au temps d'exécution de chaque tâche. Paradoxalement, cette surcharge peut entraîner une baisse de la fréquence d'images lors de l'exécution sur des cœurs plus performants. Par exemple, un travail qui prenait 250 μs peut soudainement prendre 275 μs, soit une baisse de performances de 10 %.
Pour cette raison, il est recommandé de soumettre les tâches par lots plutôt qu'au fur et à mesure de leur création. Par exemple, si le système suit un modèle dans lequel il construit une tâche, la soumet, construit une tâche, la soumet, etc., ce modèle doit être modifié pour construire d'abord un lot de tâches, puis les soumettre toutes en même temps.
Si le titre utilise un objet qui nécessite [WaitForSingleObject](https://learn.microsoft.com/windows/win32/api/synchapi/nf-synchapi-waitforsingleobject), cet appel doit être placé dans une petite boucle d'attente active (spin). Appelez la fonction avec un délai d'expiration de 0, puis, une fois l'attente active terminée, utilisez la valeur de délai d'expiration habituelle du titre. La meilleure solution à ce problème reste toutefois d'utiliser des API de synchronisation modernes comme les [verrous SRW (Slim Reader/Writer)](https://learn.microsoft.com/windows/win32/sync/slim-reader-writer--srw--locks), les [sections critiques](https://learn.microsoft.com/windows/win32/sync/critical-section-objects) et [WaitOnAddress](https://learn.microsoft.com/windows/win32/api/synchapi/nf-synchapi-waitonaddress). Ces API de synchronisation intègrent toutes une forme d'attente active en interne, ce qui peut éviter qu'un thread ne se suspende constamment. Cette attente active est particulièrement utile pour les verrous détenus pendant une courte durée.
Il est important d'éviter les verrous à attente active prolongée, par exemple un modèle dans lequel les threads tournent constamment en attente de travail à effectuer. Si un autre travail doit être effectué sur le cœur, le planificateur finit par suspendre le thread en attente active pour effectuer ce travail. Lorsque cette préemption se produit, il est très probable que le thread suspendu le reste pendant une durée importante. Ce comportement vise à éviter la privation des autres threads. Comme le titre n'a que peu de contrôle sur le moment de la suspension, cela peut entraîner des saccades de la fréquence d'images.
### Systèmes de tâches
Pour des performances optimales, structurez le moteur autour de tâches plutôt que de vous appuyer sur des threads dédiés, critiques pour l'image et de longue durée. Par exemple, un modèle de threads Simulation/Rendu crée deux threads persistants critiques pour l'image. Cependant, des tâches longues peuvent amener n'importe quel thread de tâches à se comporter comme un thread critique pour l'image. Si une tâche prend 10 ms, le thread qui l'exécute devient critique pour l'image pendant cette période, quel que soit son rôle initial.
### Vol de travail
La recommandation principale est d'utiliser le vol de travail dans l'ensemble du système de tâches et de faire participer tous les threads critiques pour l'image à l'algorithme de vol de travail. Par exemple, si le thread de rendu attend la fin de tâches liées au rendu, il doit exécuter certaines de ces tâches.
Ce comportement est déjà une pratique courante dans de nombreux moteurs de jeu. Il mérite toutefois d'être mentionné ici, car il est essentiel pour que le moteur de jeu puisse absorber les pics de temps d'image dus aux cœurs hétérogènes et à une éventuelle préemption par le système d'exploitation.
Plus une tâche met de temps à s'exécuter, plus le risque de pic de temps d'image augmente. Ce comportement peut être dû soit à l'exécution de la tâche sur un cœur moins performant, soit à d'autres travaux sur le PC. Il est recommandé que le moteur vise des tâches représentant environ deux pour cent de l'image. Ce budget correspond, par exemple, à environ 333 μs au maximum pour un jeu s'exécutant à 60 i/s. Si nécessaire, plusieurs petites tâches doivent être regroupées en une tâche plus grande afin d'atteindre cet objectif de deux pour cent. Cette approche offre un bon compromis entre la taille des tâches, la communication entre threads et la capacité à absorber les pics.
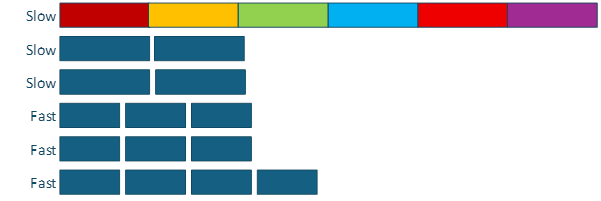
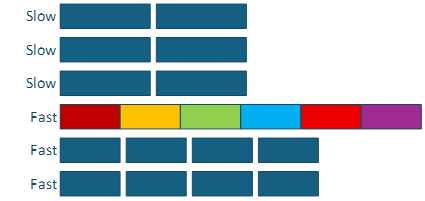
Ces exemples montrent les effets que des tâches longues critiques pour l'image peuvent avoir sur les performances du système. Dans ces exemples, chaque tâche comporte le même nombre d'opérations. Ici, une tâche unique prend 375 μs sur un cœur lent et 250 μs sur un cœur rapide. La tâche goulot d'étranglement est 6 fois plus coûteuse que les autres tâches.
Le pire scénario est celui où la tâche goulot d'étranglement se retrouve sur l'un des cœurs lents. Cela peut avoir un effet considérable sur les temps d'image. Dans ce scénario, le temps total d'exécution du travail est de 2 250 μs, soit six fois 375 μs.
**Figure 3 : exemple de tâche goulot d'étranglement s'exécutant sur un cœur plus lent.**
 La situation s'améliore lorsque la tâche goulot d'étranglement se retrouve sur un cœur plus rapide. Dans ce cas, le temps total est de 1 500 μs. Ce n'est toujours pas idéal, mais c'est mieux.
**Figure 4 : exemple de tâche goulot d'étranglement s'exécutant sur un cœur plus rapide.**
 Le meilleur résultat consiste à éviter les tâches goulots d'étranglement en conservant des tâches de petite taille et réparties uniformément. Dans cet exemple, le temps d'exécution total tombe à 1 125 μs, soit la moitié du temps de l'exemple précédent, pour la même quantité de travail effectuée.
**Figure 5 : éviter les tâches goulots d'étranglement grâce à des durées de tâches appropriées.**
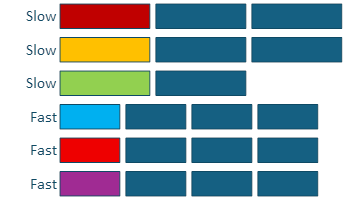 Plus important encore, si le système d'exploitation tente d'interrompre l'exécution d'une tâche, le système rééquilibre automatiquement la charge de travail. Dans ce cas, le système d'exploitation a interrompu le titre avec une tâche de 375 μs sur un cœur rapide. Ce rééquilibrage n'a aucun effet sur le temps d'image global, qui reste à 1 125 μs. L'une des tâches a migré vers du temps libre sur un cœur lent.
**Figure 6 : une interruption du système d'exploitation avec rééquilibrage de la charge de travail maintient un temps d'image stable.**
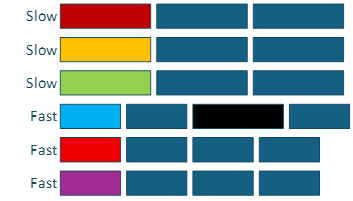 Ces exemples ne couvrent que le cas où la tâche goulot d'étranglement peut démarrer immédiatement ; si elle ne peut démarrer que plus tard dans la file d'attente des tâches, la situation empire. Tout revient à la [loi d'Amdahl](https://en.wikipedia.org/wiki/Amdahl%27s_law), selon laquelle le temps d'exécution d'un système est lié à sa partie la plus longue. Le moteur ne peut absorber aucun pic qui augmente le temps d'exécution de ces threads goulots d'étranglement. Ces pics peuvent provenir d'une exécution sur un cœur plus lent ou d'interruptions dues à d'autres processus de priorité élevée du système.
## Conclusion
En appliquant ces recommandations, vous pouvez garantir que le jeu offre des performances fiables et reste résilient face aux différentes architectures de processeurs et aux interférences d'autres processus Windows.
## Annexe
### Détermination de la classe d'efficacité des cœurs
Utilisez la fonction [GetLogicalProcessorInformationEx](https://learn.microsoft.com/windows/win32/api/sysinfoapi/nf-sysinfoapi-getlogicalprocessorinformationex) pour déterminer la classe d'efficacité de chaque processeur du système. Parcourez les données renvoyées par la fonction à la recherche d'un bloc [RelationProcessorCore](https://learn.microsoft.com/windows/win32/api/winnt/ns-winnt-processor_relationship) contenant la classe d'efficacité et le masque de cœur.
```cpp theme={null}
char* processorInfoData = nullptr;
DWORD processorInfoDataSize = 0;
GetLogicalProcessorInformationEx(RelationAll, nullptr, &processorInfoDataSize);
processorInfoData = new char[processorInfoDataSize];
GetLogicalProcessorInformationEx(RelationAll, processorInfoData, &processorInfoDataSize);
auto workingDataBuffer = processorInfoData;
auto dataLeft = processorInfoDataSize;
while (dataLeft)
{
auto procInfo = (SYSTEM_LOGICAL_PROCESSOR_INFORMATION_EX*) workingDataBuffer;
switch (procInfo->Relationship)
{
case RelationProcessorCore:
{
processorEfficiency[procInfo->Processor.GroupMask[0].Mask] =
procInfo->Processor.EfficiencyClass;
}
break;
}
dataLeft -= procInfo->Size;
workingDataBuffer += procInfo->Size;
}
```
### Épinglage des threads en fonction de la consommation d'énergie
Comme indiqué, l'épinglage sur des cœurs au moyen de l'affinité n'est pas recommandé dans l'environnement de bureau en raison des interférences possibles d'autres processus sur la machine. Toutefois, Windows permet à un titre de fournir des indications au système d'exploitation pour recommander où le travail doit être exécuté. L'un des moyens de fournir ces indications consiste à utiliser les API de gestion de l'alimentation.
```cpp theme={null}
THREAD_POWER_THROTTLING_STATE PowerThrottling;
ZeroMemory(&PowerThrottling, sizeof(PowerThrottling));
PowerThrottling.Version = THREAD_POWER_THROTTLING_CURRENT_VERSION;
//
// EcoQoS
// Turn EXECUTION_SPEED throttling on.
// ControlMask selects the mechanism
// and StateMask declares which mechanism should be on or off.
//
PowerThrottling.ControlMask = THREAD_POWER_THROTTLING_EXECUTION_SPEED;
PowerThrottling.StateMask = THREAD_POWER_THROTTLING_EXECUTION_SPEED;
SetThreadInformation(GetCurrentThread(),
ThreadPowerThrottling,
&PowerThrottling,
sizeof(PowerThrottling));
//
// HighQoS
// Turn EXECUTION_SPEED throttling off.
// ControlMask selects the mechanism
// and StateMask is set to zero as mechanisms should be turned off.
//
PowerThrottling.ControlMask = THREAD_POWER_THROTTLING_EXECUTION_SPEED;
PowerThrottling.StateMask = 0;
SetThreadInformation(GetCurrentThread(),
ThreadPowerThrottling,
&PowerThrottling,
sizeof(PowerThrottling));
//
// Let system manage all power throttling. ControlMask is set to 0 as we don't want
// to control any mechanisms.
//
PowerThrottling.ControlMask = 0;
PowerThrottling.StateMask = 0;
SetThreadInformation(GetCurrentThread(),
ThreadPowerThrottling,
&PowerThrottling,
sizeof(PowerThrottling));
```
### Utilisation des CPU Sets pour interroger la classe d'efficacité
L'utilisation des [CPU Sets](https://learn.microsoft.com/windows/win32/procthread/cpu-sets) est une autre méthode permettant d'interroger la classe d'efficacité de chaque cœur du système.
```cpp theme={null}
bool QueryCPUSets()
{
ULONG requiredSize = 0;
(void)GetSystemCpuSetInformation(nullptr, 0, &requiredSize, GetCurrentProcess(), 0);
if (requiredSize == 0)
return false;
std::vector rawBuffer(requiredSize);
PSYSTEM_CPU_SET_INFORMATION cpuSets =
reinterpret_cast(rawBuffer.data());
if (!GetSystemCpuSetInformation(cpuSets, requiredSize,
&requiredSize, GetCurrentProcess(), 0))
return false;
std::vector cores;
std::map efficiencyLevelCounts;
uint8_t* current = rawBuffer.data();
uint8_t* end = current + requiredSize;
while (current < end)
{
PSYSTEM_CPU_SET_INFORMATION info =
reinterpret_cast(current);
if (info->Type == CpuSetInformation)
{
CoreEfficiencyInfo coreInfo = {};
coreInfo.cpuSetId = info->CpuSet.Id;
coreInfo.coreIndex = info->CpuSet.CoreIndex;
coreInfo.logicalProcessorIndex = info->CpuSet.LogicalProcessorIndex;
coreInfo.efficiencyClass = info->CpuSet.EfficiencyClass;
coreInfo.group = info->CpuSet.Group;
cores.push_back(coreInfo);
efficiencyLevelCounts[coreInfo.efficiencyClass]++;
}
current += info->Size;
}
return true;
}
```
### Utilisation des CPU Sets pour attribuer des threads à des classes d'efficacité
Les [CPU Sets](https://learn.microsoft.com/windows/win32/procthread/cpu-sets) peuvent également être utilisés au lieu de définir explicitement le masque d'affinité d'un thread. Il est recommandé d'utiliser les CPU Sets plutôt que des masques d'affinité explicites.
```cpp theme={null}
bool LockThreadToEfficiencyClass1(HANDLE thread,
const std::vector& cores,uint32_t efficiencyClass)
{
std::vector cpuSetIds;
for (const auto& core : cores)
{
if (core.efficiencyClass == efficiencyClass)
{
cpuSetIds.push_back(core.cpuSetId);
}
}
if (cpuSetIds.empty())
return false;
if (!SetThreadSelectedCpuSets(thread, cpuSetIds.data(),
static_cast(cpuSetIds.size())))
return false;
return true;
}
```
## Related topics
- [Environnement et outils de développement de jeux sur PC](/fr/tools/tools-pc/gc-tools-pc-toc.md)
- [Environnement et outils de développement de jeux sur console XBOX](/fr/tools/tools-console/gc-tools-console-toc.md)
- [Gestion de la mémoire dans le SDK unifié PlayFab](/fr/services/playfab/sdks/unified-sdk/memory-management.md)
- [Optimisation guidée par profil dans Visual Studio](/fr/tools/tools-console/pgo/pgo_full.md)
- [Métriques des machines virtuelles](/fr/services/playfab/multiplayer/servers/vm-metrics.md)