> ## Documentation Index
> Fetch the complete documentation index at: https://devdocs.xbox.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Accès mémoire du GPU de la XBOX One : ONION, GARLIC et plus encore
> Accès mémoire du GPU de la XBOX One : ONION, GARLIC et plus encore
Ce document aborde certains aspects du système mémoire du GPU de la XBOX One du point de vue des performances d'un titre exécuté sur le système d'exploitation exclusif. Les sujets abordés incluent les bus ONION et GARLIC, l'ESRAM, la hiérarchie des caches de textures, ainsi que la manière d'éviter les pièges de performances et d'exactitude lors du partage de données entre le CPU et le GPU.
L'accès mémoire sur la XBOX One est complexe. De nombreux facteurs influent sur les performances, souvent de manière peu intuitive. Pour maximiser l'utilisation de la bande passante et proposer des jeux de la plus haute qualité, vous devez comprendre les effets que les différentes actions d'un titre peuvent avoir sur les performances d'accès mémoire.
## Vue d'ensemble du matériel
La console XBOX One contient 8 Go de mémoire DDR3 unifiée, dont 5 Go sont accessibles aux titres du système d'exploitation exclusif. Cette mémoire est répartie en quatre canaux qui se connectent à quatre contrôleurs DRAM (DCT) dans le Northbridge unifié (UNB). Chaque canal fournit 17 gigaoctets par seconde (Go/s) de bande passante maximale partagée entre lectures et écritures, soit un total de 68 Go/s de bande passante maximale entre la mémoire principale et l'UNB.
Les deux modules CPU se connectent aux DCT via le contrôleur mémoire (MCT). Le MCT fournit également l'accès mémoire à d'autres composants du système, tels que le Southbridge et le processeur audio SHAPE.
**Figure 1. Interaction entre le GPU de la XBOX One et le matériel mémoire** 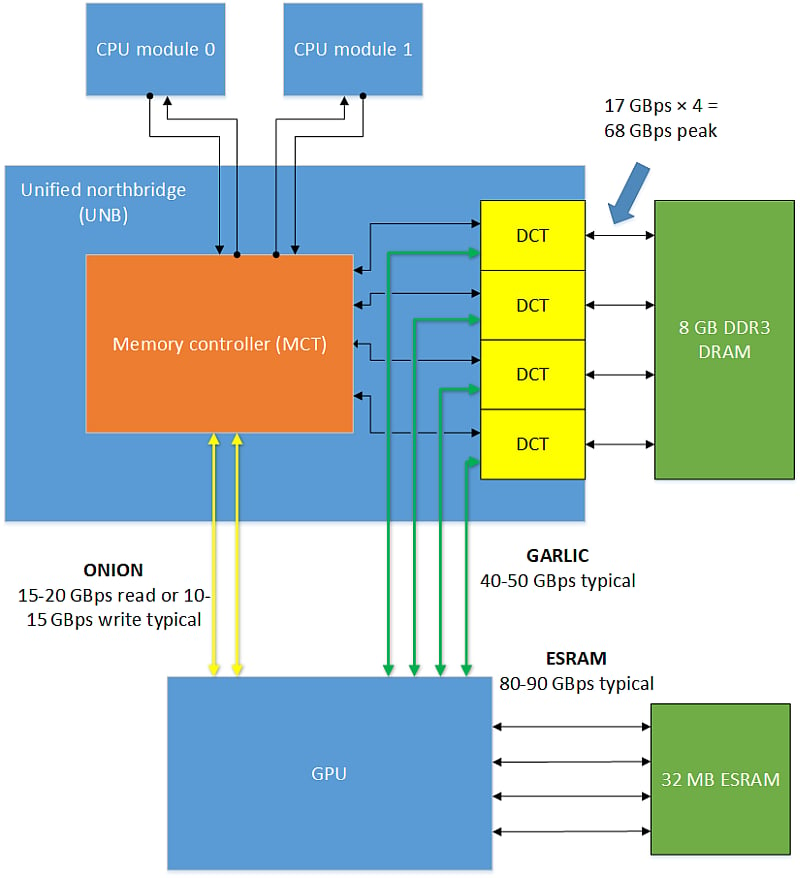 Le GPU de la XBOX One peut accéder à la mémoire principale via deux bus différents :
* Le bus *graphics accelerated reduced latency integrated channel* (GARLIC) est un bus à quatre canaux capable d'une bande passante maximale de 68 Go/s (limitée par la bande passante de la DRAM). Chacun des quatre canaux GARLIC est connecté directement à l'un des quatre contrôleurs DRAM.
* Le bus *on-chip Northbridge to I/O noncoherent* (ONION) est un bus à deux canaux capable d'une bande passante maximale de 24 Go/s en lecture ou de 15 Go/s en écriture, limitée par des composants du Northbridge. Les deux canaux ONION se connectent au MCT, qui confère au bus ONION certaines capacités supplémentaires dont GARLIC ne dispose pas. Certains types de trafic doivent utiliser le bus ONION.
Le bus utilisé pour une transaction mémoire donnée dépend des caractéristiques de la mémoire consultée et de l'opération effectuée.
La *bande passante maximale* est la quantité de données qui serait transférée par seconde si le bus était pleinement utilisé, c'est-à-dire s'il transmettait des données utiles à chaque cycle d'horloge. En pratique, cela est impossible à atteindre. Divers facteurs se combinent pour réduire la bande passante effective disponible pour le GPU, notamment la contention avec d'autres consommateurs, les bulles introduites par la latence des requêtes et des interactions subtiles entre différents composants du système. Dans des scénarios de rendu réels typiques, vous pouvez vous attendre à atteindre environ 40-50 Go/s de lecture et d'écriture combinées sur le bus GARLIC, et 15-20 Go/s en lecture ou 10-15 Go/s en écriture (pas simultanément) sur le bus ONION.
Les contrôleurs mémoire du GPU contiennent de petites files d'attente d'écriture FIFO conçues pour empêcher que de brefs pics d'activité mémoire ne bloquent le reste du pipeline. Si ces files d'attente sont pleines, le GPU ne peut pas émettre d'opérations mémoire supplémentaires. Lorsque le trafic sature le bus ONION pendant de longues périodes, les files d'attente d'écriture peuvent se remplir. Dans ce cas, tous les accès mémoire du GPU, y compris les accès à GARLIC et à l'ESRAM, peuvent se retrouver limités par la bande passante du bus ONION.
## ESRAM
La XBOX One contient également 32 Mo d'ESRAM haute vitesse connectée au GPU via un bus dédié. Le bus ESRAM se compose de quatre canaux fonctionnant à 853 MHz. Dans des circonstances ordinaires, chaque canal peut transférer 32 o par cycle d'horloge (en lecture ou en écriture), ce qui donne une bande passante théorique de :
4 canaux × 32 o par cycle × 853 MHz = 109,2 Go/s (avec 1 Go = 109 o)
Dans certaines circonstances, le GPU peut émettre des requêtes de lecture en rafale vers l'ESRAM. Pendant qu'une lecture en rafale est traitée, le GPU peut continuer à émettre des opérations d'écriture, ce qui permet en pratique aux lectures et aux écritures de se dérouler en parallèle. Cela peut porter la bande passante atteignable au-delà du maximum de 109,2 Go/s. La bande passante soutenue maximale observée par l'ATG lors d'expériences est d'environ 133 Go/s, avec 80-90 Go/s typiquement dans des scénarios de rendu standard.
## Caches de textures du GPU
Le GPU contient des caches de textures L1 et L2 qui servent à atténuer la latence élevée des opérations mémoire. Le terme *cache de textures* est quelque peu trompeur : les caches de textures sont utilisés pour tous les accès mémoire qui ne sont pas gérés par les blocs de couleur et de profondeur (CB/DB), notamment les extractions de textures, les lectures de mémoires tampons et les lectures et écritures de vues d'accès non ordonné (UAV).
**Figure 2. Hiérarchie des caches de textures de la XBOX One**
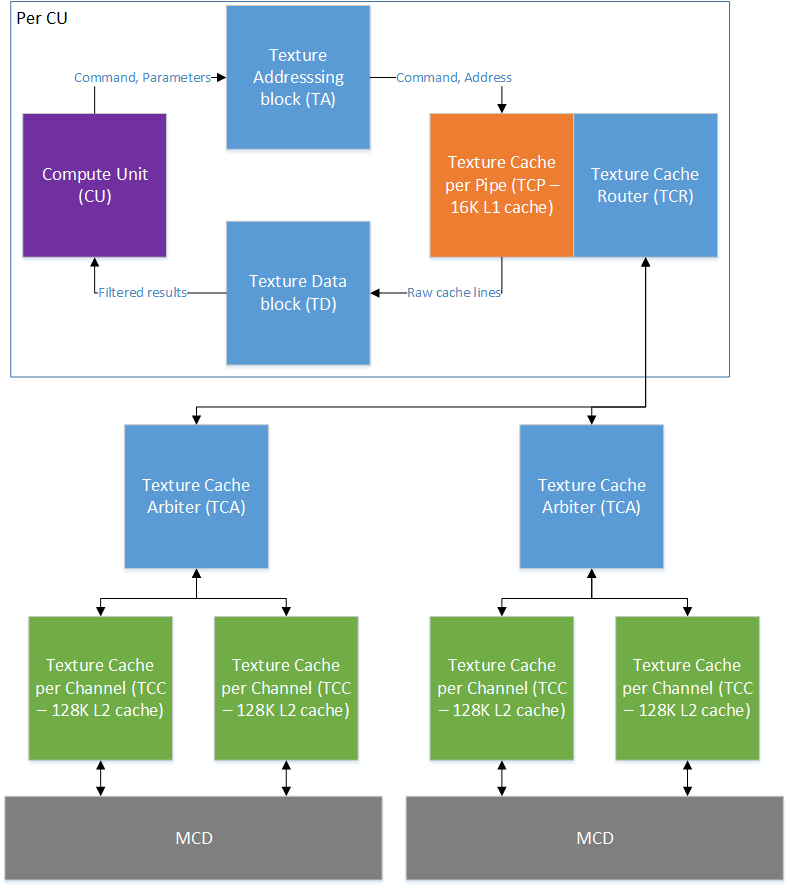 Il est important de comprendre les composants du sous-système de cache lorsque vous interprétez les compteurs de performances liés à la mémoire dans PIX. Si un appel de dessin ou une distribution de compute shader semble limité par l'accès mémoire alors que le débit du bus est loin de son maximum, le goulot d'étranglement peut se situer quelque part dans la hiérarchie des caches.
Le diagramme de la figure 2 montre les composants suivants du sous-système de cache de textures :
**Texture Addressing Block (TA)** Il existe un TA par unité de calcul (CU). Chaque TA reçoit les requêtes de lecture et d'écriture de la CU et calcule les adresses mémoire appropriées à transmettre au TCP. Pour les écritures, le TA convertit les valeurs reçues de la CU au format de données cible et transmet les données converties au TCP. Il fusionne également les requêtes mémoire (voir « Accès fusionnés » plus loin dans ce document).
**Texture Data Block (TD)** Le TD reçoit la mémoire brute du TCP et, en fonction du format de données sélectionné, extrait les valeurs à transmettre à la CU. Il effectue également le filtrage des textures.
**Texture Cache per Pipe (TCP)** Il existe un TCP par CU. Chacun sert de cache de données L1 de 16 Ko pour la CU. Si une requête de lecture échoue dans le cache TCP (miss), elle est transmise au TCR.
**Texture Cache Router (TCR)** Il existe un TCR par CU, chacun étant associé à un TCP. Le TCR transmet les requêtes du TCP associé aux TCA appropriés ; il renvoie également les données des TCA au TCP.
**Texture Cache Arbiter (TCA)** Le TCA gère les flux de requêtes et de données d'une paire de TCC. Il met également en mémoire tampon les requêtes provenant des TCR et achemine chaque requête vers le TCC approprié.
**Texture Cache per Channel (TCC)** Il existe quatre TCC au total ; chaque TCC est approximativement associé à l'un des quatre canaux mémoire. Chaque TCC contient 128 Ko de mémoire cache, soit un total de 512 Ko de cache L2. Les requêtes qui échouent dans le cache TCC sont transmises au MCD approprié.
**Memory Controller, Data (MCD)** Le MCD gère une paire de canaux mémoire et achemine les requêtes vers l'ESRAM et la mémoire principale sur le bus approprié.
## Accès fusionnés
Pour un SIMD donné, le TA/TCP peut traiter quatre extractions par cycle, de 128 bits (16 octets) au maximum chacune, soit un total de 512 bits (64 octets) extraits par cycle. Cela signifie qu'une instruction de lecture mémoire nécessite normalement 16 cycles d'horloge (64 threads ÷ 4 threads par cycle) pour être émise sur un wavefront entier.
Si une instruction de lecture demande moins de 128 bits à la mémoire, une partie du bus de retour de données de 512 bits reste inutilisée. Par exemple, si chaque thread d'un wavefront demande une seule valeur à virgule flottante (32 bits) à une ressource de texture ou de mémoire tampon, seuls 128 bits au total (4 requêtes × 32 bits) sont extraits à chaque cycle. Cela ne représente qu'un quart du débit maximal possible.
Lors de la lecture de valeurs à une seule composante depuis une texture en HLSL, les méthodes Gather peuvent être utilisées pour extraire quatre valeurs à la fois, ce qui améliore l'utilisation du bus de retour de données. Cependant, Gather n'est pas pris en charge pour les ressources de mémoire tampon. En revanche, lors de la lecture depuis une ressource de mémoire tampon, si des threads adjacents accèdent à des emplacements mémoire adjacents, le TA peut, dans certaines circonstances, fusionner les requêtes. Une situation courante où les lectures peuvent être fusionnées est celle où les 16 threads d'un quart de wavefront accèdent à une plage contiguë, alignée sur une ligne de cache, d'éléments 32 bits d'un UAV ou d'une mémoire tampon structurée. Cela permet d'émettre les 16 extractions en un seul cycle, fusionnées en quatre lectures contiguës de 128 bits. En général, pour obtenir la fusion, préférez les dispositions de mémoire tampon de type structure de tableaux (SoA) aux dispositions de type tableau de structures (AoS).
## Exemple
Dans l'exemple suivant, un simple appel de distribution de compute shader est analysé à l'aide des compteurs de performances de PIX afin de détecter un goulot d'étranglement lié au sous-système de cache.
| Nom | Analyse ?? | VALUBusy(% ?? | WaitingVMCounter(% ?? | WaitingVMEM(% ?? | TexUnitBusy(% ?? |
| - | - | - | - | - | - |
| IT\_DISPATCH\_DIRECT | 89,500 | 1,278 | 3,792 | 44.636 | 97.079 |
Cet appel de distribution passe environ 45 % de son temps à attendre pour émettre des instructions de mémoire vectorielle, et l'unité de texture est occupée près de 100 % du temps.
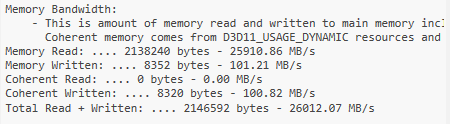 Les statistiques Memory Bandwidth de Dr. PIX révèlent que tout le trafic mémoire de cette distribution passe par le bus GARLIC. Cependant, la distribution n'atteint qu'un débit effectif de 26 Go/s, soit environ 50 % d'utilisation du bus. Cela signifie que le bus n'est probablement pas un goulot d'étranglement.
| GBRM\_PERF\_SEL\_GUI\_ACTIVE | TA\_PERF\_SEL\_TA\_BUSY | TCP\_PERF\_SEL\_TCP\_TA\_ADDR\_STALL\_CYCLES |
| - | - | - |
| 60,360 | 58,910 | 56,086 |
Le compteur GBRM\_PERF\_SEL\_GUI\_ACTIVE indique le nombre de cycles pendant lesquels le GPU était actif, tandis que TA\_PERF\_SEL\_TA\_BUSY indique le nombre de cycles pendant lesquels le TA était occupé. TCP\_PERF\_SEL\_TCP\_TA\_ADDR\_STALL\_CYCLES indique le nombre de cycles pendant lesquels le TA a été bloqué par le TCP. Dans ce cas, le TA a été bloqué pendant presque toute la durée de la distribution.
| TCP\_PERF\_SEL\_TCR\_TCP\_STALL\_CYCLES |
| - |
| 145 |
TCP\_PERF\_SEL\_TCR\_TCP\_STALL\_CYCLES indique le nombre de cycles pendant lesquels le TCP a été bloqué par le TCR. Si la distribution était limitée par le cache L2 ou par le bus mémoire, ce nombre devrait être élevé par rapport à TCP\_PERF\_SEL\_TCP\_TA\_ADDR\_STALL\_CYCLES. Comme ce nombre est faible, le blocage se produit très probablement à l'intérieur du TCP.
| TCP\_PERF\_SEL\_READCONFLICT\_STALL\_CYCLES | TCP\_PERF\_SEL\_READ\_TAGCONFICT\_STALL\_CYCLES |
| - | - |
| 33,024 | 33,024 |
En examinant de plus près les autres compteurs TCP, on constate que les valeurs de TCP\_PERF\_SEL\_READCONFLICT\_STALL\_CYCLES et de TCP\_PERF\_SEL\_READ\_TAGCONFICT\_STALL\_CYCLES sont assez élevées. Les descriptions de ces compteurs montrent clairement que les opérations de lecture sont bloquées en raison de la contention pour des ressources limitées à l'intérieur du TCP.
| TA\_PERF\_SEL\_BUFFER\_COALESCED | TA\_PERF\_SEL\_BUFFER\_TOTAL\_CYCLES |
| - | - |
| 0 | 11,088 |
Enfin, la comparaison de TA\_PERF\_SEL\_BUFFER\_COALESCED avec TA\_PERF\_SEL\_BUFFER\_TOTAL\_CYCLES montre qu'aucune opération de lecture n'est fusionnée.
Voici le code du shader de l'appel de distribution précédent :
```cpp theme={null}
struct BufferElement
{
float data[16]; // 16 floats = 64 bytes = one cache line
};
StructuredBuffer g_Buffer : register(b0);
RWStructuredBuffer g_RWDummyBuffer : register(b1);
[numthreads(64, 1, 1)]
void CS( uint3 DispatchThreadID : SV_DispatchThreadID )
{
uint thread = DispatchThreadID.x;
float n = 0;
for( int i = 0; i < 16; ++i )
{
n += g_Buffer[ thread ].data[ i ];
}
// Force compiler to retain the calculation, but don't do anything with it
if( n == 12345678 )
{
g_RWDummyBuffer[ thread ].data[ 0 ] = n;
}
}
```
Cet exemple est quelque peu artificiel, mais vous pouvez constater que ce shader lit 16 valeurs à virgule flottante depuis une mémoire tampon structurée. Chaque thread lit dans une ligne de cache distincte, ce qui signifie que le TA ne peut pas fusionner les lectures.
Pour faciliter la fusion des lectures, la disposition des données de la mémoire tampon peut être réorganisée comme suit. Notez les parties modifiées du code :
```cpp theme={null}
struct BufferElement
{
float data;
};
StructuredBuffer g_Buffer[16];
RWStructuredBuffer g_RWDummyBuffer : register(b1);
[numthreads(64, 1, 1)]
void CS( uint3 DispatchThreadID : SV_DispatchThreadID )
{
uint thread = DispatchThreadID.x;
float n = 0;
for( int i = 0; i < 16; ++i )
{
n += g_Buffer[i][ thread ].data;
}
// Force compiler to retain all the calculation, but don't do anything with it
if( n.x == 12345678 )
{
g_RWDummyBuffer[ thread ].data = n;
}
}
```
Avec cette disposition des données, les 16 threads d'un quart de wavefront lisent des valeurs contiguës dans la même ligne de cache. Cela donne les résultats suivants.
| TA\_PERF\_SEL\_BUFFER\_COALESCED\_READ\_CYCLES | TA\_PERF\_SEL\_BUFFER\_TOTAL\_CYCLES |
| - | - |
| 2,752 | 2,752 |
Le compteur TA\_PERF\_SEL\_BUFFER\_COALESCED\_READ\_CYCLES indique que les lectures sont fusionnées.
| Nom | Analyse ? | GRBM\_PERF\_SEL\_GUI\_ACTIVE | TexUnitBusy (% ?? |
| - | - | - | - |
| IT\_DISPATCH\_DIRECT | 41,660 | 43,176 | 77,561 |
Le temps GPU total diminue considérablement, tout comme l'utilisation de l'unité de texture.
| TCP\_PERF\_SEL\_READCONFLICT\_STALL\_CYCLES | TCP\_PERF\_SEL\_READ\_TAGCONFLICT\_STALL\_CYCLES | TCP\_PERF\_SEL\_TCR\_TCP\_STALL\_CYCLES |
| - | - | - |
| 0 | 0 | 29,166 |
Les blocages précédemment rencontrés à l'intérieur du TCP disparaissent ; le TCP devient limité par le TCC et/ou le bus mémoire.
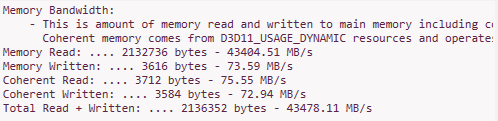 Et bien que la même quantité de données soit lue depuis la mémoire principale, le débit effectif du bus passe à 43 Go/s, ce qui est beaucoup plus proche de la bande passante maximale atteignable.
## Cohérence mémoire et indicateurs d'accès
Le CPU et le GPU contiennent tous deux des caches à écriture différée (write-back) conçus pour réduire l'impact des accès à la mémoire principale sur les performances. Lorsque des données sont partagées entre le CPU et le GPU, veillez à ce qu'aucun des deux ne lise des données obsolètes depuis le cache. Le trafic mémoire généré par le GPU peut être *non cohérent* ou *cohérent E/S*, selon les indicateurs du descripteur de page de la mémoire consultée.
Le trafic non cohérent se comporte essentiellement comme si le CPU n'existait pas. Il peut généralement utiliser le bus GARLIC, plus rapide, avec les résultats suivants :
**Lectures GPU** Si un emplacement mémoire donné est présent dans l'un des caches du GPU, une lecture GPU de cet emplacement renvoie la valeur mise en cache. Le GPU extrait les lignes de cache directement depuis la DRAM. Le GPU n'examine pas les caches du CPU.
**Écritures GPU** Lorsqu'une ligne de cache modifiée est évincée du cache L2 du GPU, elle est écrite directement dans la DRAM. Les caches du CPU peuvent contenir des valeurs obsolètes.
Le trafic cohérent E/S espionne (snoop) les caches du CPU via le MCT du Northbridge. Le trafic cohérent E/S peut constituer un goulot d'étranglement des performances, car il doit utiliser le bus ONION, plus lent, avec les résultats suivants :
**Lectures GPU** Lors de l'extraction d'une ligne de cache depuis la mémoire principale, le GPU sonde d'abord les caches du CPU. Si l'emplacement mémoire donné n'est pas présent dans les caches du CPU, le GPU extrait la valeur depuis la DRAM.
**Écritures GPU** Lorsqu'une ligne de cache modifiée est évincée du cache L2 du GPU, le GPU sonde les caches du CPU et invalide toutes les entrées qui font référence à l'emplacement modifié. Le GPU écrit ensuite la ligne de cache modifiée dans la DRAM.
La cohérence E/S vous permet d'éviter des vidages coûteux du cache du CPU après l'écriture dans une ressource sur le CPU. La cohérence E/S est donc utile pour les petites ressources fréquemment mises à jour, comme les mémoires tampons de constantes. Cependant, la cohérence E/S ne fonctionne que dans un sens : le GPU espionne les caches du CPU, mais pas l'inverse. Cela signifie que les caches du GPU doivent toujours être vidés si la ressource est modifiée par le CPU ou par le GPU.
Lorsque vous allouez de la mémoire principale via **D3DAllocateGraphicsMemory**, vous pouvez choisir l'un des trois types de mémoire suivants :
**Mise en cache non cohérente (Cached Noncoherent)**
* D3D11\_GRAPHICS\_MEMORY\_ACCESS\_CPU\_CACHE\_NONCOHERENT
* La mémoire est mise en cache à la fois par le CPU et par le GPU.
* L'accès mémoire du GPU est non cohérent et peut généralement utiliser le bus GARLIC.
* Si la mémoire est écrite par le CPU, les plages appropriées des caches du CPU et du GPU doivent être vidées avant la lecture sur le GPU.
* La mémoire mise en cache non cohérente n'est pas recommandée pour les scénarios impliquant des écritures GPU et des lectures CPU, car ils sont dangereux et difficiles à réaliser correctement.
**Mise en cache cohérente (Cached Coherent)**
* D3D11\_GRAPHICS\_MEMORY\_ACCESS\_CPU\_CACHE\_COHERENT
* La mémoire est mise en cache à la fois par le CPU et par le GPU.
* L'accès mémoire du GPU est cohérent E/S et utilise toujours le bus ONION.
* Si la mémoire est écrite par le GPU, la plage appropriée des caches du GPU doit être vidée avant la lecture sur le CPU.
* Si la mémoire est écrite par le CPU, la plage appropriée des caches du GPU doit être vidée avant la lecture sur le GPU.
**Écriture combinée non cohérente (Write Combined Noncoherent)**
* D3D11\_GRAPHICS\_MEMORY\_ACCESS\_CPU\_WRITECOMBINE\_NONCOHERENT
* Les pages mémoire sont mises en cache par le GPU, mais pas par le CPU.
* Les écritures CPU sont combinées (write combined).
* L'accès mémoire du GPU est non cohérent et peut généralement utiliser le bus GARLIC.
Si la mémoire est écrite par le CPU, les mémoires tampons d'écriture combinée doivent être vidées (au moyen d'une barrière mémoire d'écriture), et la plage appropriée des caches du GPU doit être vidée avant l'accès sur le GPU.
Les caches du CPU peuvent être vidés à l'aide de **D3DFlushCpuCache**. Les caches du GPU peuvent être vidés à l'aide de ID3DXboxPerformanceContext::FlushGpuCaches ou ID3DXboxPerformanceContext::FlushGpuCacheRange. Le pilote XBOX One ne vide pas automatiquement les caches du CPU ou du GPU lors d'un appel à **Map** ou **Unmap**.
## Ressources à utilisation par défaut (DEFAULT)
Les fonctions de définition par placement, telles que **CSSetPlacementConstantBuffer**, permettent de mettre à jour rapidement et en toute sécurité une ressource DEFAULT tout en la liant simultanément au pipeline de rendu. Nous recommandons vivement aux titres d'utiliser les fonctions de définition par placement pour les mises à jour de ressources chaque fois que possible. Toutefois, pour faciliter le portage des moteurs Direct3D 11 existants, il est également possible de mettre à jour les ressources DEFAULT à l'aide de **Map** et **Unmap**.
Lorsque vous mappez une ressource à utilisation DEFAULT, vous devez passer l'indicateur D3D11\_MAP\_FLAG\_ALLOW\_USAGE\_DEFAULT :
```cpp theme={null}
D3D11_MAPPED_SUBRESOURCE MapData = {};
m_pd3dContext->Map(pCurrentCBVertex, 0, D3D11_MAP_WRITE_NO_OVERWRITE, D3D11_MAP_FLAG_ALLOW_USAGE_DEFAULT, &MapData);
```
Notez également le type de mappage. Les types de mappage autorisés pour les ressources à utilisation DEFAULT sur le contexte immédiat sont :
* **MAP\_READ**
* **MAP\_WRITE**
* **MAP\_READWRITE**
* **MAP\_WRITE\_NO\_OVERWRITE**
Les contextes différés ne prennent en charge que **MAP\_WRITE\_NO\_OVERWRITE**, qui est implémenté comme **MAP\_WRITE**, mais sans vérification de la synchronisation CPU-GPU. Utilisez donc ce type de mappage avec prudence.
Les trois autres types de mappage effectuent les vérifications de synchronisation appropriées avant de renvoyer le pointeur de mémoire CPU. Cette synchronisation peut entraîner un blocage du CPU si la ressource est encore utilisée par le GPU. Pour éviter de tels blocages, les titres doivent utiliser une double mise en mémoire tampon pour les ressources fréquemment mises à jour.
Dans les XDK de juillet et d'août, le pilote alloue les ressources à utilisation DEFAULT dans de la mémoire mise en cache non cohérente. Dans une future version du XDK, le type de mémoire par défaut deviendra l'écriture combinée non cohérente. Si vous souhaitez remplacer le type de mémoire par défaut, vous pouvez utiliser les API de création de ressources par placement pour créer des ressources dans de la mémoire précédemment allouée via **D3DAllocateGraphicsMemory**.
## Chiffrement de la mémoire et écritures partielles
La mémoire des titres sur XBOX One peut éventuellement être chiffrée dans la DRAM. Les DCT effectuent le chiffrement et le déchiffrement avec une granularité de 16 octets (128 bits). Pour cette raison, les requêtes de lecture et d'écriture adressées aux DCT pour de la mémoire chiffrée doivent être un multiple de 16 octets.
Les écritures partielles (c'est-à-dire les écritures de moins de 16 octets) nécessitent une opération de lecture-modification-écriture : le bloc de 16 octets qui contient la cible doit être extrait du DCT approprié, modifié, puis renvoyé au DCT pour être écrit dans la DRAM. Les opérations de lecture-modification-écriture consomment davantage de bande passante DRAM que les opérations de lecture ou d'écriture standard. En outre, le GPU n'est pas en mesure d'effectuer des opérations de lecture-modification-écriture via le bus GARLIC ; les écritures partielles dans la mémoire chiffrée sont donc contraintes d'utiliser le bus ONION, plus lent.
Bien que le chiffrement soit effectué sur des blocs de 16 octets, l'interface mémoire entre le GPU et les bus ONION et GARLIC a une largeur de 32 octets. Par conséquent, lorsqu'une modification partielle porte sur le premier ou le second mot d'un bloc de 32 octets, la transaction entière de 32 octets est acheminée via ONION.
Les écritures partielles peuvent avoir de nombreuses causes, notamment (liste non exhaustive) :
* Les écritures masquées dans des ressources, par exemple en effectuant un dessin avec le membre RenderTargetWriteMask de la **structure D3D11\_RENDER\_TARGET\_BLEND\_DESC** défini sur une valeur autre que D3D11\_COLOR\_WRITE\_ENABLE\_ALL.
* Les petites écritures dispersées dans un UAV dans un compute shader.
* La rastérisation de primitives ayant une faible efficacité de quad, notamment les points, les lignes et les petits triangles.
* Le déversement en mémoire de structures de données internes du GPU.
Pour aider à éviter les pénalités de performances causées par les écritures partielles dans la mémoire chiffrée, les titres peuvent spécifier quelles pages doivent être chiffrées. Toute page qui n'est pas mappée avec MEM\_GRAPHICS est chiffrée. Les pages mappées avec MEM\_GRAPHICS sont chiffrées si un ou plusieurs des indicateurs suivants sont spécifiés pour la page : PAGE\_GPU\_READONLY, PAGE\_GPU\_COHERENT ou PAGE\_GPU\_EXECUTE. Dans le cas contraire, la page est stockée non chiffrée. Les types de mémoire [XMemAlloc](/fr/reference/system/xmem/functions/xmemalloc) pour les allocations graphiques correspondent aux combinaisons d'indicateurs de protection de page présentées dans le tableau suivant.
*Types de mémoire XMemAlloc*
| Type de mémoire | Indicateurs de protection | | |
| - | - | - | - |
| XALLOC\_MEMTYPE\_GRAPHICS\_WRITECOMBINE | 0 | | |
| XALLOC\_MEMTYPE\_GRAPHICS\_WRITECOMBINE\_GPU\_READONLY | PAGE\_GPU\_READONLY | | |
| XALLOC\_MEMTYPE\_GRAPHICS\_CACHEABLE | PAGE\_GPU\_COHERENT | | |
| XALLOC\_MEMTYPE\_GRAPHICS\_CACHEABLE\_NONCOHERENT | 0 | | |
| XALLOC\_MEMTYPE\_GRAPHICS\_COMMAND\_BUFFER\_WRITECOMBINE | PAGE\_GPU\_EXECUTE | PAGE\_GPU\_READONLY | |
| XALLOC\_MEMTYPE\_GRAPHICS\_COMMAND\_BUFFER\_CACHEABLE | PAGE\_GPU\_EXECUTE | PAGE\_GPU\_READONLY | PAGE\_GPU\_COHERENT |
## Transactions du hub
Le GPU contient quatre render backends (RB) qui reçoivent les informations finales de couleur et de profondeur d'un événement de dessin. Un pixel est attribué à un RB en fonction de sa position dans l'espace écran : l'écran est divisé selon un motif en damier de super-tuiles de 32×32 pixels, et les super-tuiles adjacentes sont attribuées à des moteurs de shader différents. Au sein d'une super-tuile, chaque sous-bloc de 8×8 pixels correspond à un RB différent.
Chaque RB est connecté à l'un des quatre canaux GARLIC. Une cible de rendu créée avec un mode de tuilage 2D (tel que XG\_TILE\_MODE\_2D\_THIN) peut écrire ses données de pixels directement dans la DRAM via le canal GARLIC connecté. En revanche, si la cible de rendu est créée avec un mode de tuilage 1D ou linéaire, certains pixels peuvent devoir être réacheminés vers un autre canal mémoire, ce qui signifie que les données de pixels doivent transiter par le hub du contrôleur de mémoire graphique. Les données de pixels parviennent toujours à la DRAM via le bus GARLIC, mais le passage par le hub réduit considérablement le débit des RB. Pour éviter cette pénalité de performances, utilisez toujours un mode de tuilage 2D pour vos cibles de rendu.
Réduisez également au minimum les écritures dans la mémoire tampon d'arrière-plan (backbuffer). Le contrôleur d'affichage exige un mode de tuilage spécial pour les textures de la mémoire tampon d'arrière-plan, ce qui fait que les écritures dans celle-ci entraînent un grand nombre de transactions du hub.
## Profilage du trafic mémoire dans PIX
PIX propose plusieurs ressources pour profiler le trafic mémoire.
Dans l'onglet [Dr. PIX](/fr/tools/tools-console/pix/gpu/pix-drpix), la section **Memory Bandwidth** affiche la quantité totale de trafic mémoire générée par un appel de dessin particulier ou par la scène entière. Dr. PIX affiche également la quantité de trafic mémoire cohérent. L'exemple suivant montre les détails affichés par la section Memory Bandwidth :
```cpp theme={null}
Memory Bandwidth:
- This is amount of memory read and written to main memory
including coherent memory.
Coherent memory comes from D3D11_USAGE_DYNAMIC resources and
operates at 1/2 rate read and 1/4 rate write.
Memory Read: .... 154830272 bytes - 7044.27 MB/s
Memory Written: .... 143616 bytes - 6.53 MB/s
Coherent Read: .... 14682816 bytes - 668.02 MB/s
Coherent Written: .... 143616 bytes - 6.53 MB/s
Total Read + Written: .... 154973888 bytes - 7050.80 MB/s
```
Ces statistiques sont basées sur OnionReadMem, OnionWriteMem, GarlicReadMem et GarlicWriteMem, qui sont des compteurs dérivés disponibles dans l'onglet **Counters**, dans la section **Memory related**. Les valeurs de bande passante sont calculées en divisant la quantité de mémoire transférée par la durée totale de l'appel de dessin. Des valeurs de bande passante faibles ne signifient pas nécessairement qu'il y a un problème ; cela peut simplement signifier que le dessin n'est pas limité par la bande passante.
Toujours dans l'onglet Dr. PIX, la section **HUB remote transactions** affiche le nombre de lectures et d'écritures qui ont dû transiter par le hub du contrôleur de mémoire graphique. L'exemple suivant montre les détails affichés par la section **HUB remote transactions** :
```cpp theme={null}
HUB remote transactions
HUB pre-translated transactions are very high latency memory transactions
that occur when CB or DB accesses memory in inefficient pattern.
This happens for example when you use linear tiling for your render targets.
Each transaction can be 32 to 256 bytes in size so the number of bytes read
may be variable.
206900 reads, 519594 writes.
```
Ces statistiques sont basées sur HUBRead et HUBWrite, qui sont des compteurs dérivés disponibles dans l'onglet Counters, dans la section Memory related.
L'onglet Resources de PIX décrit les attributs mémoire de chaque ressource liée pendant un appel de dessin, notamment la taille, l'adresse, le mode de tuilage, si la mémoire de la ressource est mise en cache ou non, et si elle est cohérente ou non cohérente.
## Related topics
- [Répertoire des rubriques NDA : liens actifs vers Microsoft Learn](/fr/nda/nda-topic-directory.md)
- [Guide de programmation Direct3D 12](/fr-CA/build/gdk-and-engines/guides/directx-12-programming-guide.md)
- [Aperçu du portage](/fr-CA/paths/porting/overview.md)
- [Vue d'ensemble du portage](/fr/paths/porting/overview.md)
- [Intégration des partenaires XBOX : accès et publication](/fr/home/onboarding.md)