> ## Documentation Index
> Fetch the complete documentation index at: https://devdocs.xbox.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Comment fonctionnent les instructions VMEM ?
> Comment fonctionnent les instructions VMEM ?
Cette rubrique explique la classe d'instructions de shader de mémoire vectorielle. Une bonne compréhension du fonctionnement des instructions VMEM est importante pour prendre les bonnes décisions lors du processus d'optimisation des shaders. Cette rubrique est destinée aux programmeurs graphiques et suppose une certaine familiarité avec le GPU XBOX One et DirectX. Pour un rappel, consultez les documents répertoriés dans la section Références.
Les instructions de mémoire vectorielle transfèrent une ou plusieurs données de manière unique pour chaque thread de shader d'un wavefront. Dans le GPU XBOX One, elles sont utilisées dans tous les types de shaders pour lire les données de sommets, les données de textures et les données de tampons constants indexés dynamiquement, pour lire et écrire des vues d'accès non ordonné, et pour effectuer des opérations atomiques. Alors que les performances des instructions ALU sont prévisibles, celles des instructions de mémoire vectorielle sont plus complexes et nécessitent de comprendre le fonctionnement de plusieurs modules au sein du GPU. Grâce aux informations contenues dans cette rubrique, vous devriez être en mesure d'analyser le code assembleur des shaders dans PIX et d'appliquer des optimisations mémoire à vos shaders.
## Glossaire
Les abréviations et acronymes suivants sont utilisés dans cette rubrique.
| CU | Unité de calcul |
| - | - |
| VALU | Instruction ALU vectorielle |
| SALU | Instruction ALU scalaire |
| VMEM | Instruction de mémoire vectorielle |
| SMEM | Instruction de mémoire scalaire |
| SQ | Séquenceur |
| SGPR | GPR scalaire |
| VGPR | GPR vectoriel |
| TA | Adressage de texture |
| TCP | Cache de texture par pipe (cache L1) |
| TCC | Cache de texture par canal (cache L2) |
| TD | Données de texture |
| LDS | Magasin de données local |
| EXP | Instruction d'exportation de shader |
| Wave | Un wavefront (vague) est une unité de travail composée de 64 threads de shader |
| GLC | Globalement cohérent |
| GDS | Magasin de données global |
| UAV | Vue d'accès non ordonné |
## Instructions de tampon et instructions d'image
Les instructions de tampon sont générées pour les opérations de lecture, d'écriture ou atomiques sur des tampons de sommets, des tampons bruts ou des tampons structurés. Aucun filtrage de données ni aucun échantillonneur n'est pris en charge. Les données transitent par les caches L1 et L2, tant pour les lectures que pour les écritures. Il existe deux types d'instructions de tampon :
**tbuffer\_**\* Instruction de tampon typé. Le format des données est spécifié dans l'instruction et les opérations atomiques ne sont pas prises en charge.
**buffer\_**\* Instruction de tampon non typé. Le format des données est spécifié dans le descripteur de l'objet tampon. Une conversion de format facultative peut être spécifiée dans les instructions. Les opérations atomiques sont prises en charge.
Les instructions d'image sont générées pour les opérations de lecture, d'écriture ou atomiques sur des textures et des surfaces typées. Le filtrage est pris en charge pour la lecture des données. Les données transitent par les caches L1 et L2, tant pour les lectures que pour les écritures. Toutes les instructions d'image disposent d'un champ de masque de données qui spécifie les canaux qu'elles reçoivent. Il existe deux types d'instructions d'image :
**sample\_**\* Lire et filtrer des données à partir d'une texture. Ces opérations nécessitent un échantillonneur.
**image\_**\* Lire, écrire ou effectuer une opération atomique sur une texture. Aucun filtrage n'est pris en charge.
Il existe d'autres types d'instructions de mémoire vectorielle, mais ils sont relativement rares et ne sont pas abordés dans cette rubrique.
## Aide-mémoire : tableau récapitulatif des performances
Il s'agit de valeurs de performances maximales.
| Type de lecture | Coût minimal dans les shaders |
| - | - |
| Lecture de tampon à canal unique | 4 cycles |
| Lecture de tampon multicanal | 16 cycles |
| Opération atomique sur tampon | 16 cycles |
| Fetch de texture à échantillonnage ponctuel | 16 cycles, quel que soit le format |
| Fetch de texture bilinéaire | 16 cycles ≤ 32 bpp, 32 cycles 64 bpp, 64 cycles 128 bpp |
| Fetch de texture trilinéaire | Fetch de texture bilinéaire × 2 |
| Fetch de texture anisotrope xN | (Coût d'un fetch de texture bilinéaire ou d'un fetch de texture trilinéaire) × N |
| Type de lecture | Vitesse maximale sur l'ensemble du GPU |
| - | - |
| Lecture de tampon à canal unique | 192 valeurs 32 bpp par cycle avec coalescence |
| Lecture de texture | 48 par cycle |
| Type de lecture | Vitesse maximale en secondes |
| - | - |
| Lecture ou écriture d'une texture 1080p 32 bpp | 50 μs |
Ces valeurs sont rarement atteignables en pratique, mais il est utile de les garder en tête pour une analyse rapide d'un shader. Voici quelques règles empiriques rapides qui peuvent être déduites du tableau des performances.
* Tout fetch de texture coûte au moins 16 cycles. Rentabilisez-le en lisant autant de données que possible. Gather4 est un outil précieux lorsque vous travaillez avec des textures à canal unique.
* Il est parfois moins coûteux de lire une valeur U32 depuis un tampon à l'aide d'une lecture à canal unique et de la décompresser sur l'ALU que de lire 2 à 4 valeurs d'octets distinctes à l'aide d'une lecture multicanal.
Il est impossible de répertorier les performances des instructions de mémoire vectorielle pour un cas général. La latence réelle des instructions de texture est variable et souvent supérieure à 100 cycles d'horloge ; elle avoisine parfois les 400 cycles d'horloge en cas d'échec d'accès au cache (cache miss).
## Masquage de la latence
En raison de la latence élevée des instructions de mémoire vectorielle, le GPU utilise deux mécanismes de masquage de la latence.
Les instructions de mémoire vectorielle sont conçues pour ne pas bloquer l'exécution du wavefront au moment où elles sont émises. Chaque instruction de mémoire vectorielle émise incrémente un compteur VM, et chaque instruction de mémoire vectorielle retournée décrémente ce compteur. Le compilateur de shaders implémente une synchronisation manuelle en insérant des instructions *s\_waitcnt* avant le point où les résultats sont nécessaires ; sinon, les résultats sont indéfinis. Les instructions de mémoire vectorielle retournent toujours dans l'ordre. Le tableau suivant en présente un exemple.
| image\_sample v\[2:5], v\[2:5], s\[4:11], s\[0:3] dmask:0xf | L'émission de l'instruction commence. Le compteur VM est incrémenté. |
| - | - |
| v\_interp\_p1\_f32 v6, v0, attr2.wv\_interp\_p1\_f32 v7, v0, attr2.zv\_interp\_p2\_f32 v6, v1, attr2.wv\_interp\_p1\_f32 v8, v0, attr2.yv\_interp\_p2\_f32 v7, v1, attr2.z | L'émission de l'instruction se termine. La vague continue d'exécuter des instructions sans blocage, ce qui réduit essentiellement la latence mémoire. Le compilateur de shaders s'efforce de placer du travail ici. |
| s\_waitcnt vmcnt(0) | C'est ici que la latence se manifeste. Si l'instruction mémoire n'est pas encore retournée, le compteur VM vaut toujours 1 et la vague est mise en mode d'attente. |
Si une vague est en mode d'attente, elle ne peut pas poursuivre son exécution tant que le compteur VM est supérieur à la valeur spécifiée dans le paramètre de *s\_waitcnt*. Dans ce cas, la latence est masquée par l'exécution d'autres vagues présentes sur le même SIMD. Plus il y a de vagues disponibles, meilleur est le masquage de la latence. Le nombre de vagues par SIMD est appelé *occupation* (occupancy), et les développeurs doivent s'efforcer de le maximiser. L'occupation mesurée est visible dans les sections ALU et Performance de la rubrique [Dr. PIX](/fr/tools/tools-console/pix/gpu/pix-drpix), ainsi qu'à l'aide des compteurs de colonnes.
Le même mécanisme s'applique aux instructions LDS, SMEM et EXP/GDS. Toutefois, elles utilisent des compteurs différents.
## Vue d'ensemble matérielle d'une unité de texture
Voici une vue d'ensemble schématique de l'unité de texture au sein d'une unité de calcul. Le cache L2 et la mémoire ne sont pas représentés.
**Figure 1. Vue d'ensemble de haut niveau du TA/TCP/TD** 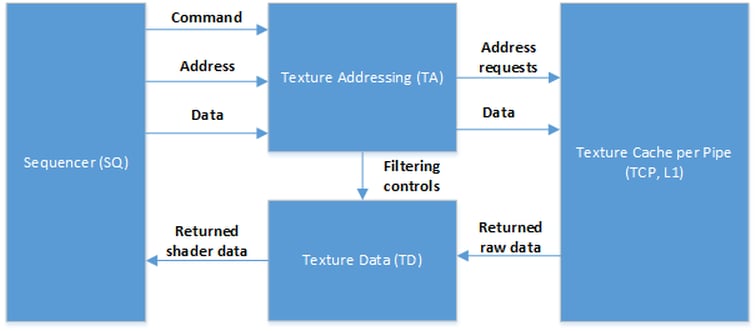 Bien qu'il puisse être utile d'employer le terme « unité de texture », cette unité n'existe pas, car le traitement des instructions mémoire est réparti entre au moins trois blocs différents. De plus, ces blocs sont utilisés dans le GPU XBOX One pour lire et écrire les données des tampons de sommets et des UAV. Par conséquent, parler d'« unité de texture » peut prêter à confusion.
## Le cycle de vie d'une instruction de mémoire vectorielle
Le coût de chaque instruction VMEM comprend le temps d'émission (SQ->TA), le temps d'émission de la requête mémoire (TA->TCP), le temps de lecture mémoire (TCP->TD) et le temps de retour des données (TD->SQ). Il est possible d'être limité par l'une de ces quatre étapes, bien que les jeux soient le plus souvent limités par l'accès mémoire.
### Étape 1 : Émission de l'instruction
Chacune des 12 CU prend en charge jusqu'à 40 vagues. Elles sont réparties en quatre groupes de 10 vagues maximum (un groupe par SIMD) et, à chaque cycle, un SIMD est choisi pour le traitement. Les quatre cycles nécessaires à une CU pour parcourir les quatre SIMD constituent une phase ou un cycle d'attente. À chaque cycle d'horloge, les 10 vagues sont en concurrence pour émettre une instruction de chaque type : VALU, SALU, VMEM, LDS, EXP/GDS et Branch. Pour plus d'informations, consultez le livre blanc *Xbox One GPU Shader Cores*, disponible en téléchargement sur le site XBOX Game Developer (XGD).
Les instructions VMEM utilisent un bus TA unique, partagé par les quatre SIMD. Même si chaque SIMD peut choisir d'émettre une instruction VMEM à chaque cycle d'horloge, le rythme le plus rapide possible est d'une instruction tous les quatre cycles.
Pour émettre une instruction VMEM, les opérandes situés dans les SGPR et les VGPR doivent être transférés au TA. Tant que tous les opérandes de l'instruction n'ont pas été transférés au TA, le wavefront émetteur ne peut pas passer à l'instruction suivante, et aucune autre vague de la CU ne peut utiliser le bus TA. L'émission d'instruction VMEM la plus courte prend quatre cycles, d'où la limite du taux d'émission. Les instructions VMEM, comme certains autres types d'instructions, sérialisent essentiellement les wavefronts sur l'ensemble des quatre SIMD.
Selon la quantité de données à envoyer, l'émission d'une instruction VMEM prend un nombre variable de cycles d'horloge. C'est logique, car il peut y avoir jusqu'à 64 coordonnées UV, décalages, gradients et autres données différents par instruction. L'émission ne peut donc pas être instantanée.
Les opérandes de l'instruction VMEM sont répartis en trois flux et envoyés sur trois bus parallèles : Command, Address et Data. La vitesse d'émission de l'instruction est déterminée par le temps le plus long parmi ces trois bus. Le tableau suivant fournit quelques exemples du temps nécessaire pour émettre une instruction VMEM pour un wavefront, en fonction du nombre et de la taille des opérandes.
Dans l'onglet ALU de Dr.PIX, vous pouvez voir comment ces bus sont utilisés à l'exécution en consultant les statistiques « Time required to issue work on TA ADDR bus » et « Stalled due to full command FIFO »
| Opération | Command, cycles | Address, cycles | Data, cycles | Total, cycles |
| - | - | - | - | - |
| Lecture Image1D, descripteur 128 bits | 8 (4 texture + 4 échantillonneur) | 4, coordonnée 1D | 0, aucune donnée | 8 |
| Lecture Image2D, descripteur 256 bits | 12 (8 texture + 4 échantillonneur) | 8, coordonnée 2D | 0, aucune donnée | 12 |
| Lecture de tampon | 4 (tampon) | 4, coordonnée 1D | 0, aucune donnée | 4 |
| Écriture de tampon à canal unique | 4 (tampon) | 4, coordonnée 1D | 4, 1 DWORD | 4 |
| Écriture Image2D | 8 (texture) | 8, coordonnée 2D | 16, 4 DWORD | 16 |
Sur les charges de travail importantes, il n'est possible d'être limité par l'émission des instructions VMEM elle-même que si le temps d'émission dépasse 16 cycles d'horloge. Sinon, c'est généralement le TA qui constitue le goulot d'étranglement. Par exemple, SampleGrad() avec une texture 2D coûtera 24 cycles à émettre et sera environ deux fois plus coûteux qu'un Sample() classique (12 cycles d'horloge) si toutes les lectures atteignent le cache L1.
Dans le cas de SampleGrad(), nous pouvons voir dans Dr.PIX les signes révélateurs d'une limitation par l'émission.
```cpp theme={null}
Waiting to issue VMEM 80.91, %
```
```cpp theme={null}
VALU 259
Cost per inst 1, clks
VMEM_RD 16
Cost per inst 5.999, clks
```
D'après ces données, le shader est limité par l'émission VMEM. Le nombre de cycles nécessaires au traitement VMEM est de 384 (16 × 5,99 × 4), ce qui est supérieur au nombre de cycles nécessaires à VALU (259).
Une fois l'instruction VMEM émise, le wavefront peut continuer. L'instruction elle-même poursuit alors son exécution dans le bloc TA.
### Étape 2 : Calcul des adresses et demande des données
Le TA poursuit l'exécution de l'instruction VMEM en demandant les données au TCP et en informant le TD des données de retour à attendre et de la manière de les filtrer. Le TA peut demander jusqu'à 128 bits de données à partir de quatre emplacements par cycle. La vitesse de lecture maximale du TCP correspond à cette valeur. Cela permet un débit bilinéaire maximal de 2×2 pixels filtrés par cycle pour 32 bpp ou moins, ou un débit non filtré de 4 pixels par cycle jusqu'à 128 bpp.
**Figure 2. Présentation du processus de fetch de texture à filtrage bilinéaire. Ce processus est répété pour tous les quads du wavefront.**
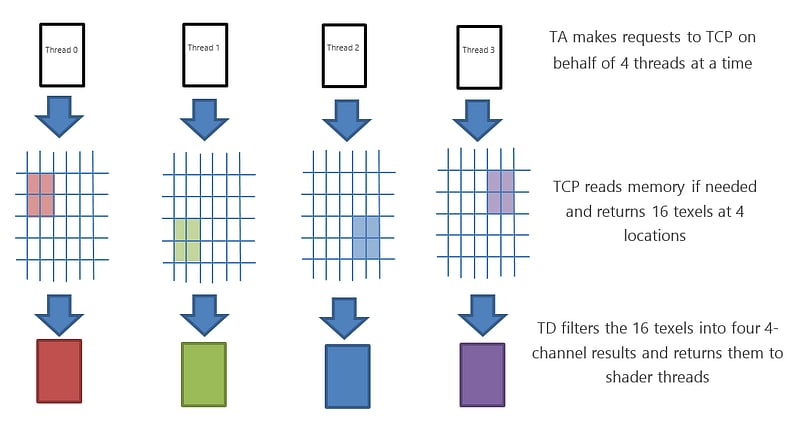 Une instruction VMEM peut déclencher plusieurs requêtes mémoire ; une instruction VMEM ne se retire donc du TA qu'une fois toutes ses requêtes envoyées. C'est ici, par exemple, qu'apparaît d'abord le coût supplémentaire du filtrage trilinéaire et anisotrope. Le TA doit demander au TCP tous les échantillons pour un texel demandé, et certains fetchs devront s'étaler sur de nombreux cycles d'horloge.
Le tableau suivant indique les vitesses maximales dans le TA. Il montre le temps nécessaire au TA pour envoyer des requêtes de données au TCP.
| Requête | Vitesse | Commentaire |
| - | - | - |
| Fetchs à échantillonnage ponctuel | 4 pixels/cycle (16 cycles/vague) | Tout format |
| Fetchs bilinéaires, ≤ 32 bpp | 4 pixels/cycle (16 cycles/vague) | ≤ 32 bits par pixel à pleine vitesse |
| Fetchs trilinéaires, ≤ 32 bpp | Bilinéaire / 2 | Le GPU tente d'optimiser en bilinéaire lorsque c'est possible. |
| Anisotrope Nx, ≤ 32 bpp | (Bilinéaire ou trilinéaire) / N | Le tri-juicing est également disponible.\* |
| Bilinéaire, trilinéaire, aniso 64 bpp | Débit 32 bpp / 2 | |
| Bilinéaire, trilinéaire, aniso 128 bpp | Débit 32 bpp / 4 | |
| Chargement de tampon à canal unique | 16 threads/cycle (4 cycles/vague) | Avec coalescence ; 4 threads/cycle sans coalescence. |
| Chargement de tampon multicanal | 4 threads/cycle (16 cycles/vague) | |
| Opérations atomiques sur tampon | 4 threads/cycle (16 cycles/vague) | |
Voici quelques coûts supplémentaires à payer pour les fonctionnalités suivantes (par quad 2×2).
* La couleur de bordure ajoute un ou deux cycles.
* Les gradients personnalisés ajoutent jusqu'à trois cycles.
* Les coins de cubemap peuvent ajouter jusqu'à cinq cycles.
* Les cas d'enroulement (wrap) sur des dimensions non puissances de 2 peuvent ajouter jusqu'à trois cycles.
Ce coût cumulé peut provoquer un goulot d'étranglement important à ce stade, car il peut théoriquement atteindre des milliers de cycles par wavefront. Le filtrage anisotrope est le principal exemple où ce coût peut dominer l'exécution du shader.
Pour détecter les goulots d'étranglement dus à l'anisotropie, utilisez ce compteur Dr. PIX : *Measured duration with anisotropic filtering turned off: 1715040 ns (54% faster)*
Si cette valeur est élevée, définissez PerfMip pour activer l'optimisation tri-juicing du filtrage trilinéaire ou trilinéaire anisotrope dans ce cas. Cela permettra de basculer vers un filtrage bilinéaire lorsque le LOD de texture est proche d'un entier.
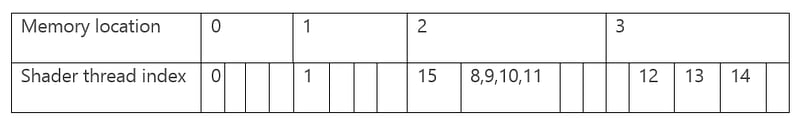
Le bloc TA effectue également la coalescence des requêtes de lecture, d'écriture et atomiques à canal unique sur les tampons. Lorsqu'un fetch de tampon à canal unique est utilisé avec des formats de 32 bpp ou moins, une grande partie de la bande passante TCP vers TD risque de rester inutilisée. Pour exploiter cette bande passante, le TA est conçu de sorte que, s'il détecte que les adresses demandées par des threads de shader consécutifs peuvent être lues dans la même requête de 128 bits, il fusionne les lectures et peut retourner jusqu'à 16 éléments par cycle pour les formats à canal unique 8, 16 et 32 bpp. Cela permet des lectures de tampon à canal unique plus rapides, mais uniquement si le TA peut fusionner les lectures de quatre blocs de quatre threads à la fois.
**Figure 3. Cas fusionnable. Les données de quatre blocs de quatre threads peuvent être lues à partir de quatre emplacements mémoire.**
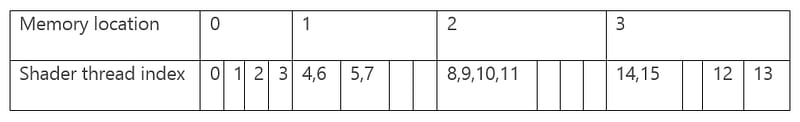 **Figure 4. Cas non fusionnable. Aucun des quatre emplacements ne peut être fusionné.**
 Le TA traite également l'instruction Gather4. Gather4 permet au TD de retourner des données non filtrées à canal unique pour chacun des 16 texels par cycle. La vitesse par DWORD est la même que celle d'une lecture de tampon fusionnée à canal unique. Prenons par exemple un Gather4 sur une texture R32. Il peut retourner 4 DWORD de données par thread en 16 cycles. Un fetch d'image classique à échantillonnage ponctuel retourne 1 DWORD de données par thread en 16 cycles, soit quatre fois moins de données par cycle. Un fetch à échantillonnage ponctuel pourrait lire une valeur 4×32 par thread si un format R32G32B32A32 était superposé (aliasing) à une texture R32, mais en général cela n'est pas possible en raison des modes de tiling différents entre les formats de texture 128 bpp et 32 bpp.
### Étape 3 : Le TCP charge les données et les transmet au TD
Le TCP est le cache « L1 ». Le TCP est propre à chaque CU ; il a une taille de 16 Ko et comporte quatre RAM entrelacées, chacune entièrement associative avec 64 étiquettes et une stratégie LRU. Le TCP stocke des octets de mémoire bruts. Il gère la lecture et l'écriture des données d'image et de tampon, la combinaison des écritures pour les requêtes d'écriture et atomiques, la combinaison des lectures pour les requêtes de lecture, le tiling mémoire et la décompression des formats par blocs à la lecture, ainsi que les textures partiellement résidentes. Le rôle du TCP est de masquer la latence du TCC, et non d'y stocker des données pendant longtemps.
Au débit maximal, le TA peut demander quatre adresses uniques par cycle, et le TCP peut retourner au TD jusqu'à 128 bits de données de chaque adresse par cycle. Il est garanti que le TCP peut envoyer au TD n'importe quel texel d'image 2×2 en 1 cycle.
Les performances réelles dépendent de la taille de la requête et de la dispersion en mémoire. Pour chaque échec d'accès au cache L1, une requête est transmise au cache L2, ce qui affecte considérablement les performances. Un échec d'accès au cache L1 peut coûter plus de 50 cycles d'horloge, et un échec d'accès au cache L2 coûtera plus de 200 cycles d'horloge vers la DRAM et plus de 75 cycles vers l'ESRAM.
Ces valeurs sont mesurées, mais optimistes. Pour voir les latences réelles, utilisez l'onglet ALU de Dr. PIX ou les différents compteurs de colonnes disponibles.
Une optimisation très importante consiste à utiliser les modes de tiling appropriés pour les textures et les tampons, en fonction du modèle d'accès. Les pixel shaders sont toujours traités par quads 2×2 ; les modes de tiling 2D sont donc très importants pour la vitesse du fetch de textures, car les texels voisins sont stockés à proximité en mémoire par rapport à la ligne de cache, ce qui réduit le nombre d'échecs d'accès au cache. L'utilisation d'une texture linéaire avec un pixel shader peut être jusqu'à 50 % plus lente que la lecture d'une texture en tiling. Les compute shaders qui utilisent des textures en entrée ou en sortie offrent les meilleures performances lorsque la taille du groupe de threads est un multiple de la ligne de cache, par exemple un multiple de 8×2 pour les formats 32 bpp. Lorsque des tampons sont utilisés, l'accès linéaire offre une vitesse maximale, et le matériel prend en charge les modes d'adressage AOS/SOA pour les tampons afin de réduire les échecs d'accès au cache lors de l'accès aux tampons. En décembre 2013, la XBOX One n'expose pas le paramètre de swizzling AOS/SOA pour les tampons.
Le tableau suivant présente la répartition des performances dans ce module :
| Opération | ≤ 32 bpp | 64 bpp | 128 bpp | Commentaire |
| - | - | - | - | - |
| Lectures d'image bilinéaires | 16 texels/cycle | 8 texels/cycle | 4 texels/cycle | 4 pixels/adresses \* quads 2×2 |
| Lectures et écritures à échantillonnage ponctuel | 4 texels/cycle | 4 texels/cycle | 4 texels/cycle | 4 adresses, tout format |
| Gather4 | 16 texels/cycle | 16 texels/cycle | 16 texels/cycle | 4 pixels/adresses \* 2×2, n'importe quel composant unique |
| Lectures et écritures de tampon | 16 éléments/cycle | N/A | N/A | 4 adresses \* 1x4 ≤ 32 bpp. La lecture/l'écriture de 2 ou 4 éléments réduit le débit à 4 éléments/cycle |
| Opérations atomiques sur tampon | 16 opérations atomiques/cycle | 8 opérations atomiques/cycle | N/A | Les opérations atomiques Cmpswap/avec retour réduisent le débit de moitié |
| Opérations atomiques sur image | 4 opérations atomiques/cycle | 4 opérations atomiques/cycle | N/A | Les opérations atomiques Cmpswap/avec retour réduisent le débit de moitié |
Concernant les lectures et écritures de tampon ci-dessus : les chargements et stockages à 4 canaux ont le même débit que les chargements et stockages fusionnés à 1 canal. En effet, 1 DWORD par thread de shader en 4 cycles représente la même quantité de données par cycle que 4 DWORD par thread de shader en 16 cycles.
Dr. PIX fournit une analyse approfondie des performances du TCP et du TCC dans la section Caches.
### Étape 4 : Le TD retourne les données au SP
Une fois que le TCP dispose des données, celles-ci sont transmises au bloc TD afin d'être retournées au shader. Le TD effectue le filtrage et la conversion de format, y compris la suppression du gamma (de-gamma). Le filtrage est ignoré pour les formats entiers (par exemple, R32\_UINT) et les fetchs de tampon.
Dans la plupart des cas, le TD peut filtrer quatre pixels à quatre canaux par cycle et retourner jusqu'à 16 DWORD par cycle au shader. En général, l'un ou l'autre de ces aspects constitue un goulot d'étranglement dans ce bloc, et il est possible de déterminer lequel en fonction du type de fetch ou du format. Plutôt que de présenter un grand tableau de formats et de vitesses, un programmeur graphique expérimenté n'a besoin de retenir que les points suivants :
* Le TD dispose de quatre filtres à virgule fixe de 12 bits, qu'il peut chaîner pour prendre en charge la mantisse de 23 bits du FP32 ou la valeur 16 bits d'un U16.
* Le TD dispose de trois canaux de 9 bits qui traitent l'exposant à virgule flottante.
* Le filtrage trilinéaire/anisotrope réduit le débit, car les échantillons doivent être mélangés.
Pour appliquer ces règles, partez du plein débit. Si la mantisse FP ou la valeur entière nécessite plus de 12 bits, réduisez le débit de moitié. S'il y a plus de trois canaux à virgule flottante, réduisez à nouveau le débit de moitié. Pour le filtrage trilinéaire, réduisez encore le débit de moitié. Pour l'anisotropie avec un facteur N, divisez encore le débit par N. Vous obtenez ainsi le diviseur de débit dans le TD.
Voici quelques exemples d'application de ces règles à de simples fetchs bilinéaires :
* Les formats à virgule fixe de 8, 10 ou 11 bits par canal passent à plein débit, en utilisant une voie de filtre de 12 bits par canal.
* Les formats à virgule fixe de 16 bits doivent utiliser deux voies de 12 bits par canal ; ainsi, s'il y a quatre canaux de 16 bits, le filtrage s'effectue à mi-débit. S'il y a deux canaux de 16 bits, il s'effectue à plein débit.
* Le format FP32 à canal unique est à pleine vitesse. FP32x2 est à mi-vitesse et FP32x4 à quart de vitesse. Ce ralentissement s'explique par le fait qu'un canal FP32 occupe deux voies de 12 bits.
* Le FP16 à canal unique est à pleine vitesse, tout comme FP16x2, mais FP16x4 est à mi-vitesse, car seuls trois canaux à virgule flottante peuvent être filtrés simultanément.
* R11G11B10\_FLOAT est à pleine vitesse, car la mantisse est inférieure à 12 bits et trois canaux à virgule flottante doivent être filtrés.
Si vous utilisez .x ou .xyz en HLSL sur une texture FP16x4, le débit reste de moitié, car le GPU filtre tous les canaux de la texture source avant de déterminer quels canaux retourner au shader.
## Opérations atomiques
Les opérations atomiques sont des opérations mémoire qui effectuent une lecture-modification-écriture sur la destination en une seule transaction ininterrompue. Le GPU XBOX One dispose de trois types distincts d'opérations atomiques : les opérations atomiques LDS, les opérations atomiques GDS et les opérations atomiques mémoire. Seules les opérations atomiques mémoire sont abordées dans cette rubrique.
Un shader peut demander une valeur de retour à une instruction atomique ; on parle alors d'*opérations atomiques avec retour*, ou simplement d'*opérations atomiques à retour*. Les instructions qui ne demandent pas de valeur de retour sont appelées *opérations atomiques sans retour*.
La prise en charge matérielle des opérations atomiques est un sur-ensemble des opérations atomiques HLSL. Le type de données des opérations atomiques est constitué d'entiers 32 et 64 bits, signés ou non signés. Les opérations atomiques CMPSWAP, MIN et MAX sont également prises en charge sur les valeurs à virgule flottante 32 et 64 bits. Les opérations atomiques 64 bits ne sont prises en charge qu'avec les instructions de tampon ; sinon, la prise en charge des opérations atomiques sur image et sur tampon est symétrique. Chaque instruction atomique peut être avec retour, signalée par l'indicateur GLC=1 dans l'assembleur de shader, ou sans retour. HLSL DX11 n'expose qu'un sous-ensemble des opérations atomiques disponibles dans le matériel ; il manque notamment la prise en charge des opérations atomiques sur entiers 64 bits pour les tampons.
L'absence de prise en charge des opérations atomiques MIN et MAX pour les valeurs à virgule flottante dans HLSL peut être contournée pour les valeurs à virgule flottante positives en utilisant les opérations atomiques MIN/MAX classiques sur entiers signés avec des valeurs asint(fp32). En effet, les valeurs à virgule flottante IEE754 de même signe sont ordonnées. L'opération atomique CMPSWAP devrait également fonctionner sur des valeurs asint(fp32).
Le TCP (cache L1) a connaissance des opérations atomiques, mais n'effectue pas lui-même les opérations atomiques réelles. Il les combine d'abord en écriture, puis les transmet au TCC (cache L2) pour exécution.
Le TCC (cache L2) est propre à chaque GPU ; il s'agit d'un cache à réécriture (writeback) de 512 Ko, associatif à 16 voies, avec 12 blocs de 8 Ko par banque et quatre banques. Voici les performances maximales du TCC :
* 4 lectures par cycle
* 3 écritures par cycle
* 3 opérations atomiques sans retour par cycle
* 1 opération atomique avec retour par cycle
En pratique, sur le GPU XBOX One, les opérations atomiques avec retour atteignent toujours environ deux tiers de la vitesse des opérations atomiques sans retour, et les opérations atomiques sans contention sont aussi rapides que les écritures classiques. En cas de forte contention sur les adresses de destination des opérations atomiques, la vitesse peut chuter à 1/20 - 1/6 de la vitesse d'écriture.
## Annexe A : Vitesses de fetch de texture
Ces valeurs théoriques correspondent raisonnablement aux valeurs mesurées pour différents fetchs de texture.
| Filtre | Format | Pic théorique, nombre de fetchs par cycle sur l'ensemble du GPU | Latence dans le shader, cycles (en supposant un coût complet, c.-à-d. sans optimisations anisotropes) |
| - | - | - | - |
| Ponctuel | BC1\_UNORM | 48 | 16 |
| Bilinéaire | BC1\_UNORM | 48 | 16 |
| Trilinéaire | BC1\_UNORM | 24 | 32 |
| Aniso 2x | BC1\_UNORM | 12 | 64 |
| Aniso 4x | BC1\_UNORM | 6 | 128 |
| Ponctuel | R8\_UNORM | 48 | 16 |
| Bilinéaire | R8\_UNORM | 48 | 16 |
| Trilinéaire | R8\_UNORM | 24 | 32 |
| Aniso 2x | R8\_UNORM | 12 | 64 |
| Aniso 4x | R8\_UNORM | 6 | 128 |
| Ponctuel | R8G8\_UNORM | 48 | 16 |
| Bilinéaire | R8G8\_UNORM | 48 | 16 |
| Trilinéaire | R8G8\_UNORM | 24 | 32 |
| Aniso 2x | R8G8\_UNORM | 12 | 64 |
| Aniso 4x | R8G8\_UNORM | 6 | 128 |
| Ponctuel | R8G8B8A8\_UNORM | 48 | 16 |
| Bilinéaire | R8G8B8A8\_UNORM | 48 | 16 |
| Trilinéaire | R8G8B8A8\_UNORM | 24 | 32 |
| Aniso 2x | R8G8B8A8\_UNORM | 12 | 64 |
| Aniso 4x | R8G8B8A8\_UNORM | 6 | 128 |
| Ponctuel | R8G8B8A8\_UNORM\_SRGB | 48 | 16 |
| Bilinéaire | R8G8B8A8\_UNORM\_SRGB | 48 | 16 |
| Trilinéaire | R8G8B8A8\_UNORM\_SRGB | 24 | 32 |
| Aniso 2x | R8G8B8A8\_UNORM\_SRGB | 12 | 64 |
| Aniso 4x | R8G8B8A8\_UNORM\_SRGB | 6 | 128 |
| Ponctuel | R10G10B10A2\_UNORM | 48 | 16 |
| Bilinéaire | R10G10B10A2\_UNORM | 48 | 16 |
| Trilinéaire | R10G10B10A2\_UNORM | 24 | 32 |
| Aniso 2x | R10G10B10A2\_UNORM | 12 | 64 |
| Aniso 4x | R10G10B10A2\_UNORM | 6 | 128 |
| Ponctuel | R10G10B10\_6E4\_A2\_FLOAT | 48 | 16 |
| Bilinéaire | R10G10B10\_6E4\_A2\_FLOAT | 48 | 16 |
| Trilinéaire | R10G10B10\_6E4\_A2\_FLOAT | 24 | 32 |
| Aniso 2x | R10G10B10\_6E4\_A2\_FLOAT | 12 | 64 |
| Aniso 4x | R10G10B10\_6E4\_A2\_FLOAT | 6 | 128 |
| Ponctuel | R10G10B10\_7E3\_A2\_FLOAT | 48 | 16 |
| Bilinéaire | R10G10B10\_7E3\_A2\_FLOAT | 48 | 16 |
| Trilinéaire | R10G10B10\_7E3\_A2\_FLOAT | 24 | 32 |
| Aniso 2x | R10G10B10\_7E3\_A2\_FLOAT | 12 | 64 |
| Aniso 4x | R10G10B10\_7E3\_A2\_FLOAT | 6 | 128 |
| Ponctuel | R11G11B10\_FLOAT | 48 | 16 |
| Bilinéaire | R11G11B10\_FLOAT | 48 | 16 |
| Trilinéaire | R11G11B10\_FLOAT | 24 | 32 |
| Aniso 2x | R11G11B10\_FLOAT | 12 | 64 |
| Aniso 4x | R11G11B10\_FLOAT | 6 | 128 |
| Ponctuel | R16G16\_UNORM | 48 | 16 |
| Bilinéaire | R16G16\_UNORM | 48 | 16 |
| Trilinéaire | R16G16\_UNORM | 24 | 32 |
| Aniso 2x | R16G16\_UNORM | 12 | 64 |
| Aniso 4x | R16G16\_UNORM | 6 | 128 |
| Ponctuel | R16G16\_FLOAT | 48 | 16 |
| Bilinéaire | R16G16\_FLOAT | 48 | 16 |
| Trilinéaire | R16G16\_FLOAT | 24 | 32 |
| Aniso 2x | R16G16\_FLOAT | 12 | 64 |
| Aniso 4x | R16G16\_FLOAT | 6 | 128 |
| Ponctuel | R32\_UINT | 48 | 16 |
| Ponctuel | R32\_FLOAT | 48 | 16 |
| Bilinéaire | R32\_FLOAT | 48 | 16 |
| Trilinéaire | R32\_FLOAT | 24 | 32 |
| Aniso 2x | R32\_FLOAT | 12 | 64 |
| Aniso 4x | R32\_FLOAT | 6 | 128 |
| Ponctuel | R16G16B16A16\_UNORM | 48 | 16 |
| Bilinéaire | R16G16B16A16\_UNORM | 24 | 32 |
| Trilinéaire | R16G16B16A16\_UNORM | 12 | 64 |
| Aniso 2x | R16G16B16A16\_UNORM | 6 | 128 |
| Aniso 4x | R16G16B16A16\_UNORM | 3 | 256 |
| Ponctuel | R16G16B16A16\_FLOAT | 48 | 16 |
| Bilinéaire | R16G16B16A16\_FLOAT | 24 | 32 |
| Trilinéaire | R16G16B16A16\_FLOAT | 12 | 64 |
| Aniso 2x | R16G16B16A16\_FLOAT | 6 | 128 |
| Aniso 4x | R16G16B16A16\_FLOAT | 3 | 256 |
| Ponctuel | R32G32\_UINT | 48 | 16 |
| Ponctuel | R32G32\_FLOAT | 48 | 16 |
| Bilinéaire | R32G32\_FLOAT | 24 | 32 |
| Trilinéaire | R32G32\_FLOAT | 12 | 64 |
| Aniso 2x | R32G32\_FLOAT | 6 | 128 |
| Aniso 4x | R32G32\_FLOAT | 3 | 256 |
| Ponctuel | R32G32B32A32\_UINT | 48 | 16 |
| Ponctuel | R32G32B32A32\_FLOAT | 48 | 16 |
| Bilinéaire | R32G32B32A32\_FLOAT | 12 | 64 |
| Trilinéaire | R32G32B32A32\_FLOAT | 6 | 128 |
| Aniso 2x | R32G32B32A32\_FLOAT | 3 | 256 |
| Aniso 4x | R32G32B32A32\_FLOAT | 1.5 | 512 |
## Annexe B : Vue d'ensemble d'un shader utilisant une instruction d'image
L'exemple suivant montre une instruction de mémoire vectorielle dans un binaire de shader :
```cpp theme={null}
s_mov_b64 s[12:13], exec
s_wqm_b64 exec, exec
s_mov_b32 m0, s4
s_load_dwordx8 s[4:11], s[2:3], 0x00
s_load_dwordx4 s[0:3], s[2:3], 0x08
v_interp_p1_f32 v2, v0, attr1.x
v_interp_p1_f32 v3, v0, attr1.y
v_interp_p2_f32 v2, v1, attr1.x
v_interp_p2_f32 v3, v1, attr1.y
s_waitcnt lgkmcnt(0)
image_sample v[2:5], v[2:5], s[4:11], s[0:3] dmask:0xf
```
Voici une explication plus détaillée, ligne par ligne.
```cpp theme={null}
s_mov_b64 s[12:13], exec
```
Exec est un registre architectural de 64 bits qui stocke le masque de bits d'exécution du wavefront actuel. Si un bit vaut 1 dans ce masque, les résultats d'exécution du thread sont enregistrés ; s'il vaut 0, ils sont ignorés. Les quads de moins de 4 pixels entraînent des 0 dans le masque pour certains threads dans les pixel shaders, de même que les wavefronts de moins de 64 sommets dans les vertex shaders. Ici, nous enregistrons le masque dans les SGPR 12 et 13.
```cpp theme={null}
s_wqm_b64 exec, exec
```
Nous définissons le masque exec pour activer le mode quads entiers (whole quads mode). Il active tous les threads de tous les quads, et tous les threads de tous les quads seront désormais exécutés. Le compilateur doit le faire, car nous sommes sur le point d'effectuer une lecture de texture basée sur des gradients, qui nécessite les valeurs de tous les threads d'un quad 2×2.
```cpp theme={null}
s_mov_b32 m0, s4
```
Nous sommes sur le point de lire des valeurs interpolées depuis le LDS ; nous devons donc configurer un registre de descripteur mémoire. Le GPU lui-même précharge le SGPR 4 avec les paramètres LDS appropriés pour ce wavefront de pixel shader.
```cpp theme={null}
s_load_dwordx8 s[4:11], s[2:3], 0x00
s_load_dwordx4 s[0:3], s[2:3], 0x08
s_waitcnt lgkmcnt(0)
```
Les instructions de mémoire vectorielle doivent avoir au moins un paramètre décrivant la texture ou un tampon. Dans le cas des instructions d'image, un descripteur d'échantillonneur est également requis. Ces instructions de chargement scalaire chargent un objet Texture Descriptor de 4 DWORD dans les SGPR 0, 1, 2, 3 et un objet Sampler Descriptor de 8 DWORD dans les SGPR 4, 5, 6, 7, 8, 9, 10 et 11. Le pilote graphique XBOX One transmet l'adresse du bloc mémoire stockant les descripteurs de shader dans les SGPR 2 et 3.
```cpp theme={null}
v_interp_p1_f32 v2, v0, attr1.x
v_interp_p1_f32 v3, v0, attr1.y
v_interp_p2_f32 v2, v1, attr1.x
v_interp_p2_f32 v3, v1, attr1.y
```
Ces quatre instructions interpolent les coordonnées UV de la texture que nous sommes sur le point de lire. Chaque interpolant linéaire nécessite deux instructions. Alors que les descripteurs d'objets sont partagés entre tous les threads du wavefront et sont donc stockés dans des SGPR, les coordonnées UV, ou les décalages de texture ou de tampon, sont propres à chaque thread de shader ; ils doivent donc utiliser des VGPR.
```cpp theme={null}
image_sample v[2:5], v[2:5], s[4:11], s[0:3] dmask:0xf
```
Cette instruction émet une lecture de texture avec les coordonnées UV dans `v[2:3]` (les `v[4:5]` sont inutilisés mais requis ici), l'objet descripteur de texture dans `s[0:3]` et un objet descripteur d'échantillonneur dans `s[4:11]`.
## Références
[Vue d'ensemble du GPU XBOX One](/fr/build/core-features/graphics/whitepapers/xbox-one-gpu-overview) [Unités de calcul du GPU XBOX One](/fr/build/core-features/graphics/whitepapers/xbox-one-gpu-compute-units)
## Related topics
- [Répertoire des rubriques NDA : liens actifs vers Microsoft Learn](/fr/nda/nda-topic-directory.md)
- [Étapes du test de validation des supports](/fr/publishing/game-publishing/concepts/certification/certification-media-validation-test-steps.md)
- [Étapes de test de validation des supports](/fr-CA/publishing/game-publishing/concepts/certification/certification-media-validation-test-steps.md)
- [Guide BVT de certification pour PC](/fr/publishing/game-publishing/concepts/certification/certification-pc-bvt-guide.md)
- [Guide des BVT de certification pour PC](/fr-CA/publishing/game-publishing/concepts/certification/certification-pc-bvt-guide.md)